Resumo
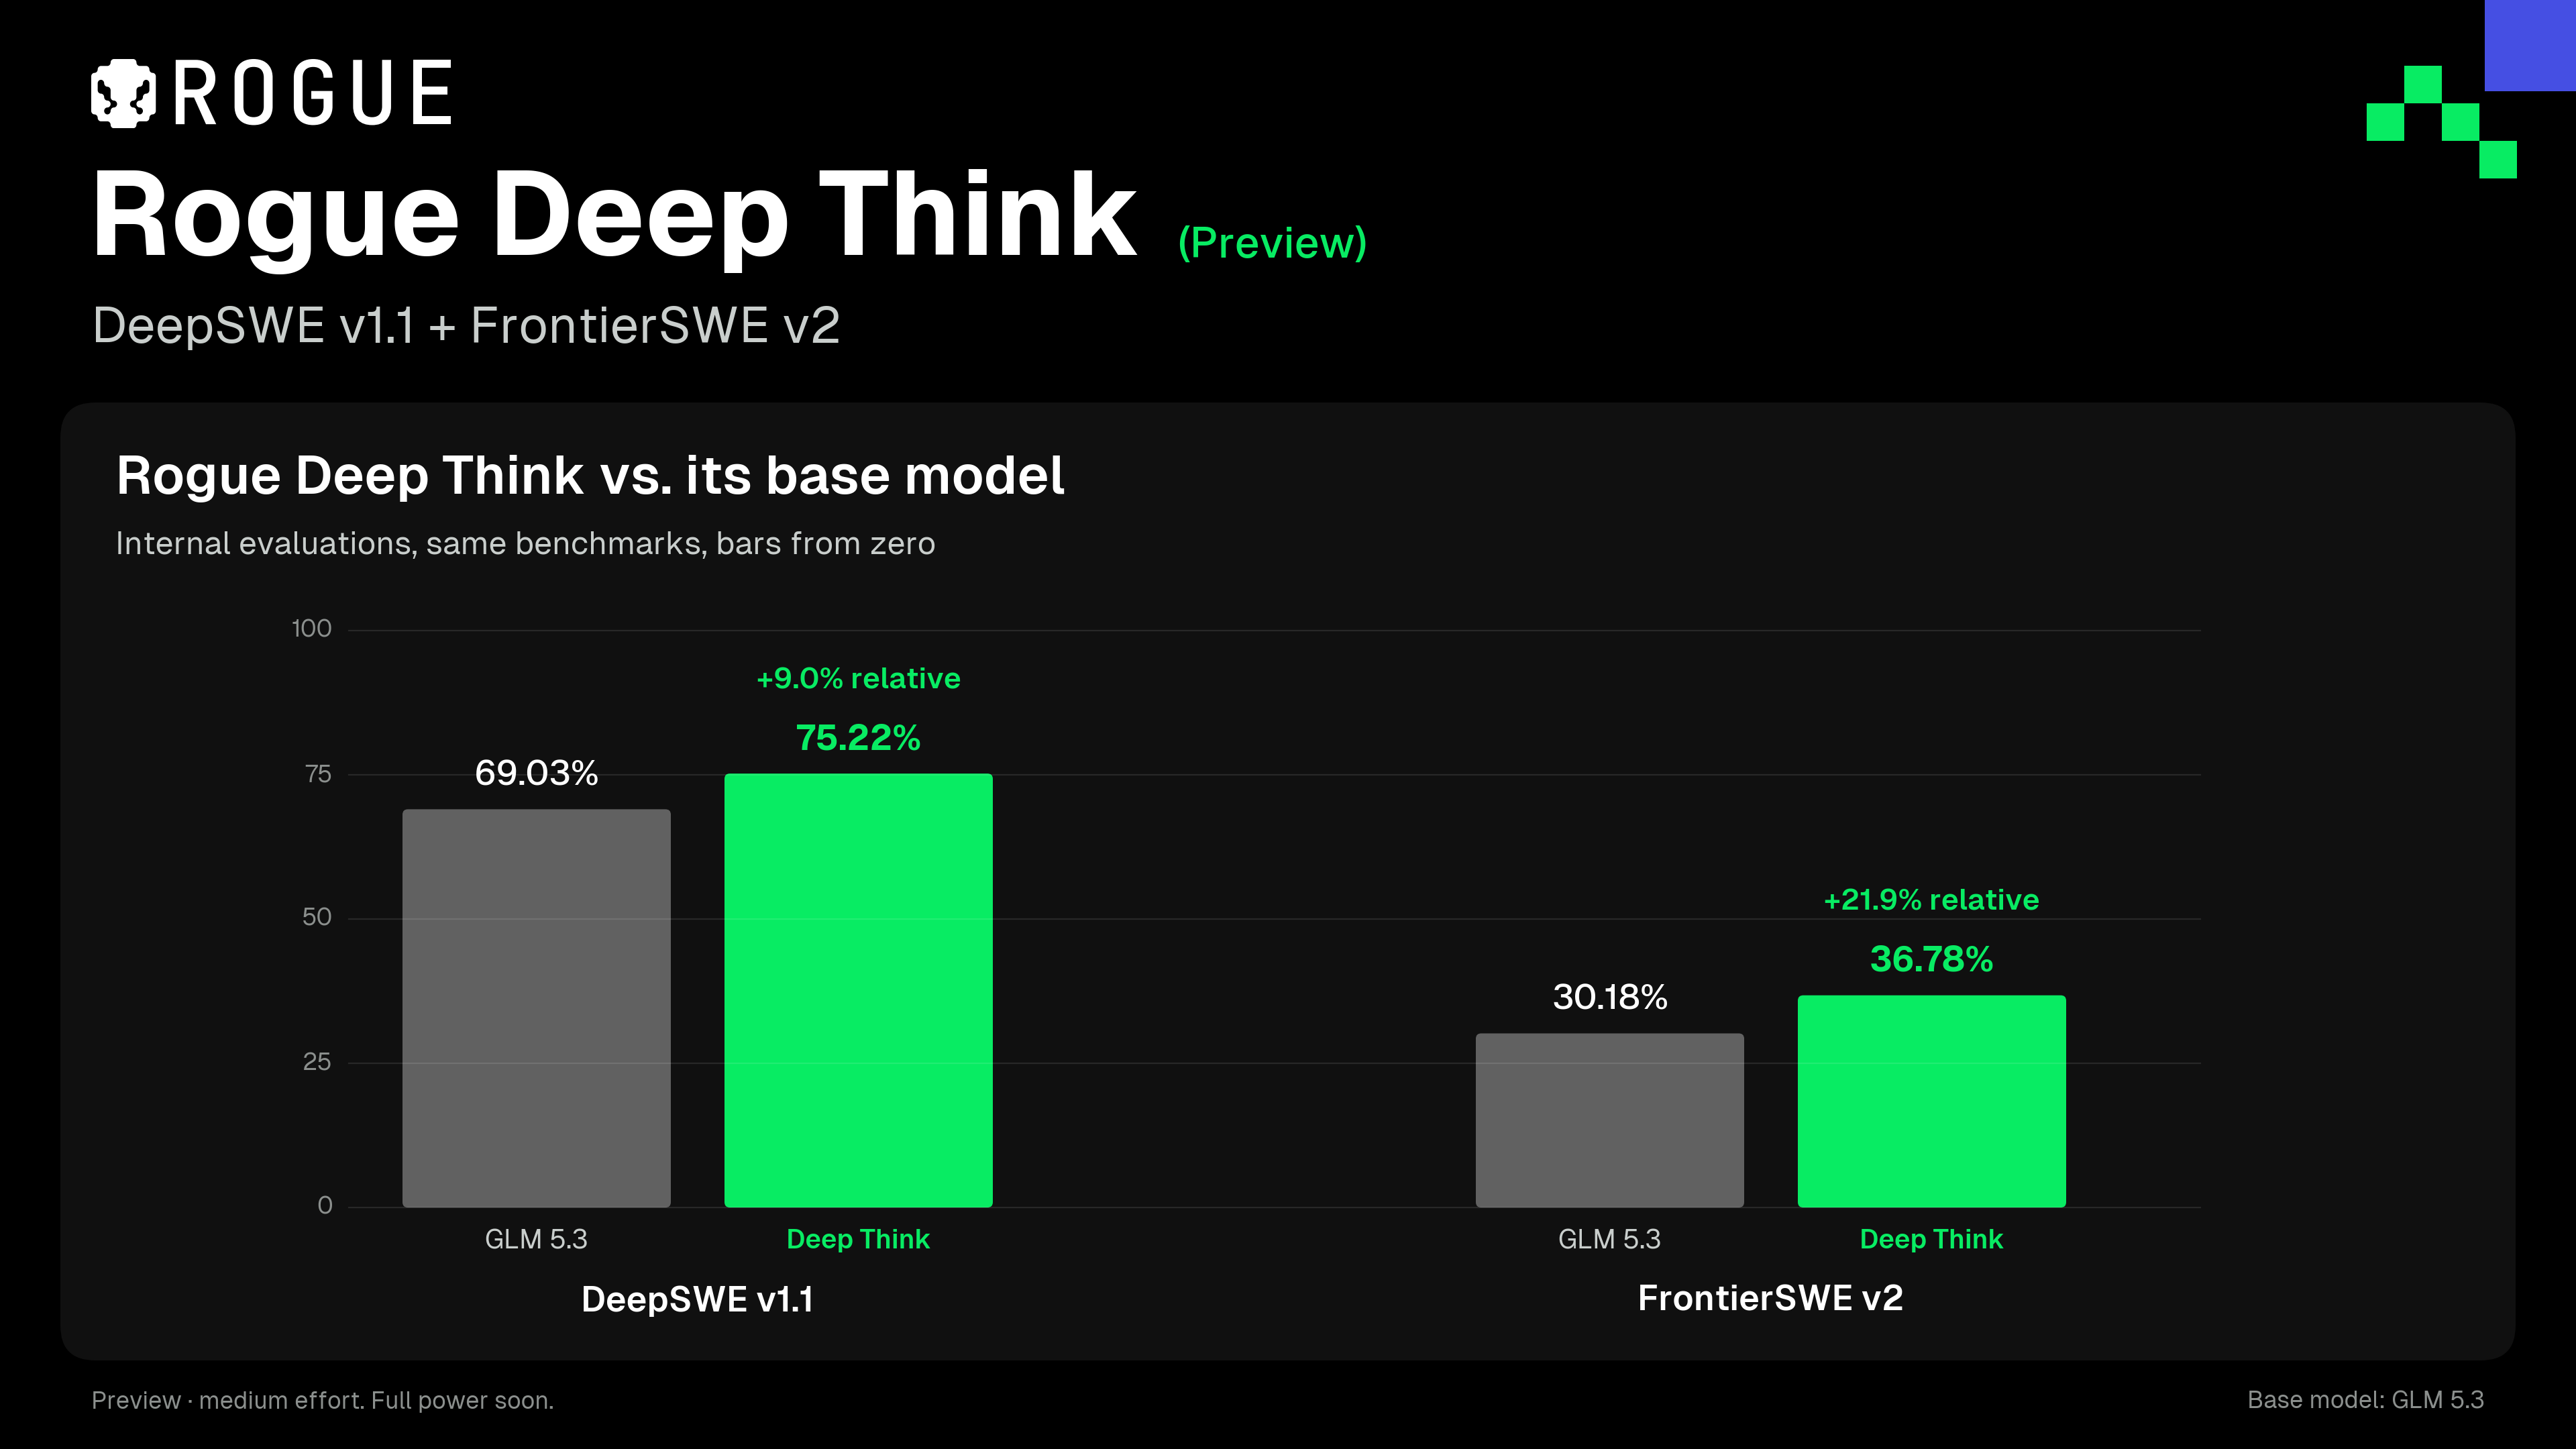
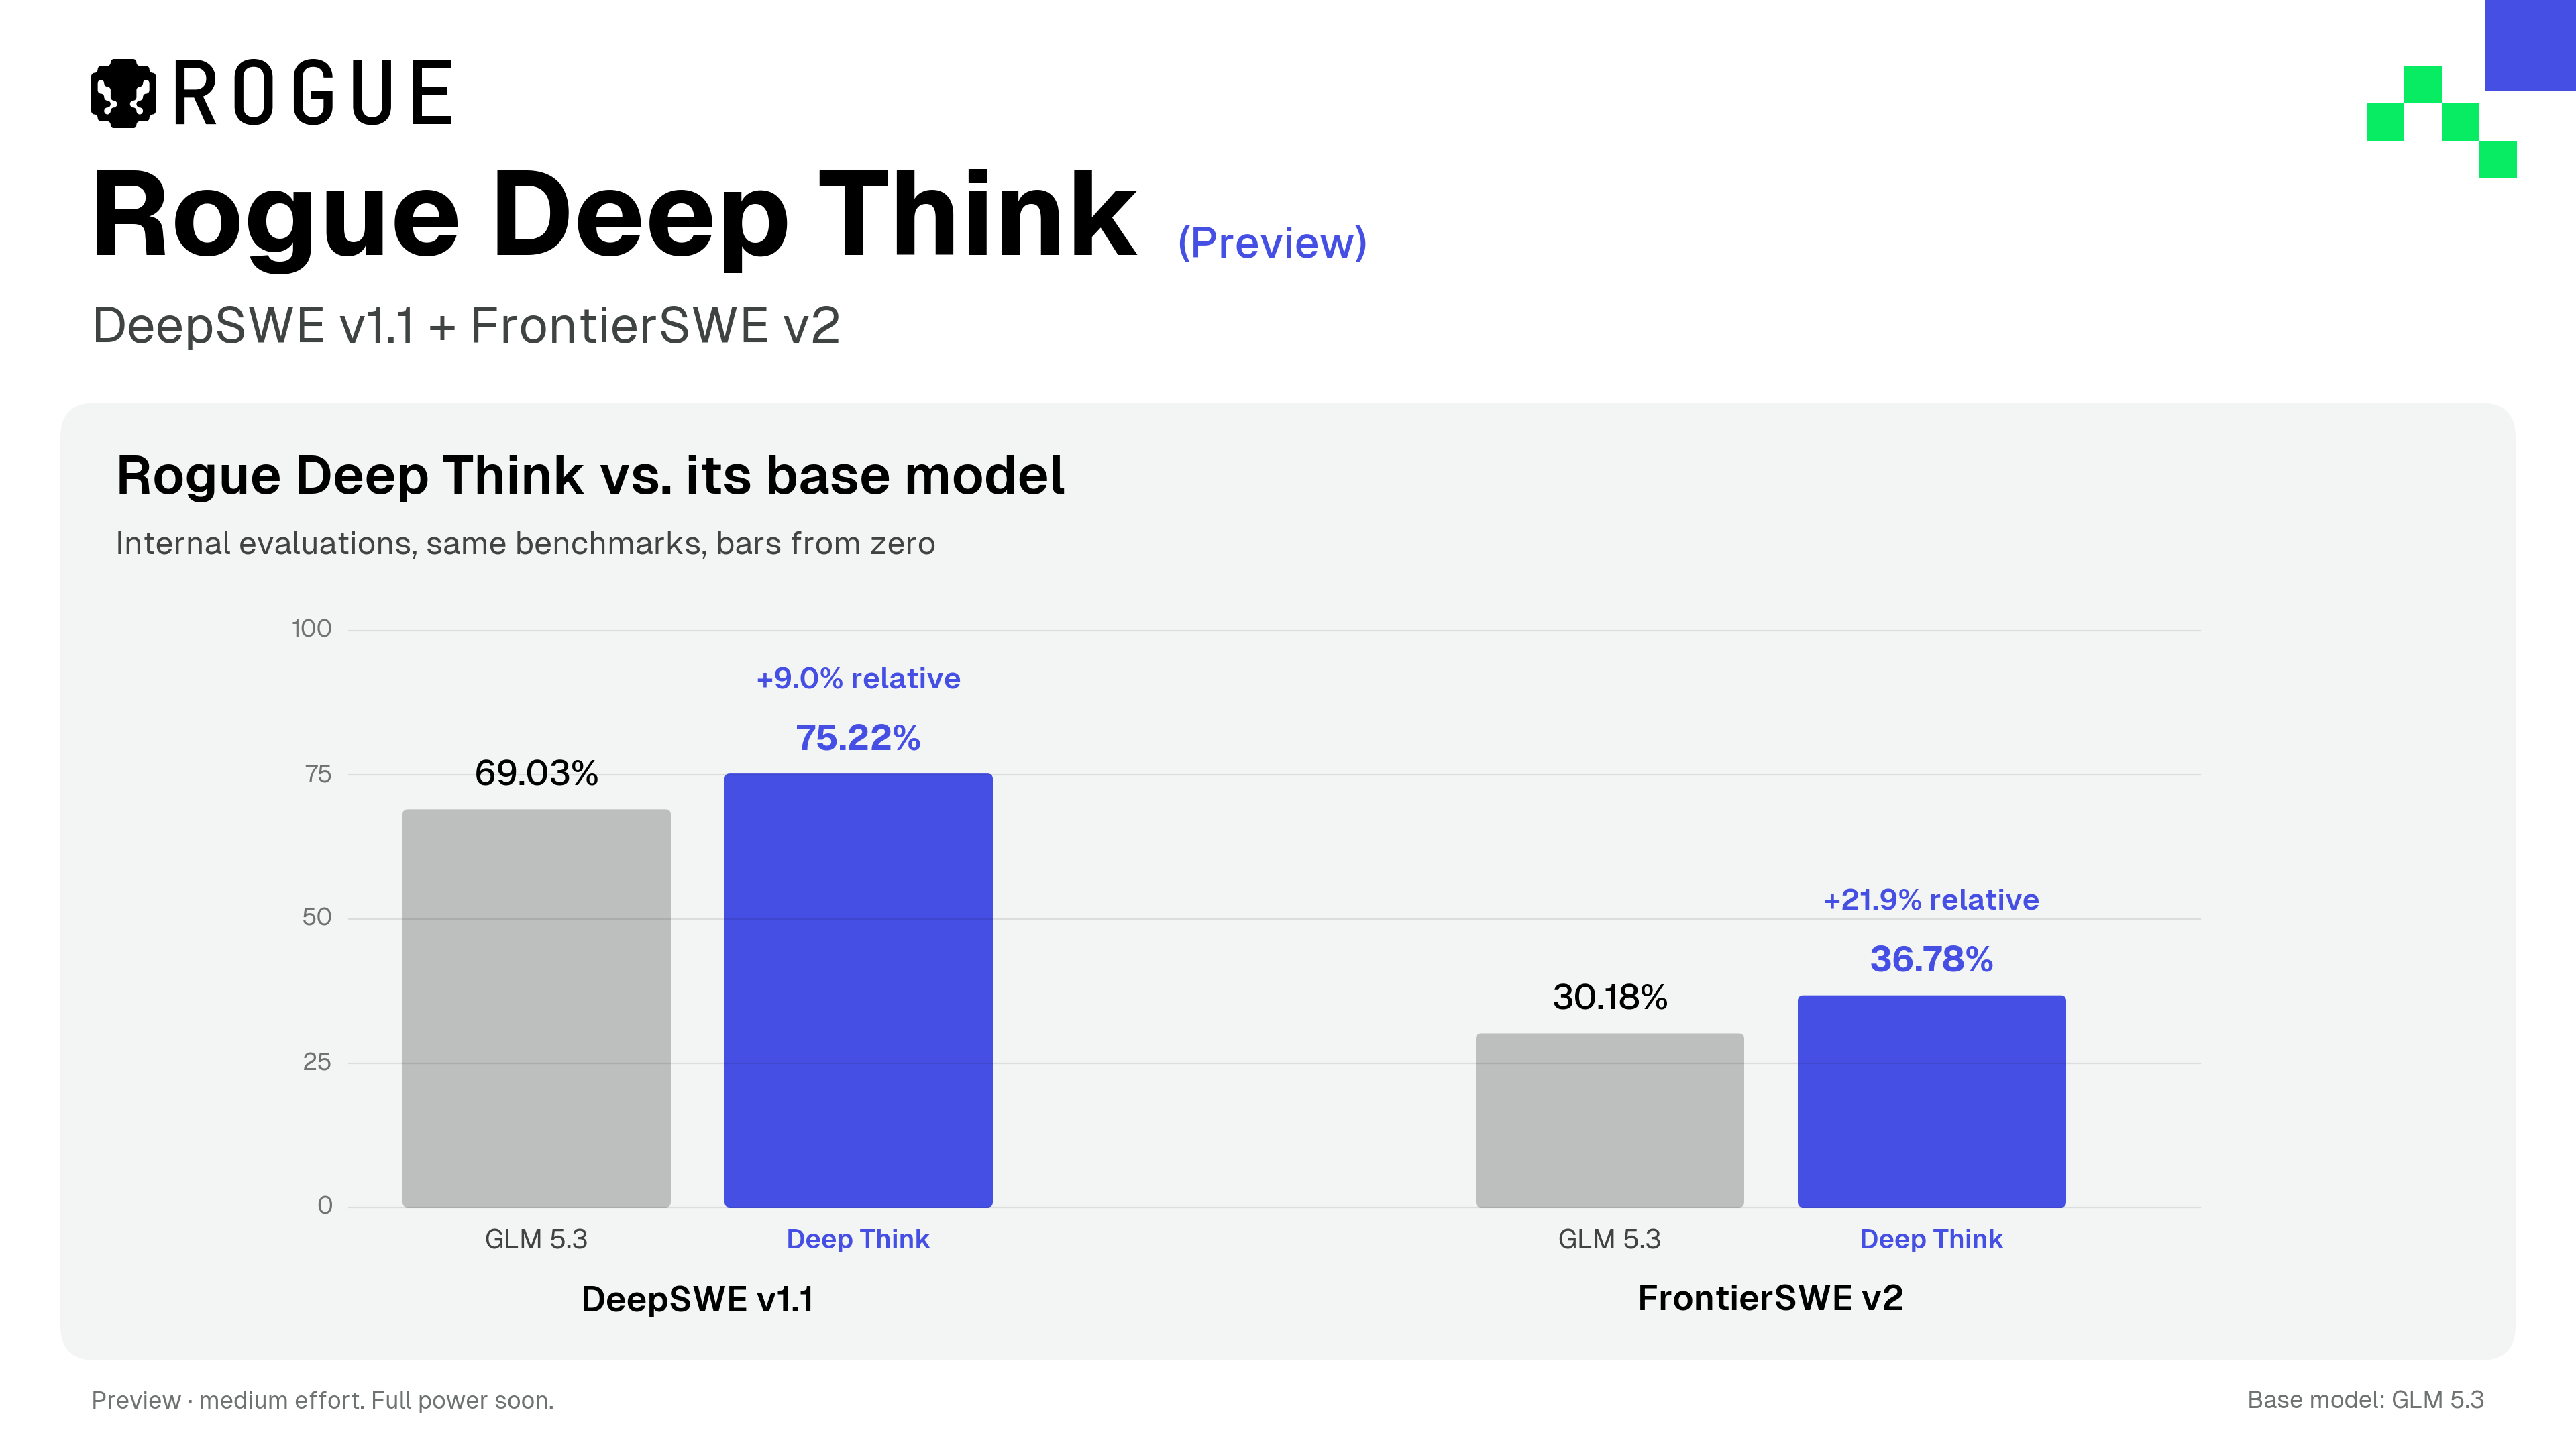
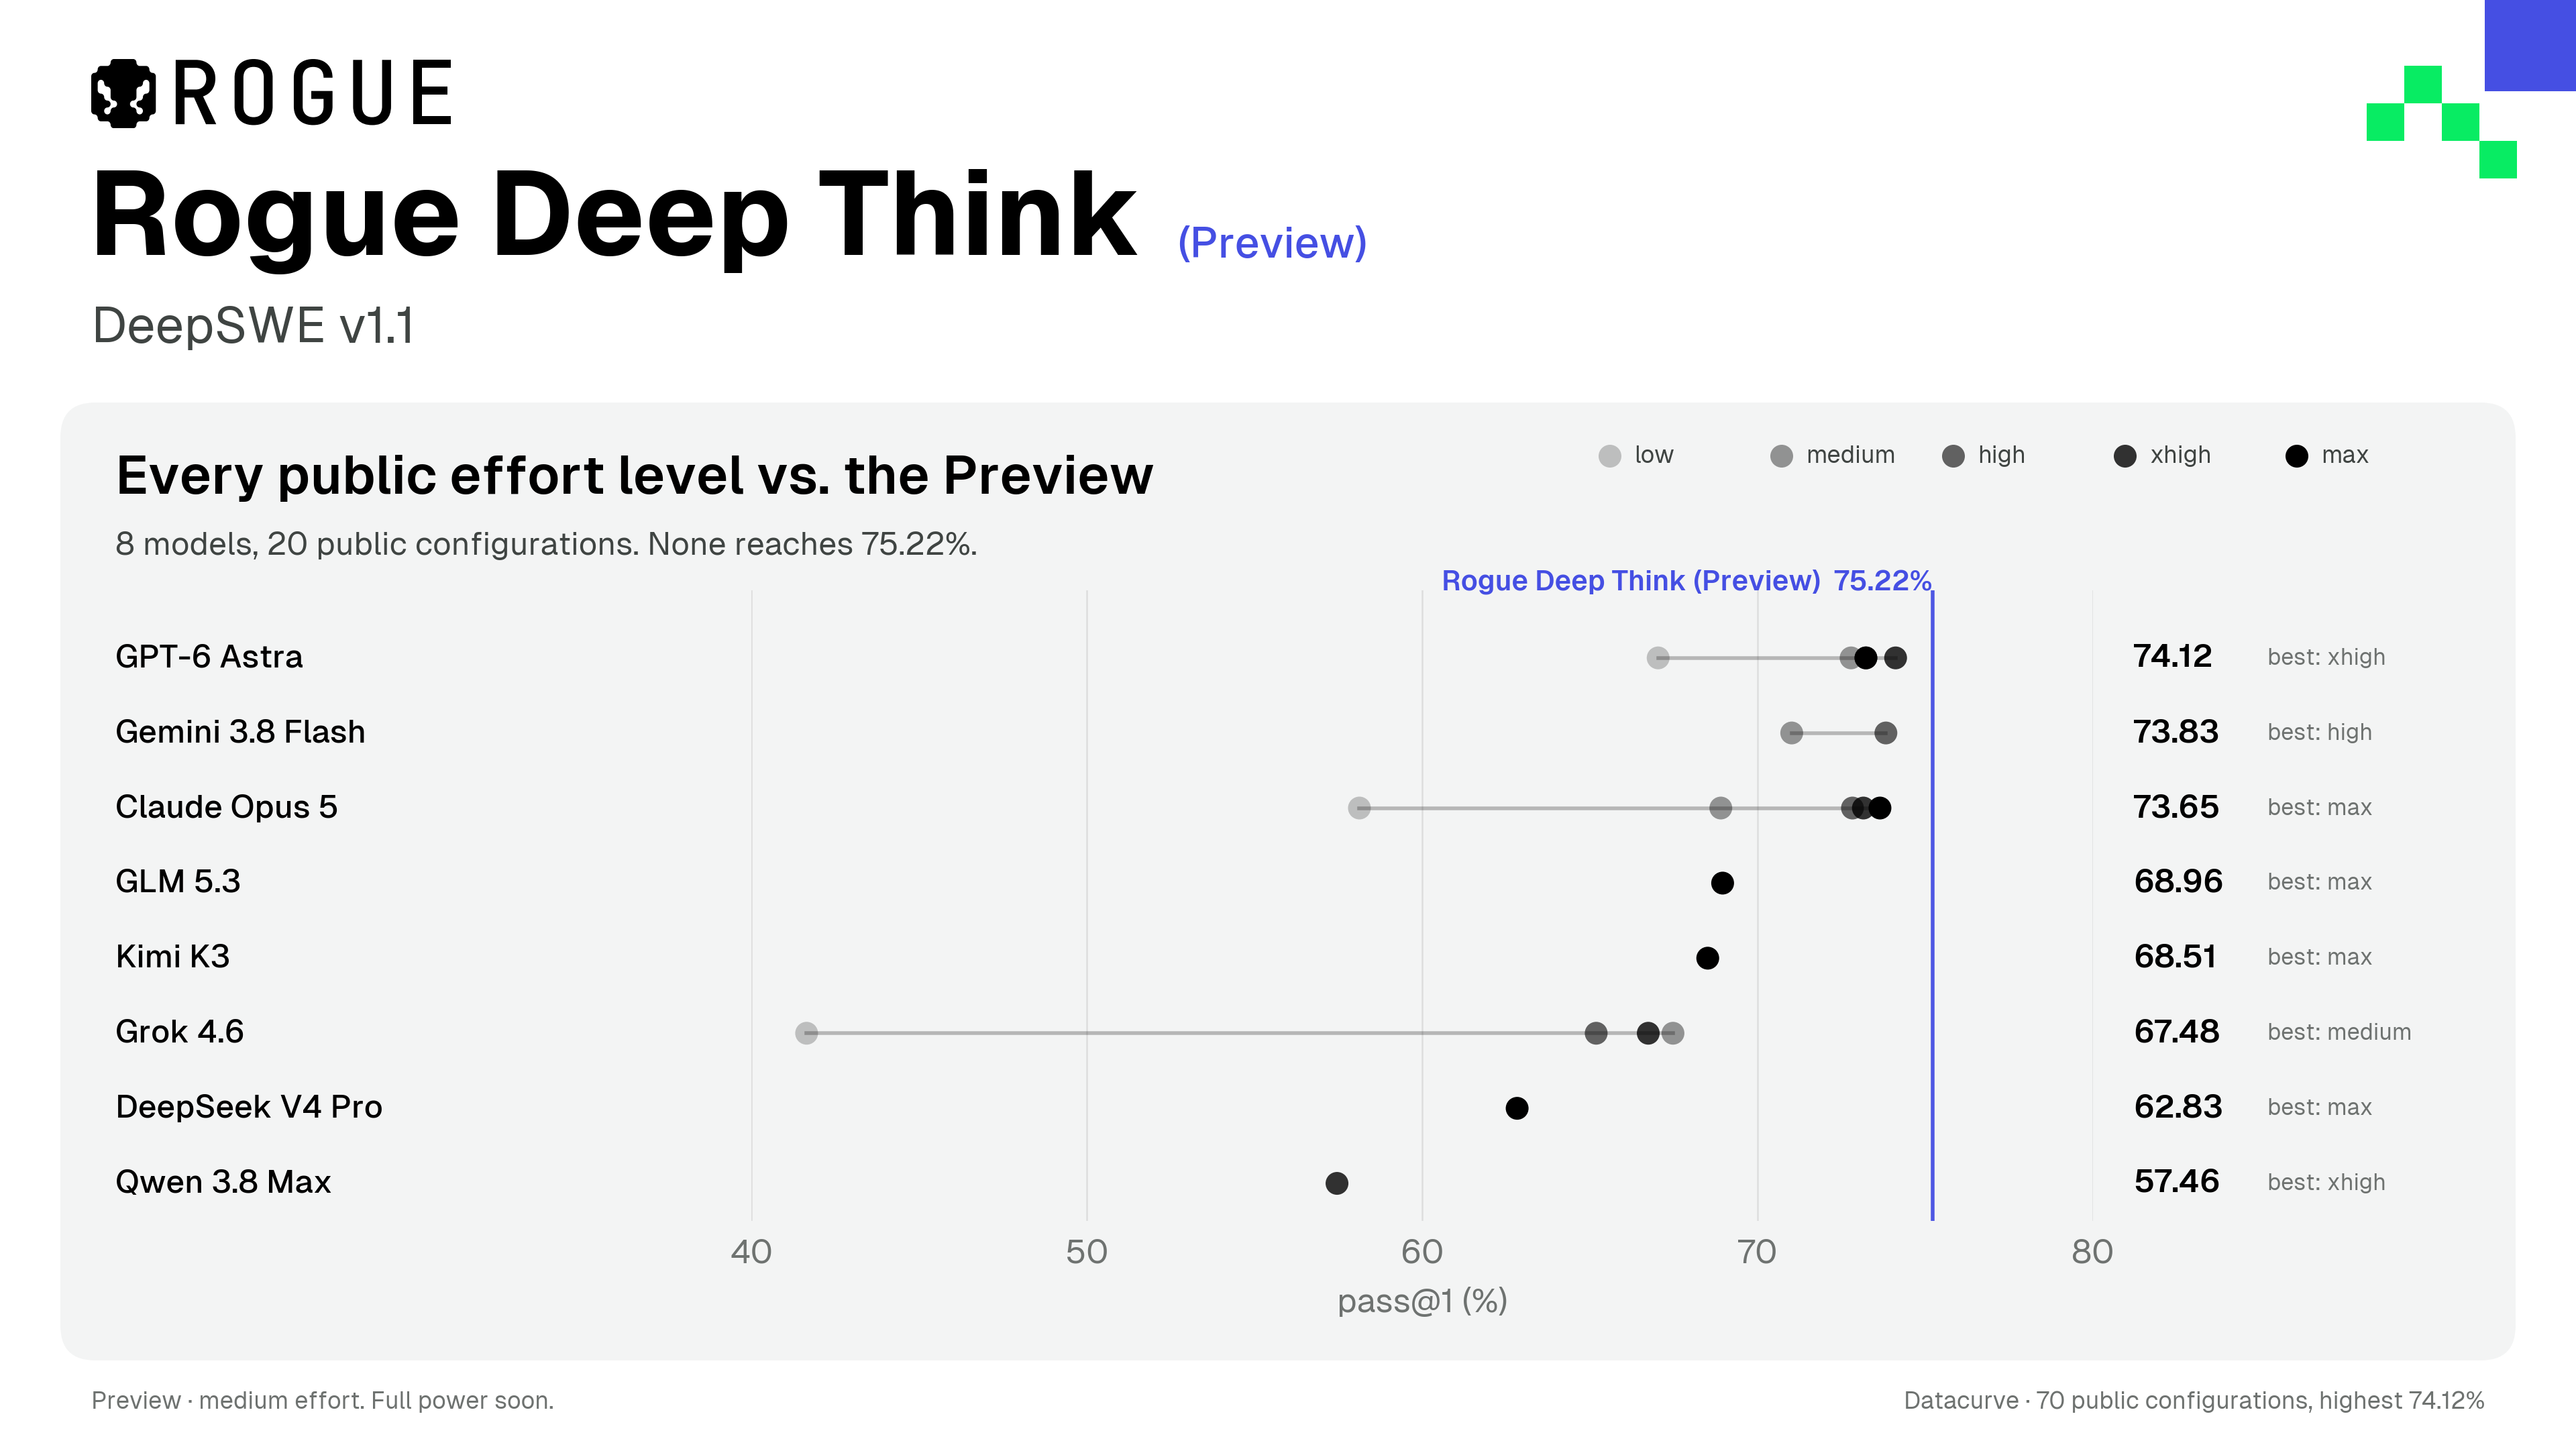
- DeepSWE v1.1: 75,22% em medium effort, 6,19 pp acima da base interna do GLM 5.3 (+9,0% relativo). Nenhuma das 70 configurações do placar público chega a esse valor; a maior é 74,12%.
- FrontierSWE v2: 36,78%, 6,60 pp acima da base interna (+21,9% relativo). No placar completo, ficaria em 5º entre 15, à frente do GPT-5.6 e de todos os modelos open-weight.
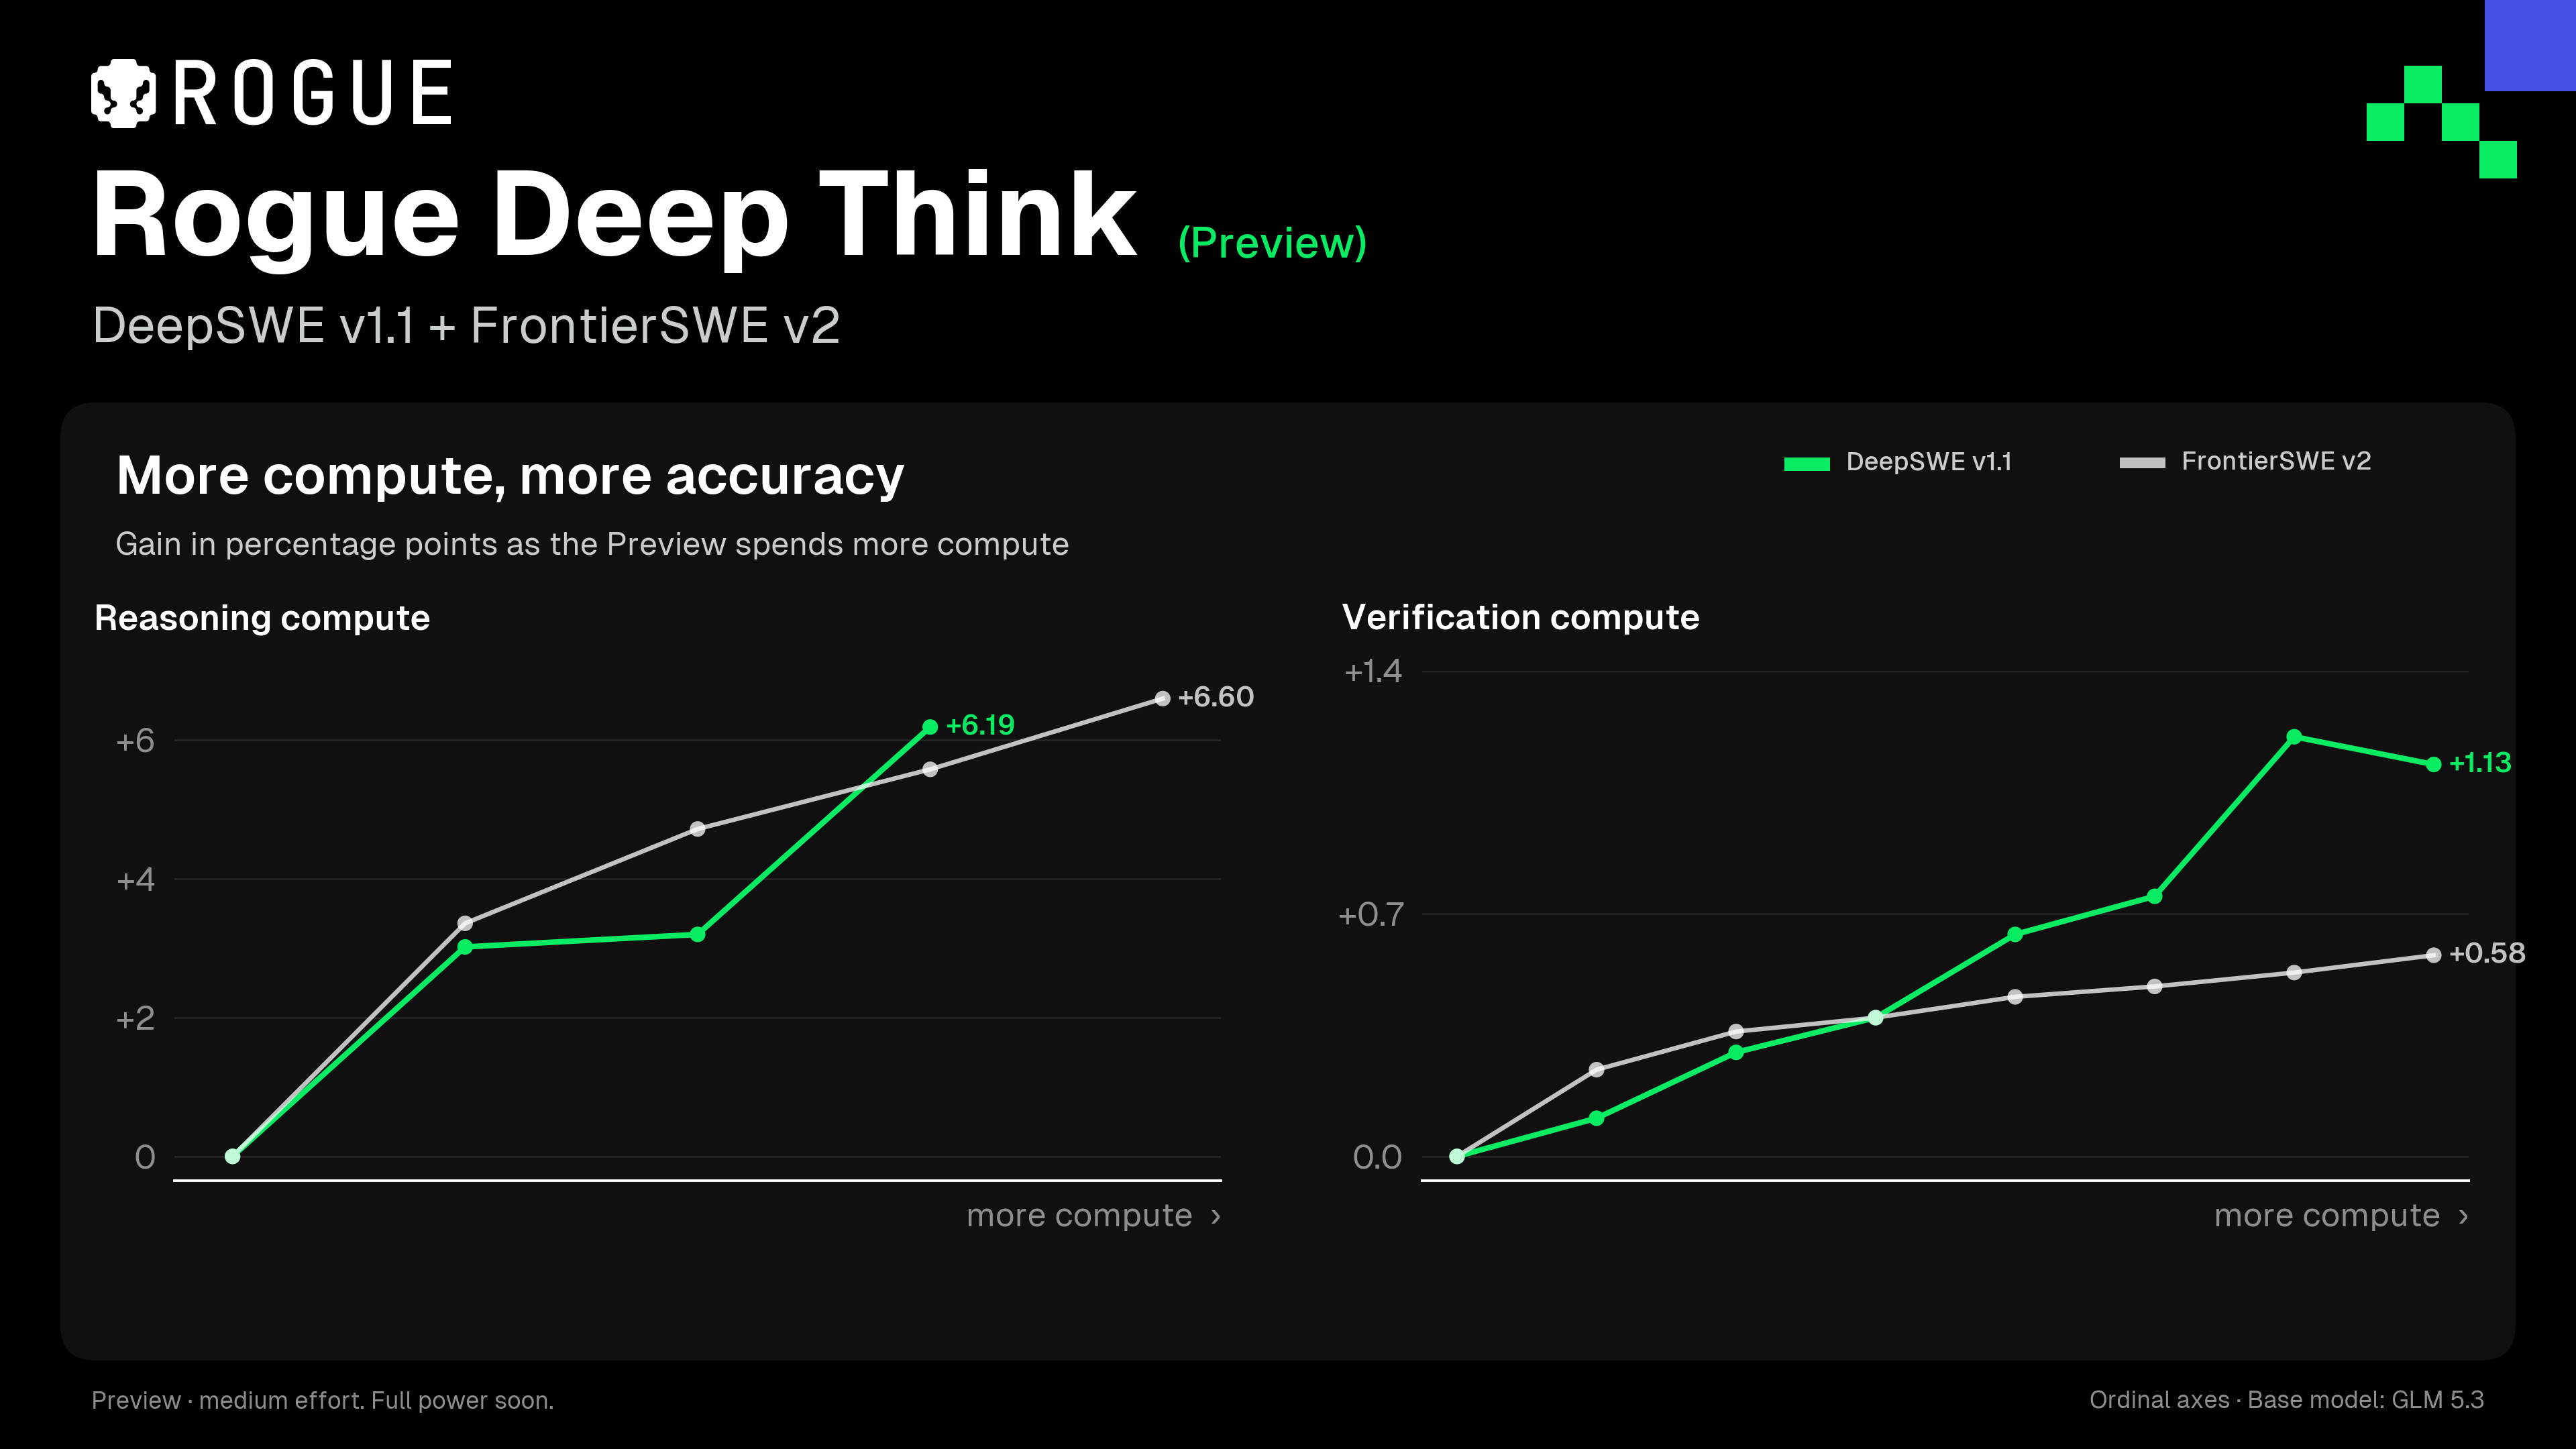
- Escala com computação. A pontuação sobe conforme o Preview usa mais computação no momento da resposta, nos dois benchmarks, e o resultado reportado ainda é medium effort.
- Avaliação interna, não submetida aos operadores dos benchmarks. O método não é descrito nesta versão.
Escala com computação
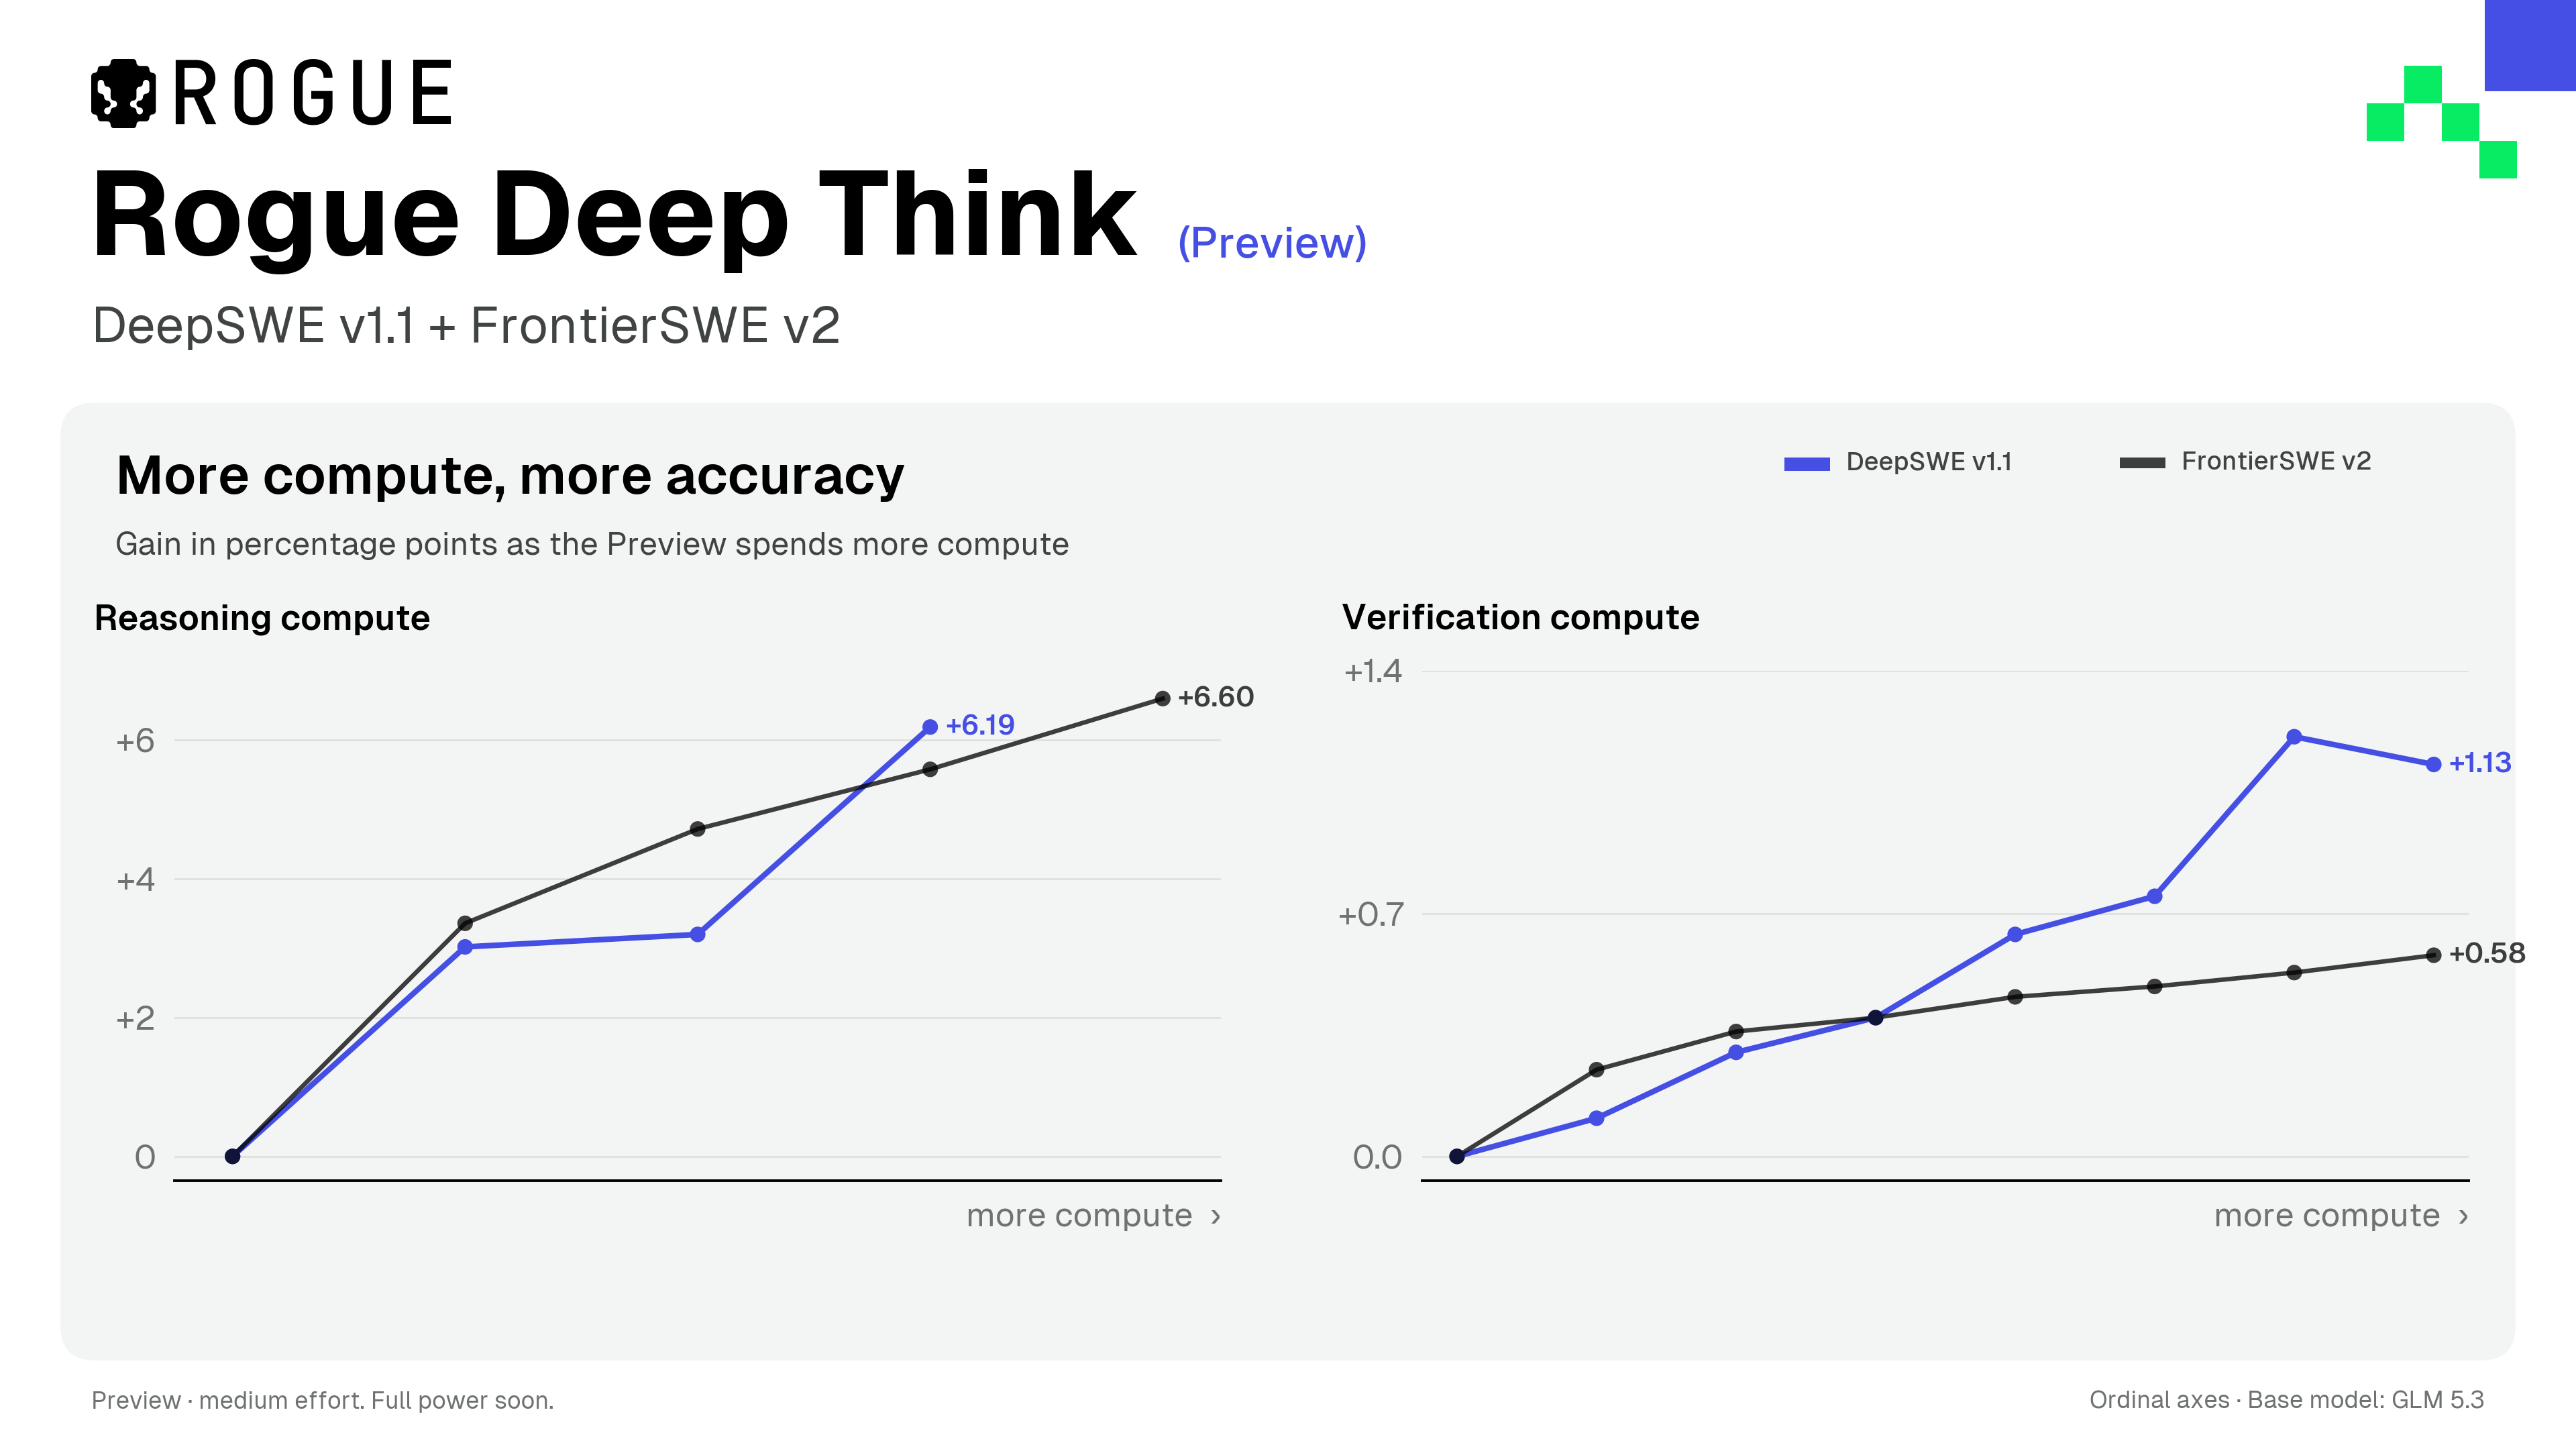
O Deep Think transforma computação no momento da resposta em acerto. Medimos o Preview com orçamentos crescentes em dois eixos, raciocínio e verificação, e a pontuação sobe nos dois, no DeepSWE e no FrontierSWE.


Os eixos mostram a ordem das configurações, não o orçamento. O método, o orçamento de cada configuração e o custo por tarefa ficam fora desta versão.
Avaliações
Contra a base interna do GLM 5.3, o Preview sobe 6,19 pontos no DeepSWE e 6,60 no FrontierSWE. Em termos relativos, são 9,0% e 21,9%: o ganho relativo é maior justamente no benchmark mais difícil.


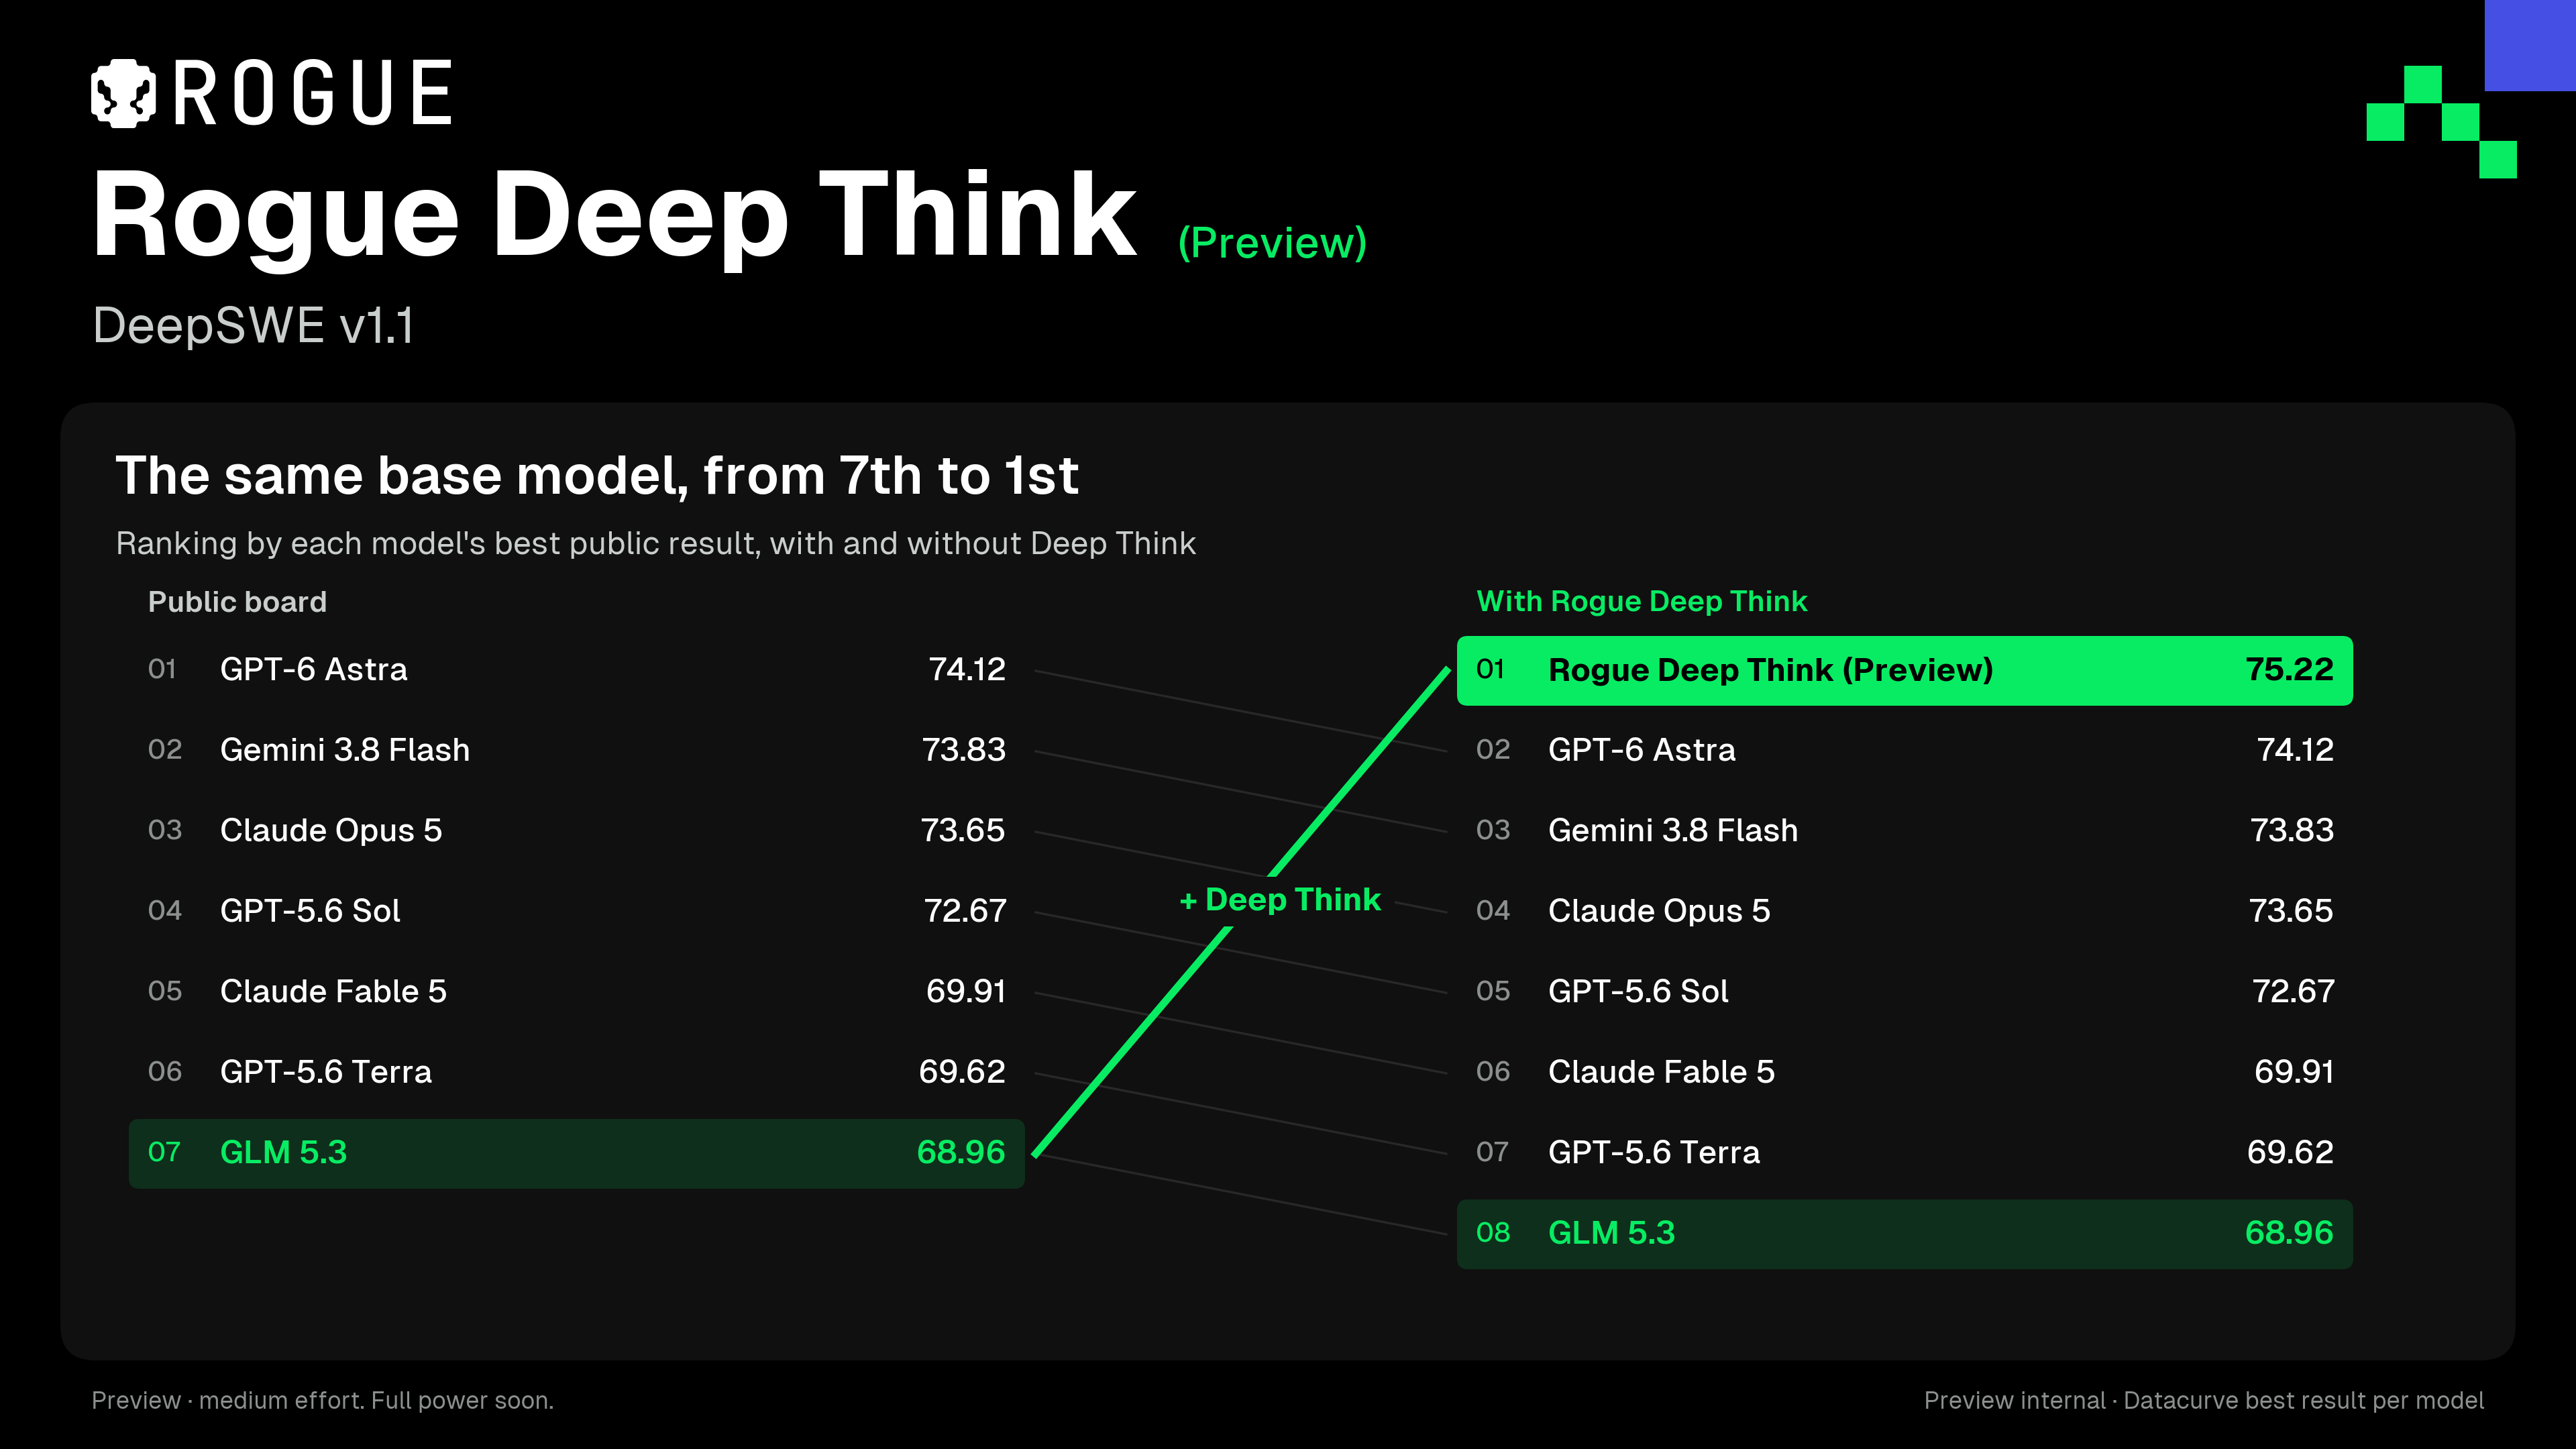
No DeepSWE, contando o melhor resultado público de cada um dos 28 modelos do placar, o GLM 5.3 está em 7º. Com o Deep Think, o mesmo modelo de base passa ao 1º.


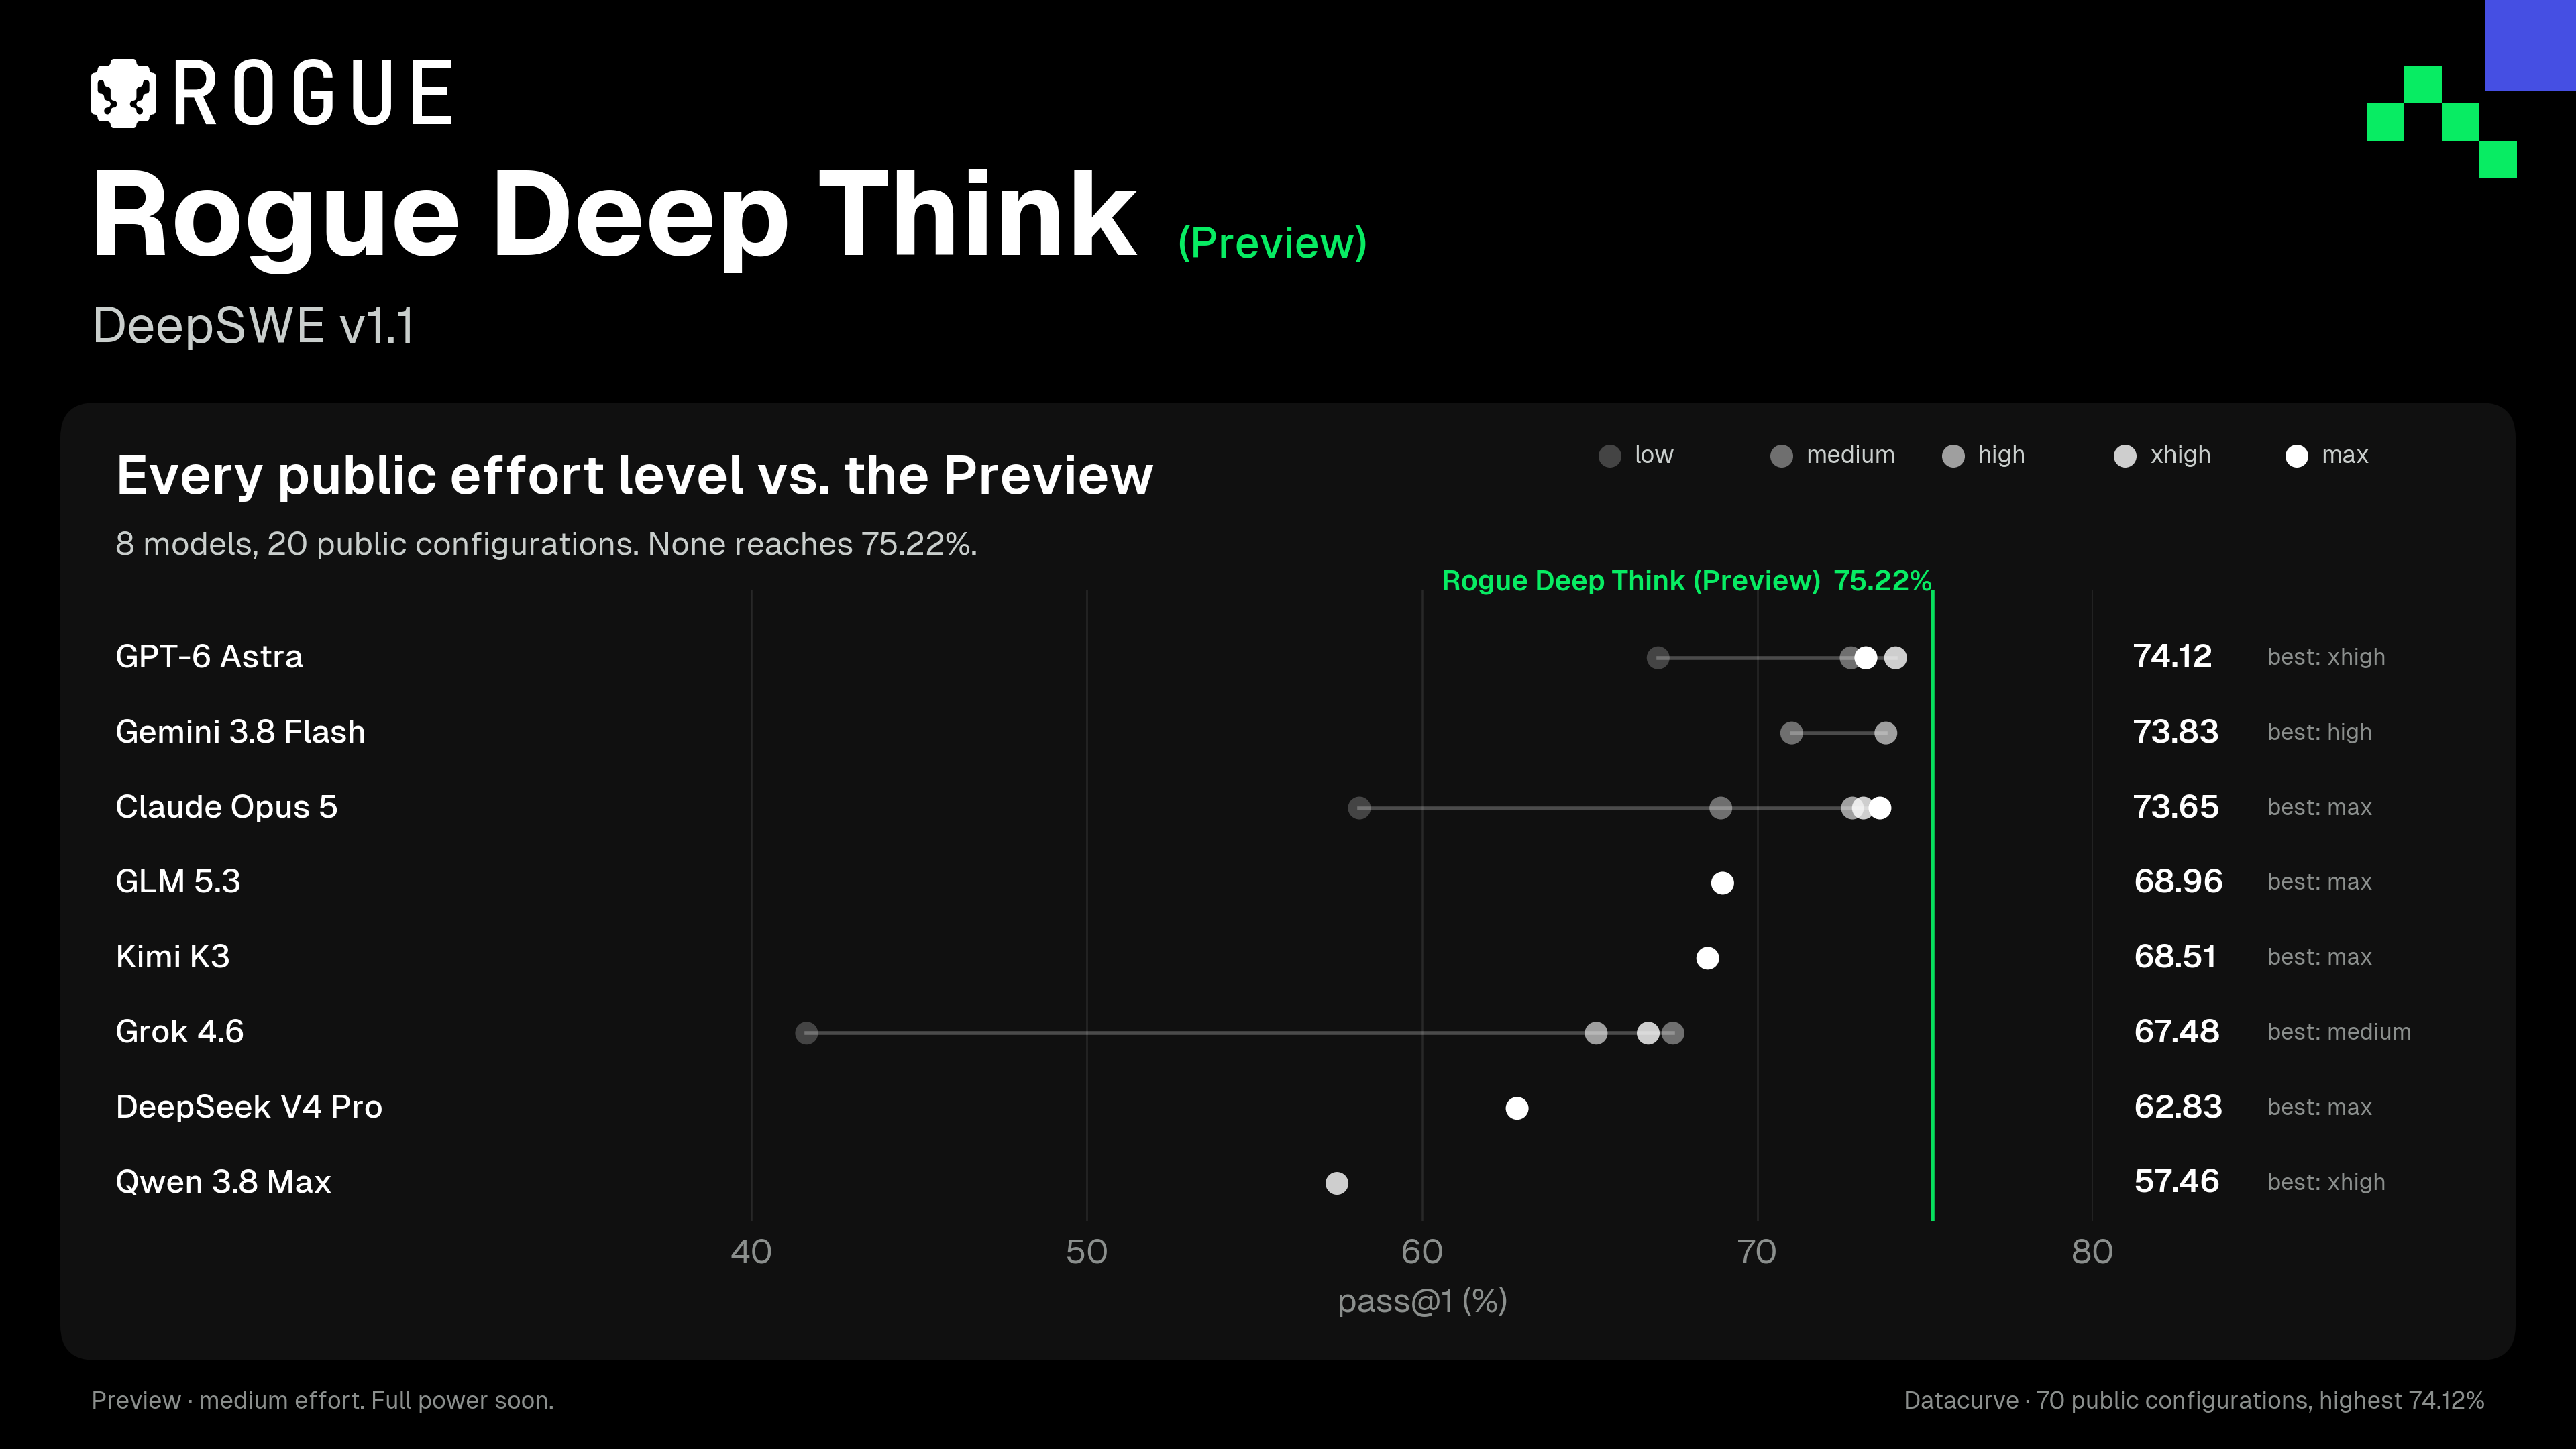
O Preview foi medido em medium effort. Nos oito modelos do gráfico abaixo, as 20 configurações públicas vão do low ao max, e nenhuma chega a 75,22%.


O que muda na prática
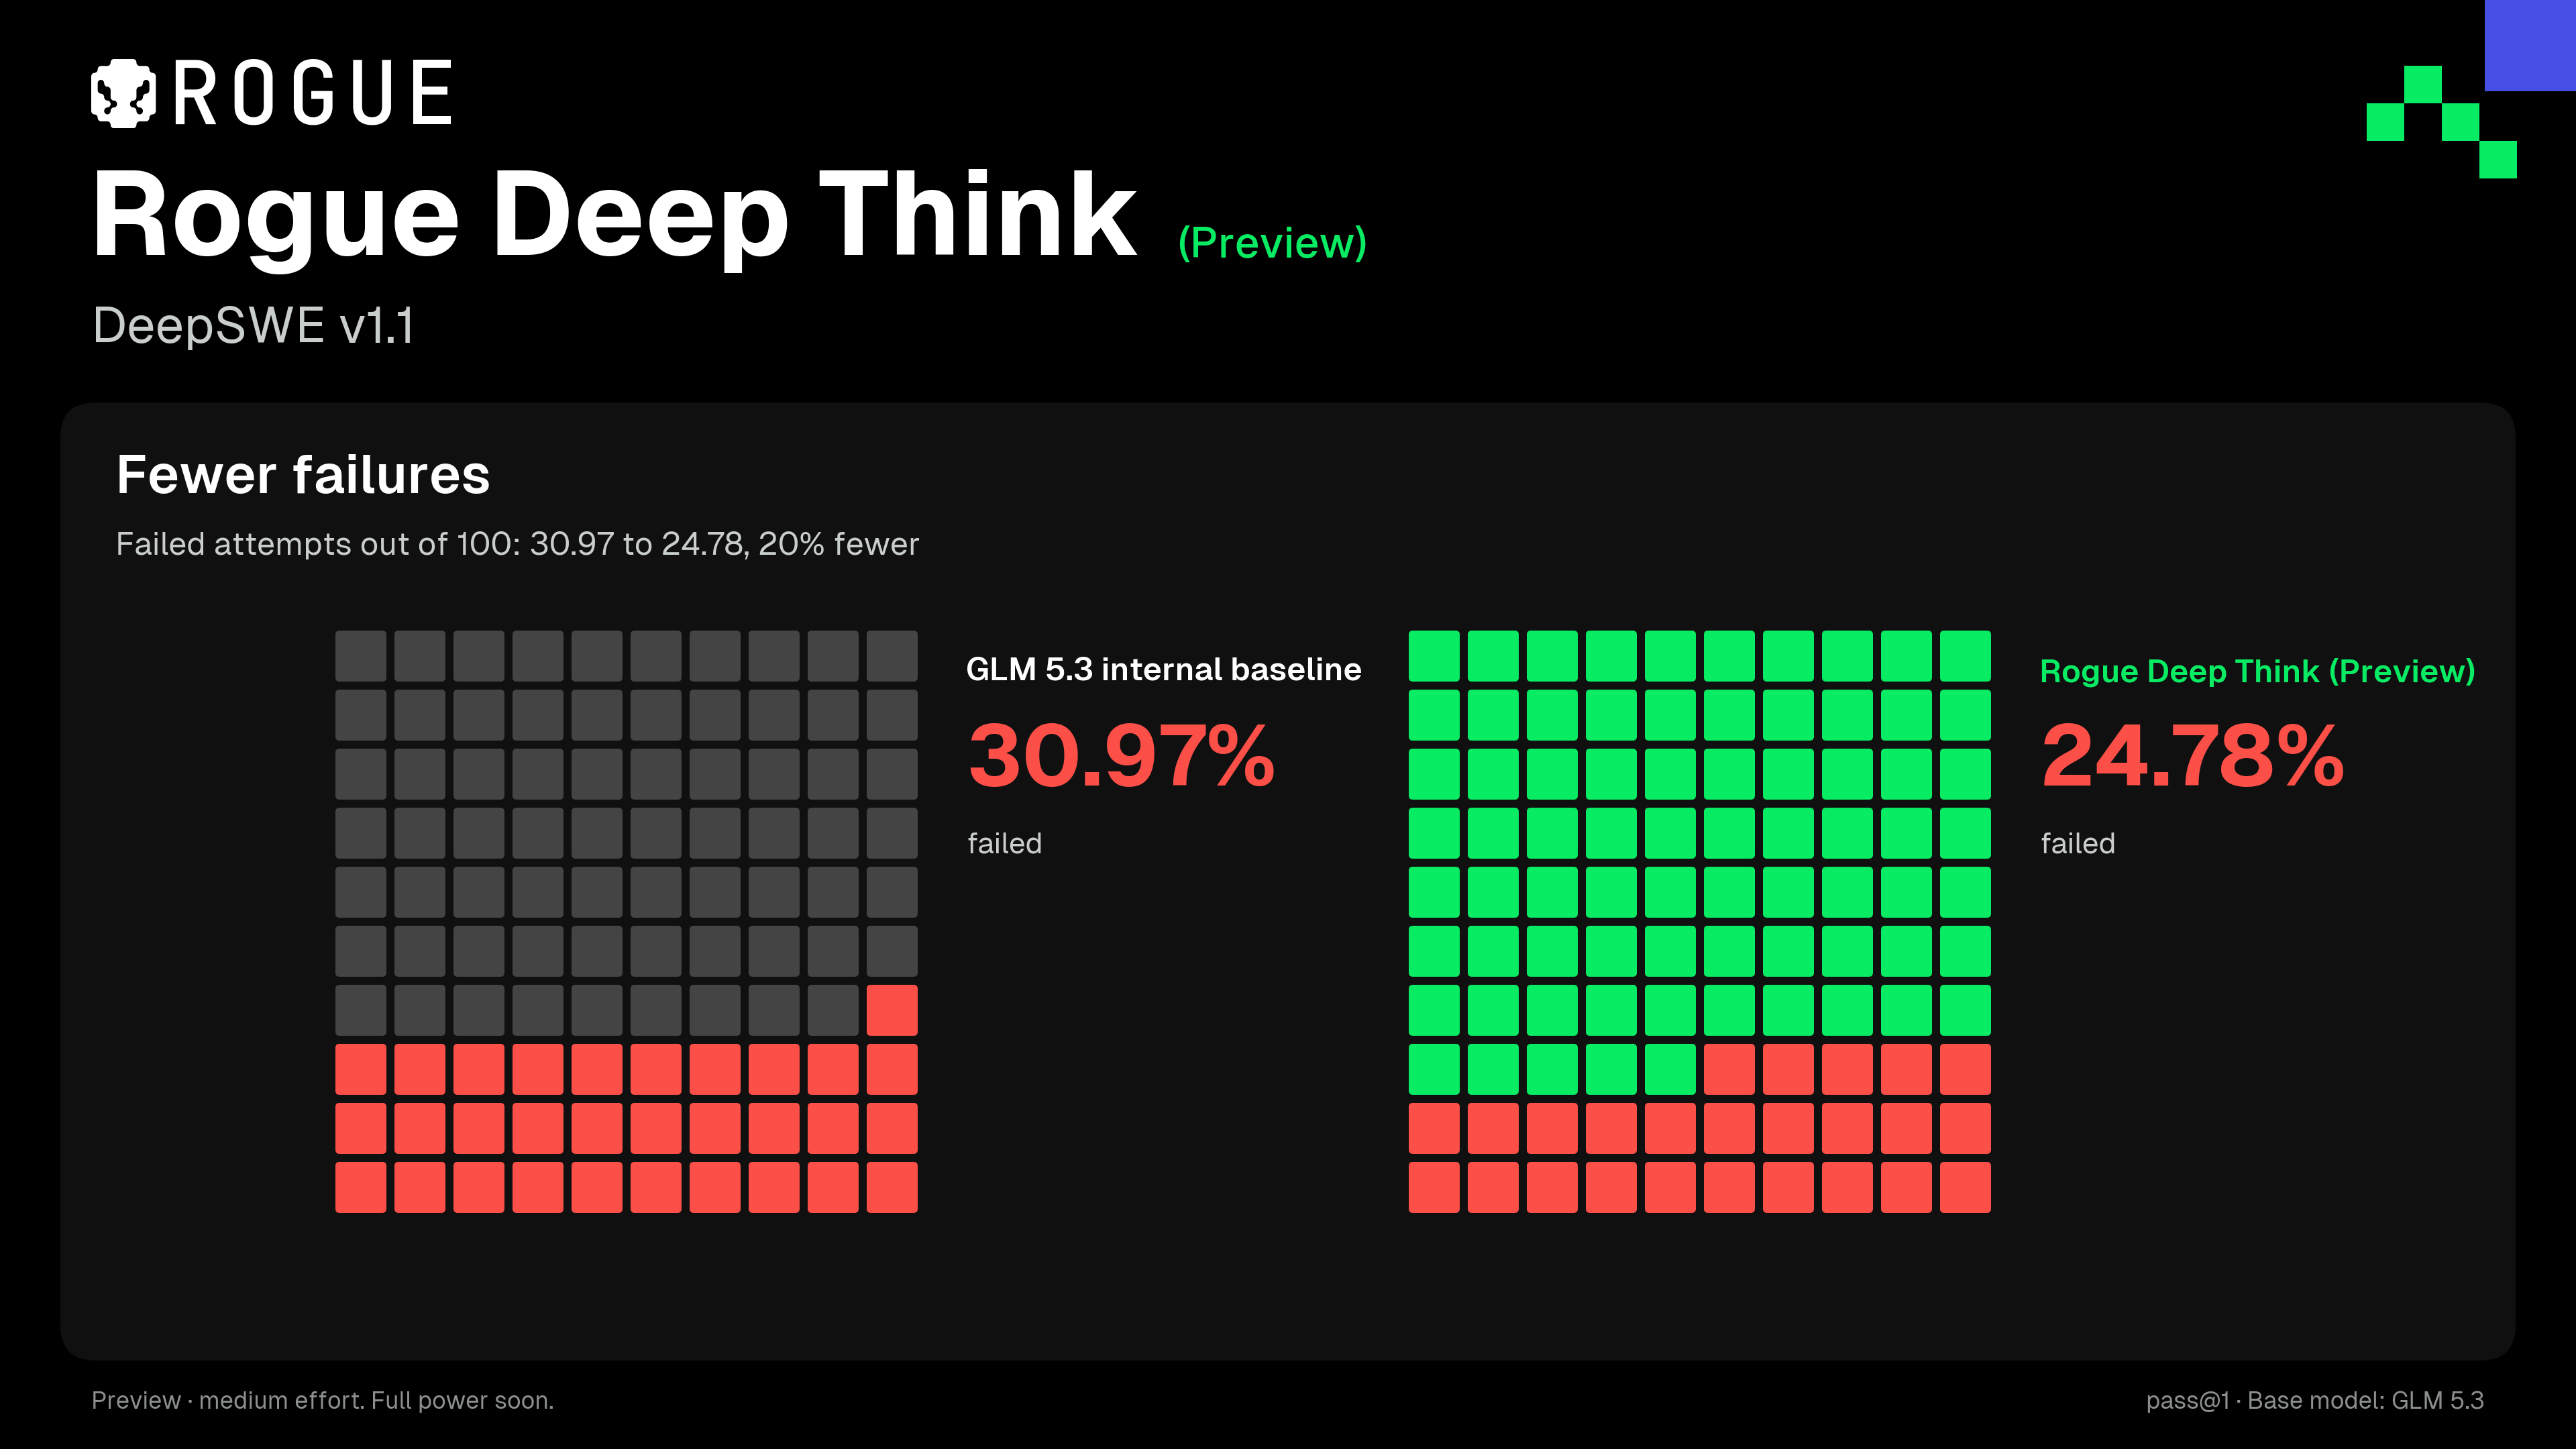
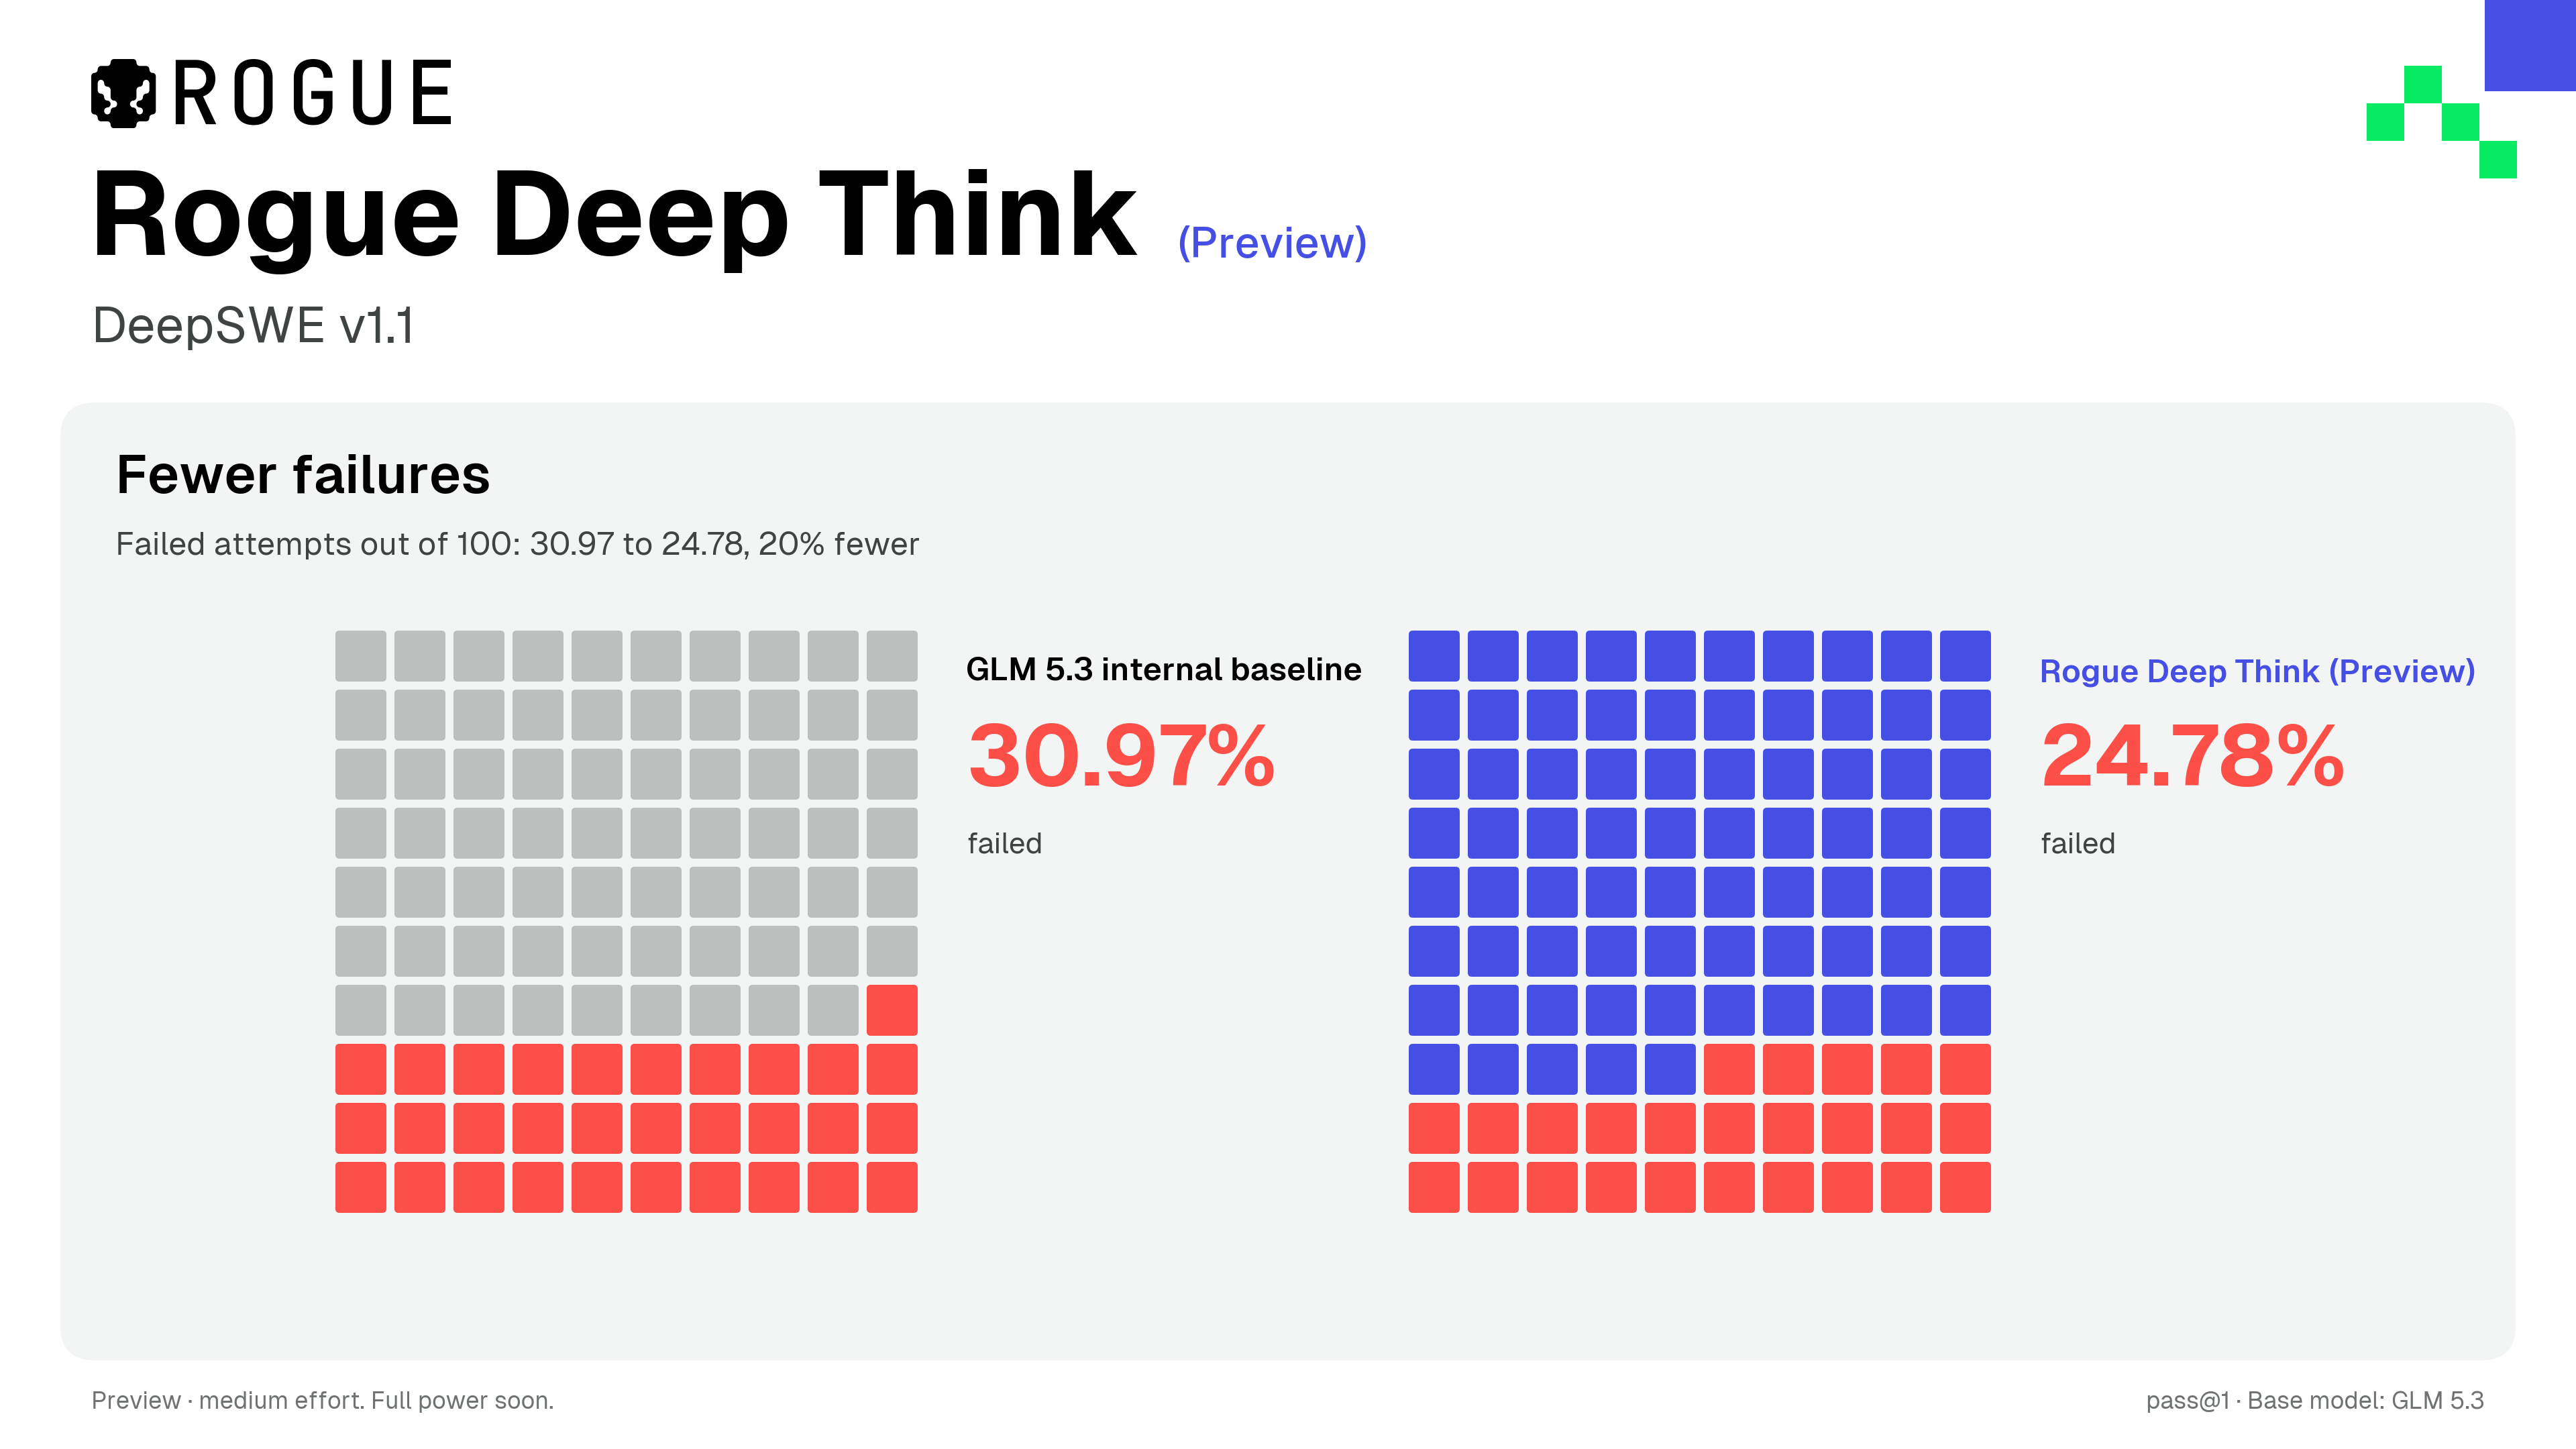
No DeepSWE, cada tarefa é uma mudança real em um projeto de código aberto, e a solução de referência adiciona em média 668 linhas em 7 arquivos. Com a base, 30,97% das tentativas falhavam; com o Preview, 24,78%. São 20% menos falhas: uma em cada cinco tentativas que falhavam passa a dar certo.


No FrontierSWE, em que uma tentativa pode durar até 20 horas, os 36,78% colocariam o Preview à frente do GPT-5.6 (32,20%) e de todos os modelos open-weight do placar, liderados pelo GLM 5.3 com 30,18%.
Placares públicos
Os resultados usados nas comparações, com a incerteza que cada operador publica.
DeepSWE v1.1
| Modelo (esforço) | pass@1 (%) | IC 95% | Fonte |
|---|---|---|---|
| Rogue Deep Think (Preview) | 75,22 | não publicado | Rogue, interna |
| GPT-6 Astra (xhigh)ref. | 74,12 | 71,25 a 76,98 | Datacurve |
| Gemini 3.8 Flash (high) | 73,83 | 72,41 a 75,24 | Datacurve |
| Claude Opus 5 (max)ref. | 73,65 | 69,78 a 77,52 | Datacurve |
| GPT-6 Astra (Max) | 73,23 | 72,40 a 74,06 | Datacurve |
| GLM 5.3 (Max) | 68,96 | 65,94 a 71,98 | Datacurve |
| Kimi K3 (Max) | 68,51 | 63,98 a 73,05 | Datacurve |
| Fable 5.1 (Max) | 67,4 | não publicado | Anthropic, 5 execuções |
| Grok 4.6 (xhigh) | 66,74 | 64,56 a 68,92 | Datacurve |
| DeepSeek V4 Pro (Max) | 62,83 | 56,50 a 69,17 | Datacurve |
| Qwen 3.8 Max (xhigh) | 57,46 | 54,80 a 60,12 | Datacurve |
FrontierSWE v2
| Modelo (esforço) | mean@5 (%) | worst@5 a best@5 | Fonte |
|---|---|---|---|
| GPT-6 Astra (Max) | 65,51 | 55,11 a 73,00 | Proximal |
| Fable 5.1 (Max) | 56,29 | 44,47 a 66,65 | Proximal, fallback Opus 5 |
| Claude Opus 5 (Max)ref. | 52,01 | 39,12 a 60,65 | Proximal |
| Claude Fable 5 (Max)ref. | 46,96 | 33,90 a 61,77 | Proximal |
| Rogue Deep Think (Preview) | 36,78 | não publicado | Rogue, interna |
| GLM 5.3 (Max) | 30,18 | 17,72 a 40,64 | Proximal |
| Kimi K3 (Max) | 25,87 | 13,87 a 37,55 | Proximal |
| Grok 4.6 (Max) | 25,29 | 12,86 a 37,29 | Proximal |
| Gemini 3.8 Flash (Max) | 19,63 | 9,51 a 31,64 | Proximal |
| Qwen 3.8 Max (Max) | 15,81 | 8,70 a 24,27 | Proximal |
Um resultado por modelo, com o maior esforço publicado, mesmo quando um esforço menor pontua mais (Grok 4.6: medium 67,48% contra xhigh 66,74%). As linhas marcadas com ref. estão no placar e fora da seleção das artes da versão geral. O placar do DeepSWE foi gerado em 3 de setembro de 2026. O GPT-6 Astra entrou no FrontierSWE em 11 de setembro; o texto de metodologia do benchmark foi escrito antes e ainda cita o Fable 5.1 como líder.
Contexto dos benchmarks
- SWE-bench Verified. A OpenAI parou de reportar em 23/02/2026: todos os modelos de ponta que testou reproduziam parte das soluções de referência, 59,4% de 138 problemas auditados tinham defeito no teste ou na descrição, e o topo andou de 74,9% para 80,9% em seis meses.
- SWE-bench Pro. Na auditoria de 08/07/2026, a OpenAI marcou 27,4% das tarefas pelo pipeline de agentes e 34,1% pela anotação humana; na divisão pública, de 731 tarefas, a aprovação foi de 23,3% para 80,3% em oito meses. A recomendação de usá-lo foi retirada.
- DeepSWE v1.1. 113 tarefas escritas do zero, em 91 repositórios e 5 linguagens, nunca enviadas aos projetos originais, com verificadores comportamentais escritos à mão. pass@1 em 4 execuções por tarefa, com o mini-swe-agent. A solução de referência adiciona em média 668 linhas em 7 arquivos (SWE-bench Pro: 120 em 5; Verified: 10 em 1).
- FrontierSWE v2. 34 tarefas de horizonte ultralongo em cinco áreas: pesquisa em IA, implementação, otimização de desempenho, computação científica e raciocínio visual. Até 20 h por tentativa, esforço máximo, harness Proximus, mean@5.
Limitações
- Avaliação interna, não submetida aos operadores. Harness, orçamento e número de execuções diferem dos placares.
- Sem intervalo de confiança publicado para as execuções internas. No DeepSWE, os 75,22% ficam dentro do intervalo de 95% do maior resultado público (74,12%, de 71,25% a 76,98%): a diferença para ele não é estatisticamente estabelecida.
- FrontierSWE: a equivalência entre o ensaio interno e o mean@5 público não foi estabelecida.
- Medium effort é o rótulo interno da avaliação. O esforço usado na base interna não está documentado nesta versão.
- O método, o orçamento de computação e o custo por tarefa não são publicados nesta versão. Os eixos do gráfico de escala são ordinais.
- Fable 5.1 no DeepSWE: resultado do fornecedor (5 execuções, system card p. 168), fora do placar da Datacurve. No FrontierSWE, usa o Opus 5 nas tarefas bloqueadas por filtro de conteúdo.
Fontes
Placares consultados em 18 de setembro de 2026.
- DeepSWE · DatacurvePlacar público
- DeepSWE · MetodologiaComo as tarefas são feitas
- FrontierSWE v2 · PlacarPontuações públicas
- FrontierSWE v2 · MetodologiaProtocolo da avaliação
- FrontierSWE · ChangelogEntrada do GPT-6 Astra
- OpenAI · SWE-bench VerifiedPor que deixou de divulgar, fev. 2026
- OpenAI · SWE-bench ProAuditoria das tarefas, jul. 2026
- Fable 5.1 · System CardAnthropic · p. 168