Hoje apresentamos o Rogue Deep Think (Preview), o modelo mais poderoso da Rogue para engenharia de software. Ele parte do GLM 5.3 e dedica mais raciocínio e mais verificação a cada tarefa antes de entregar a resposta.
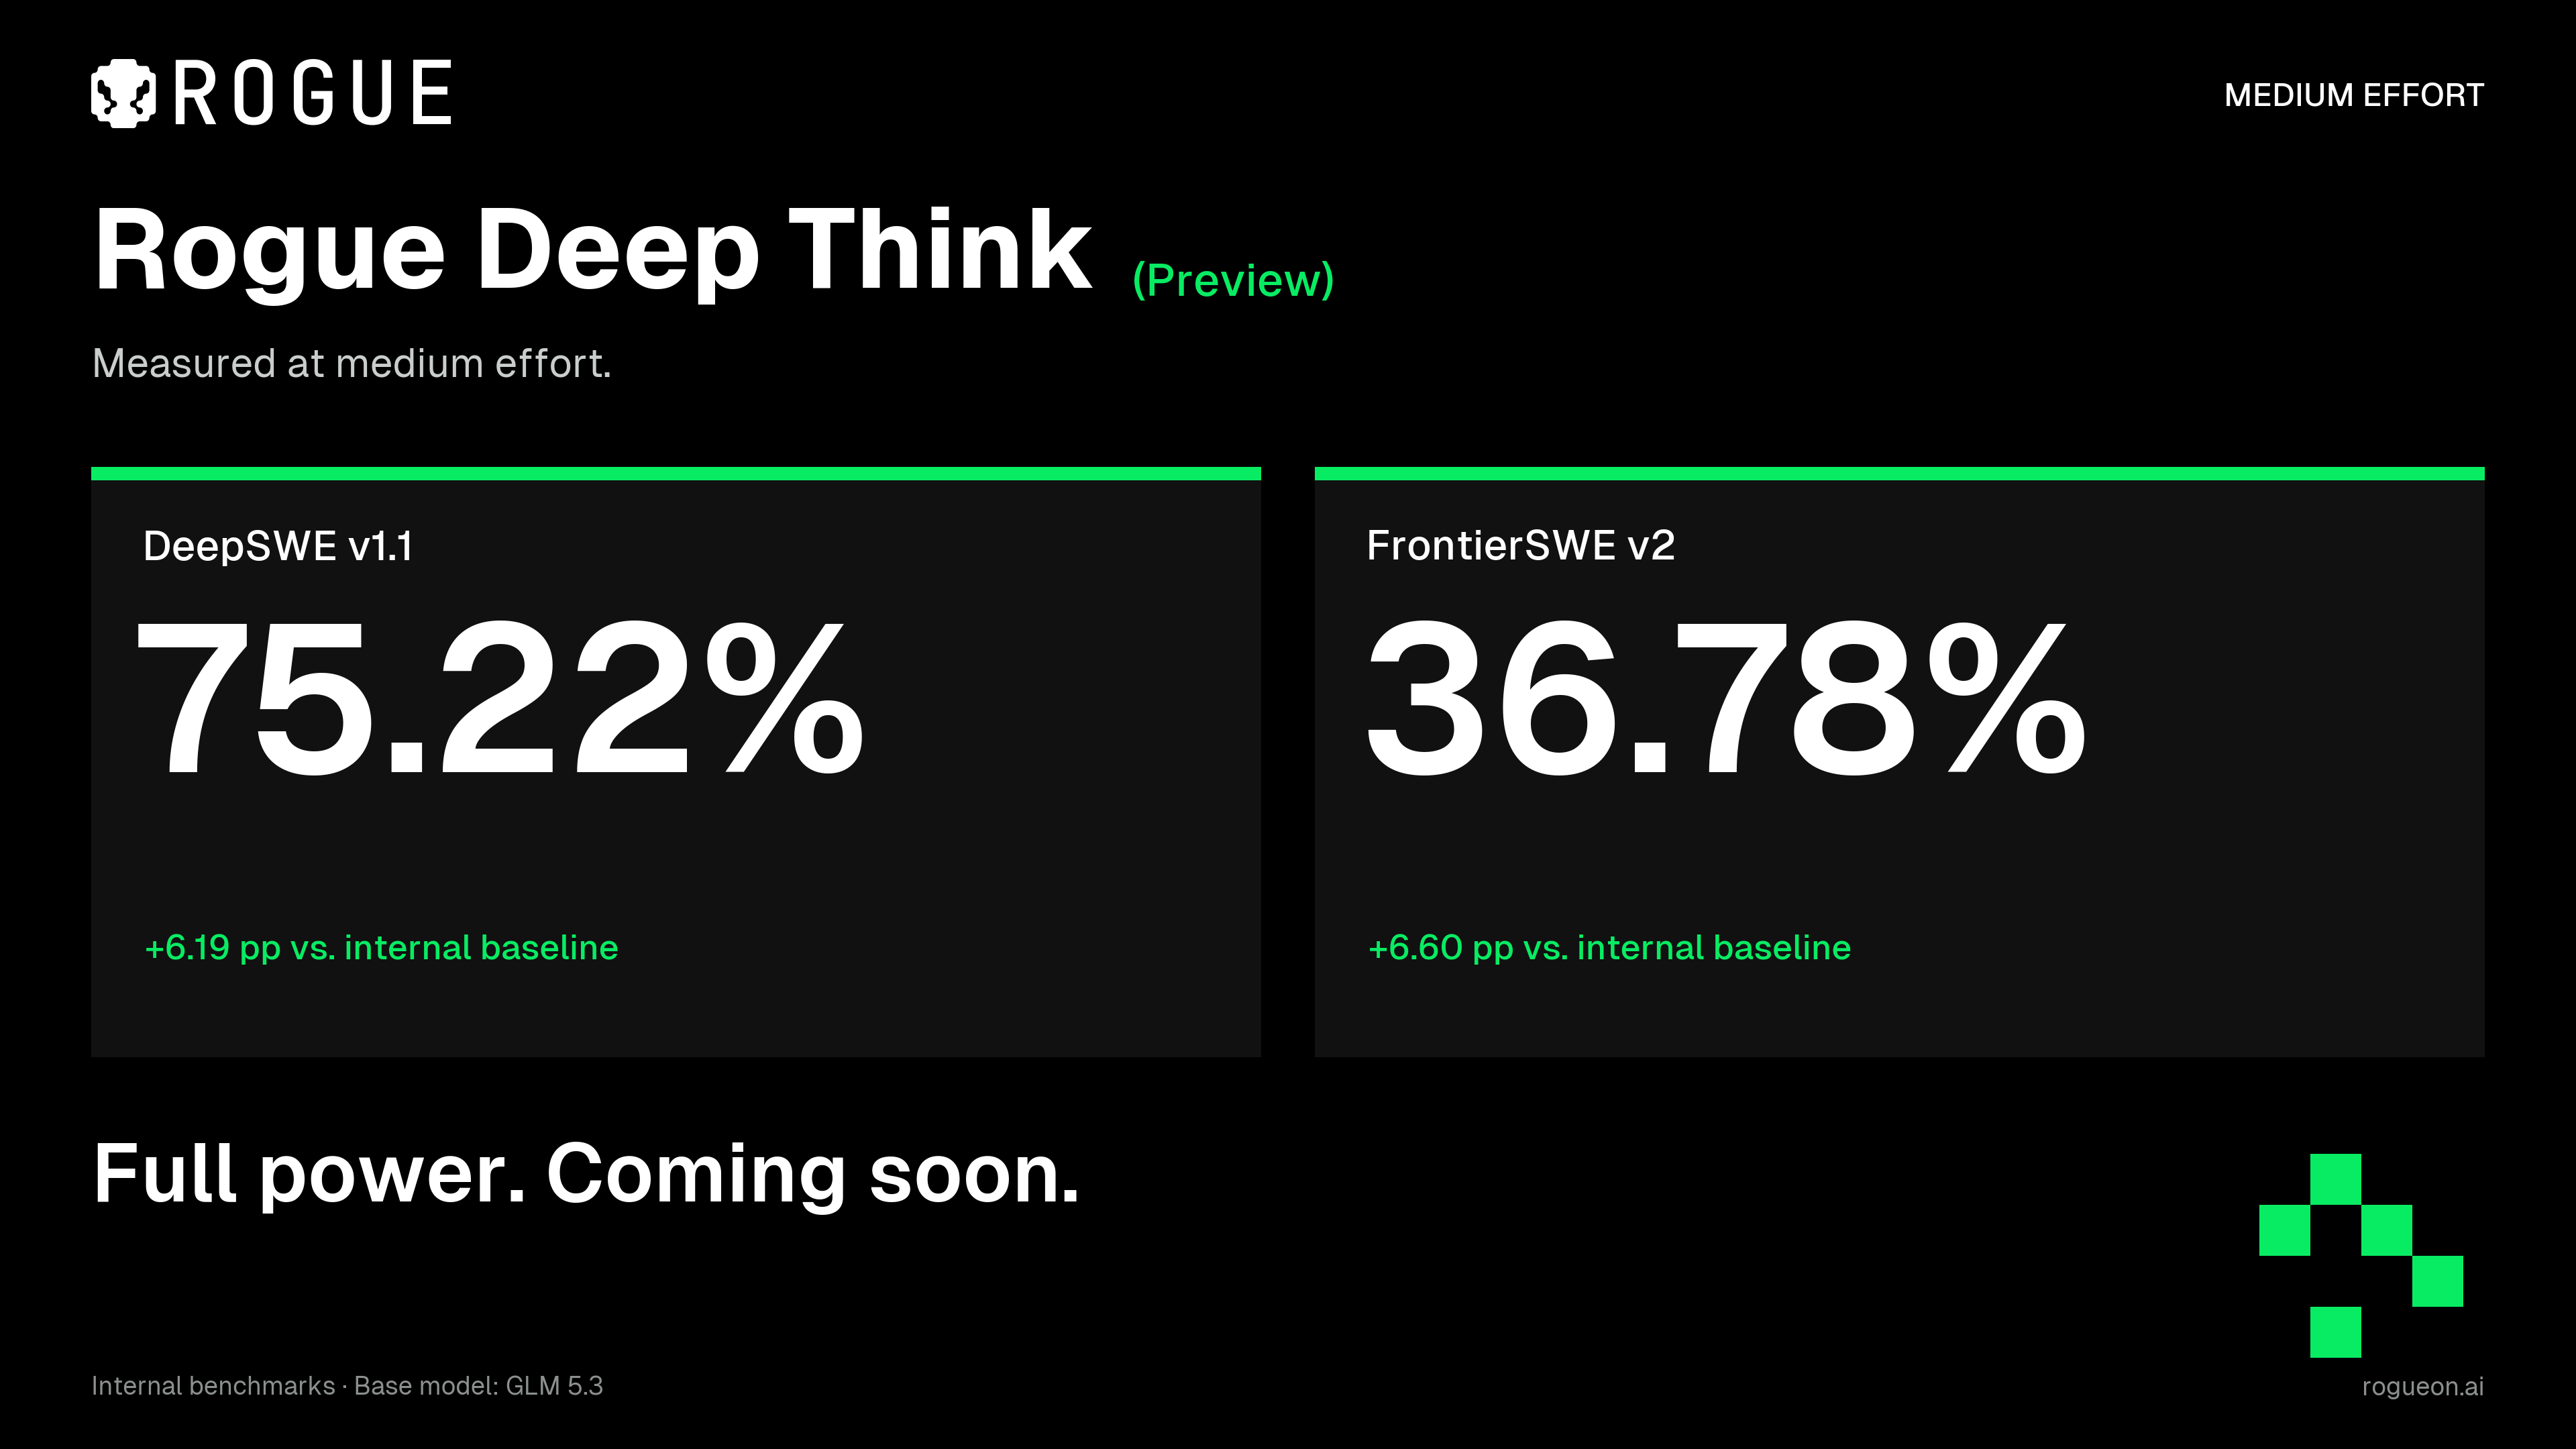
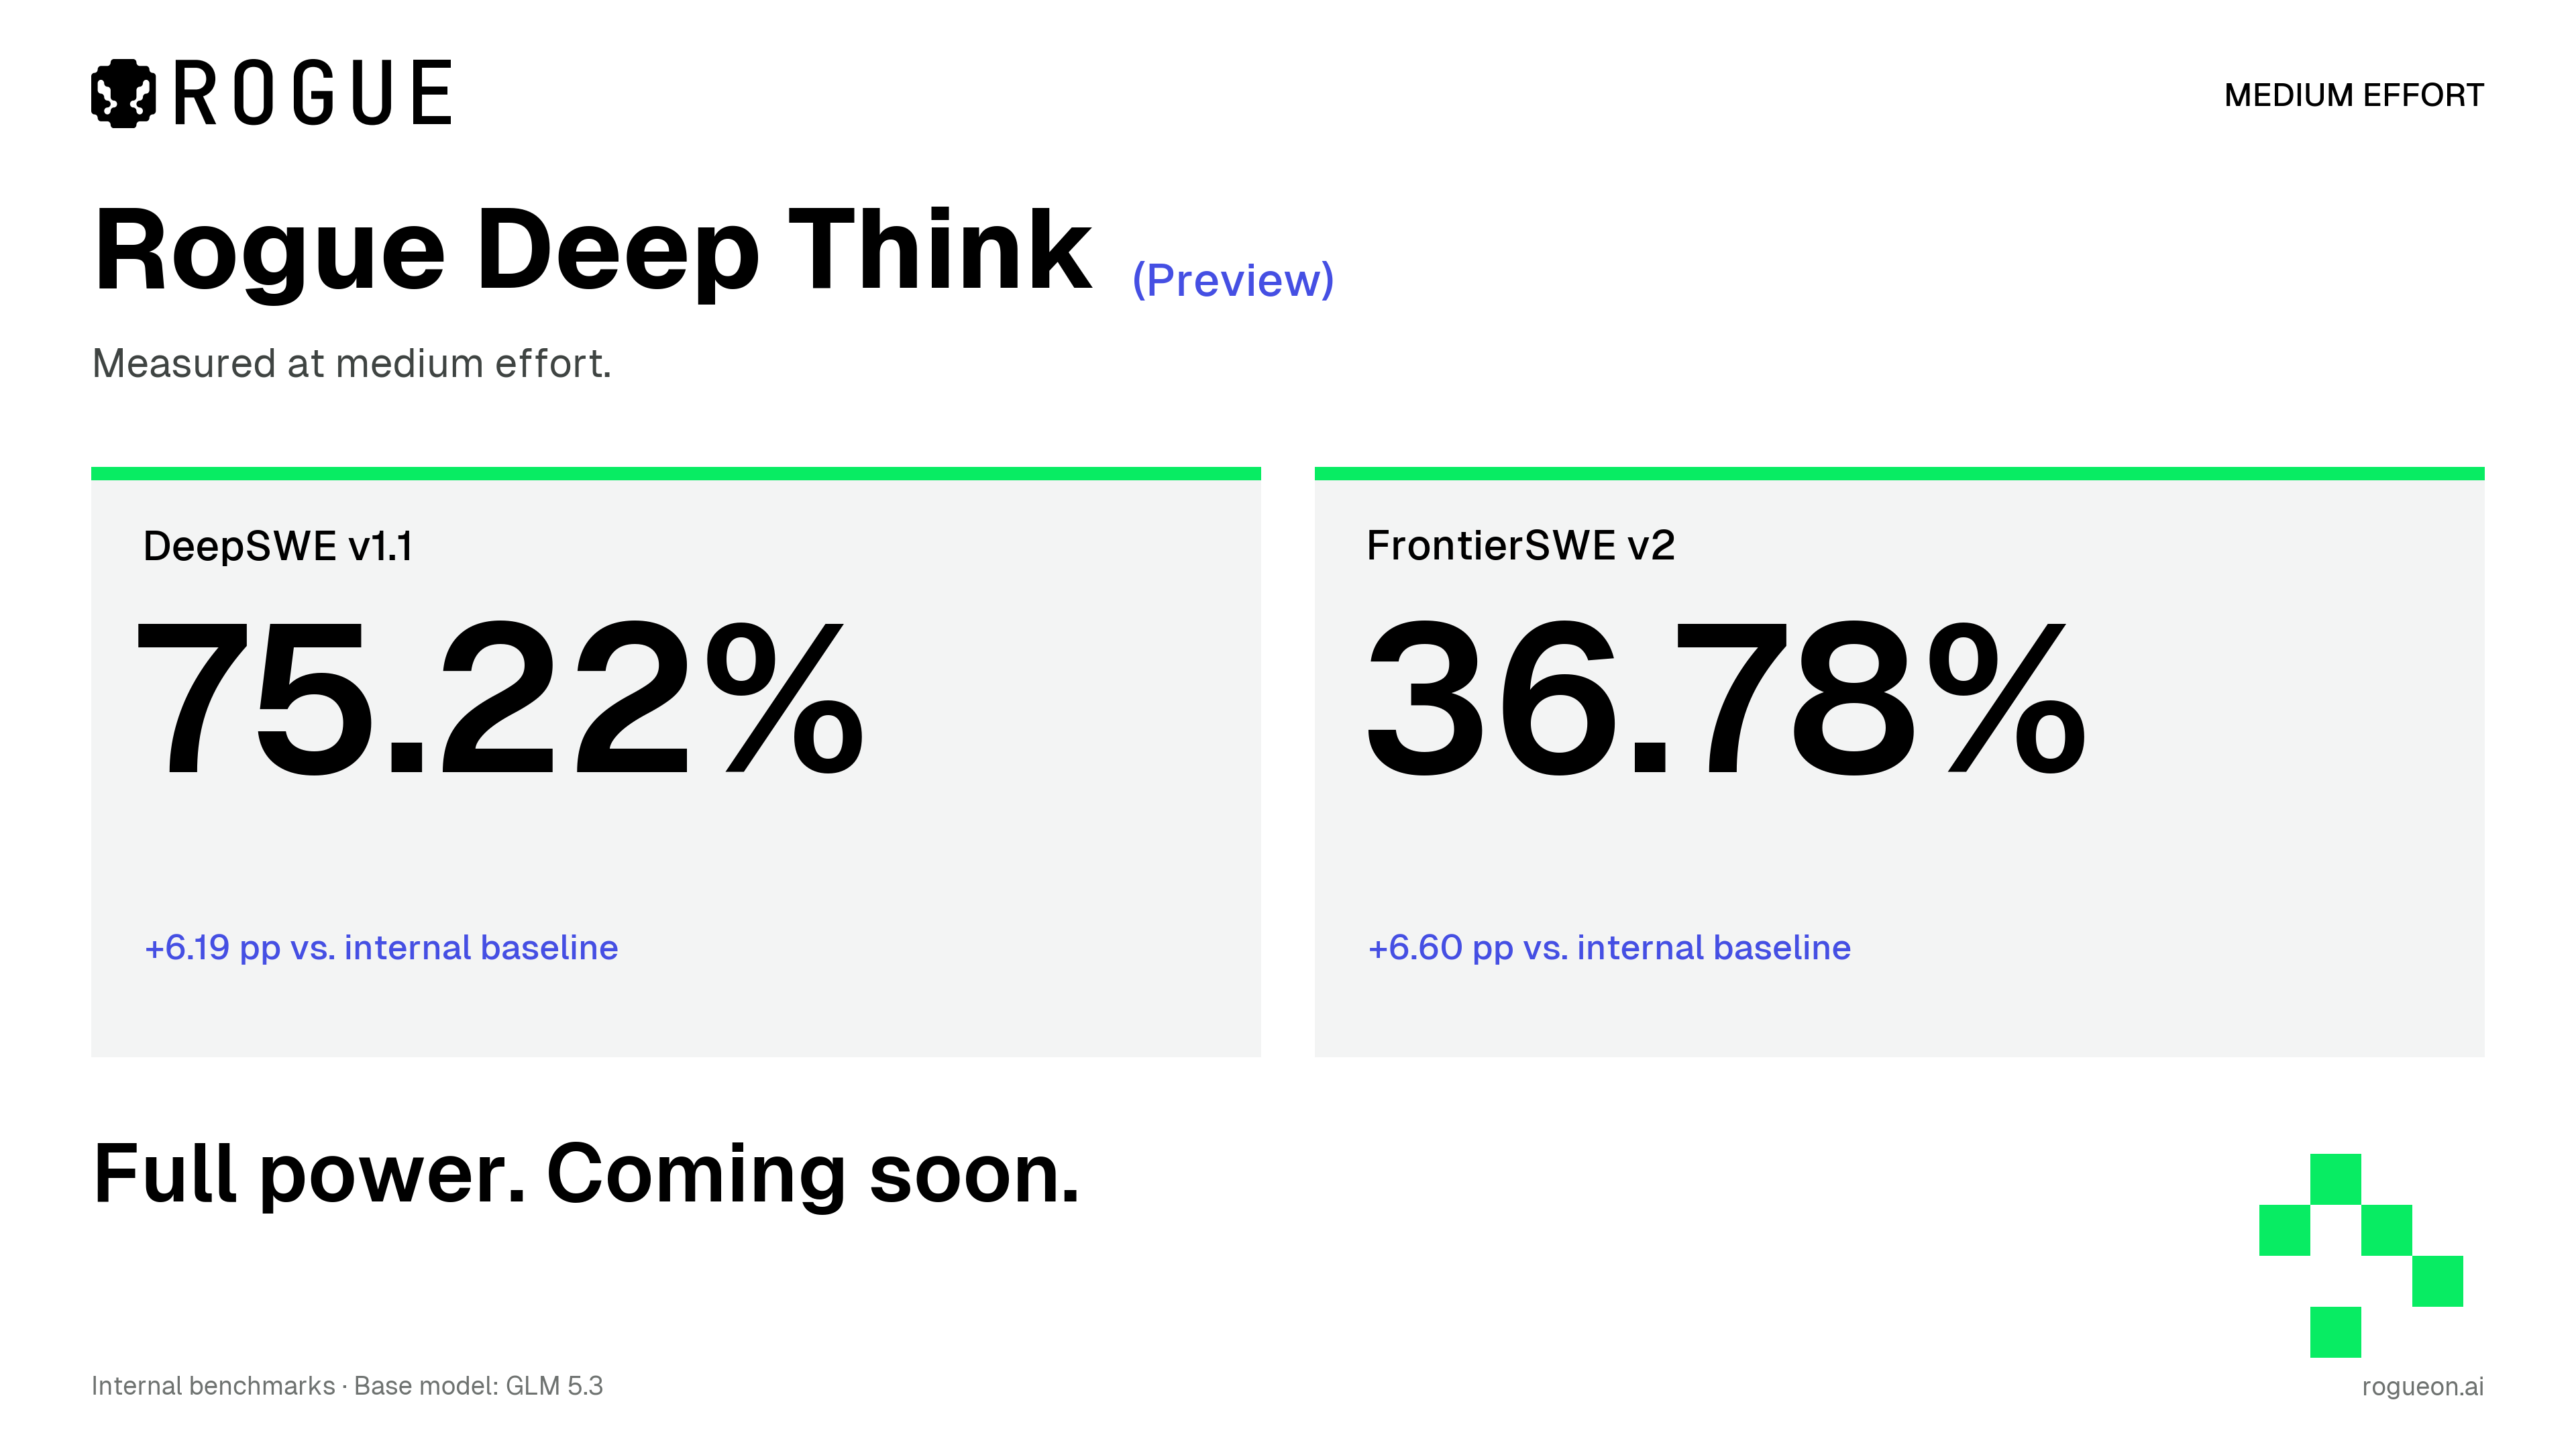
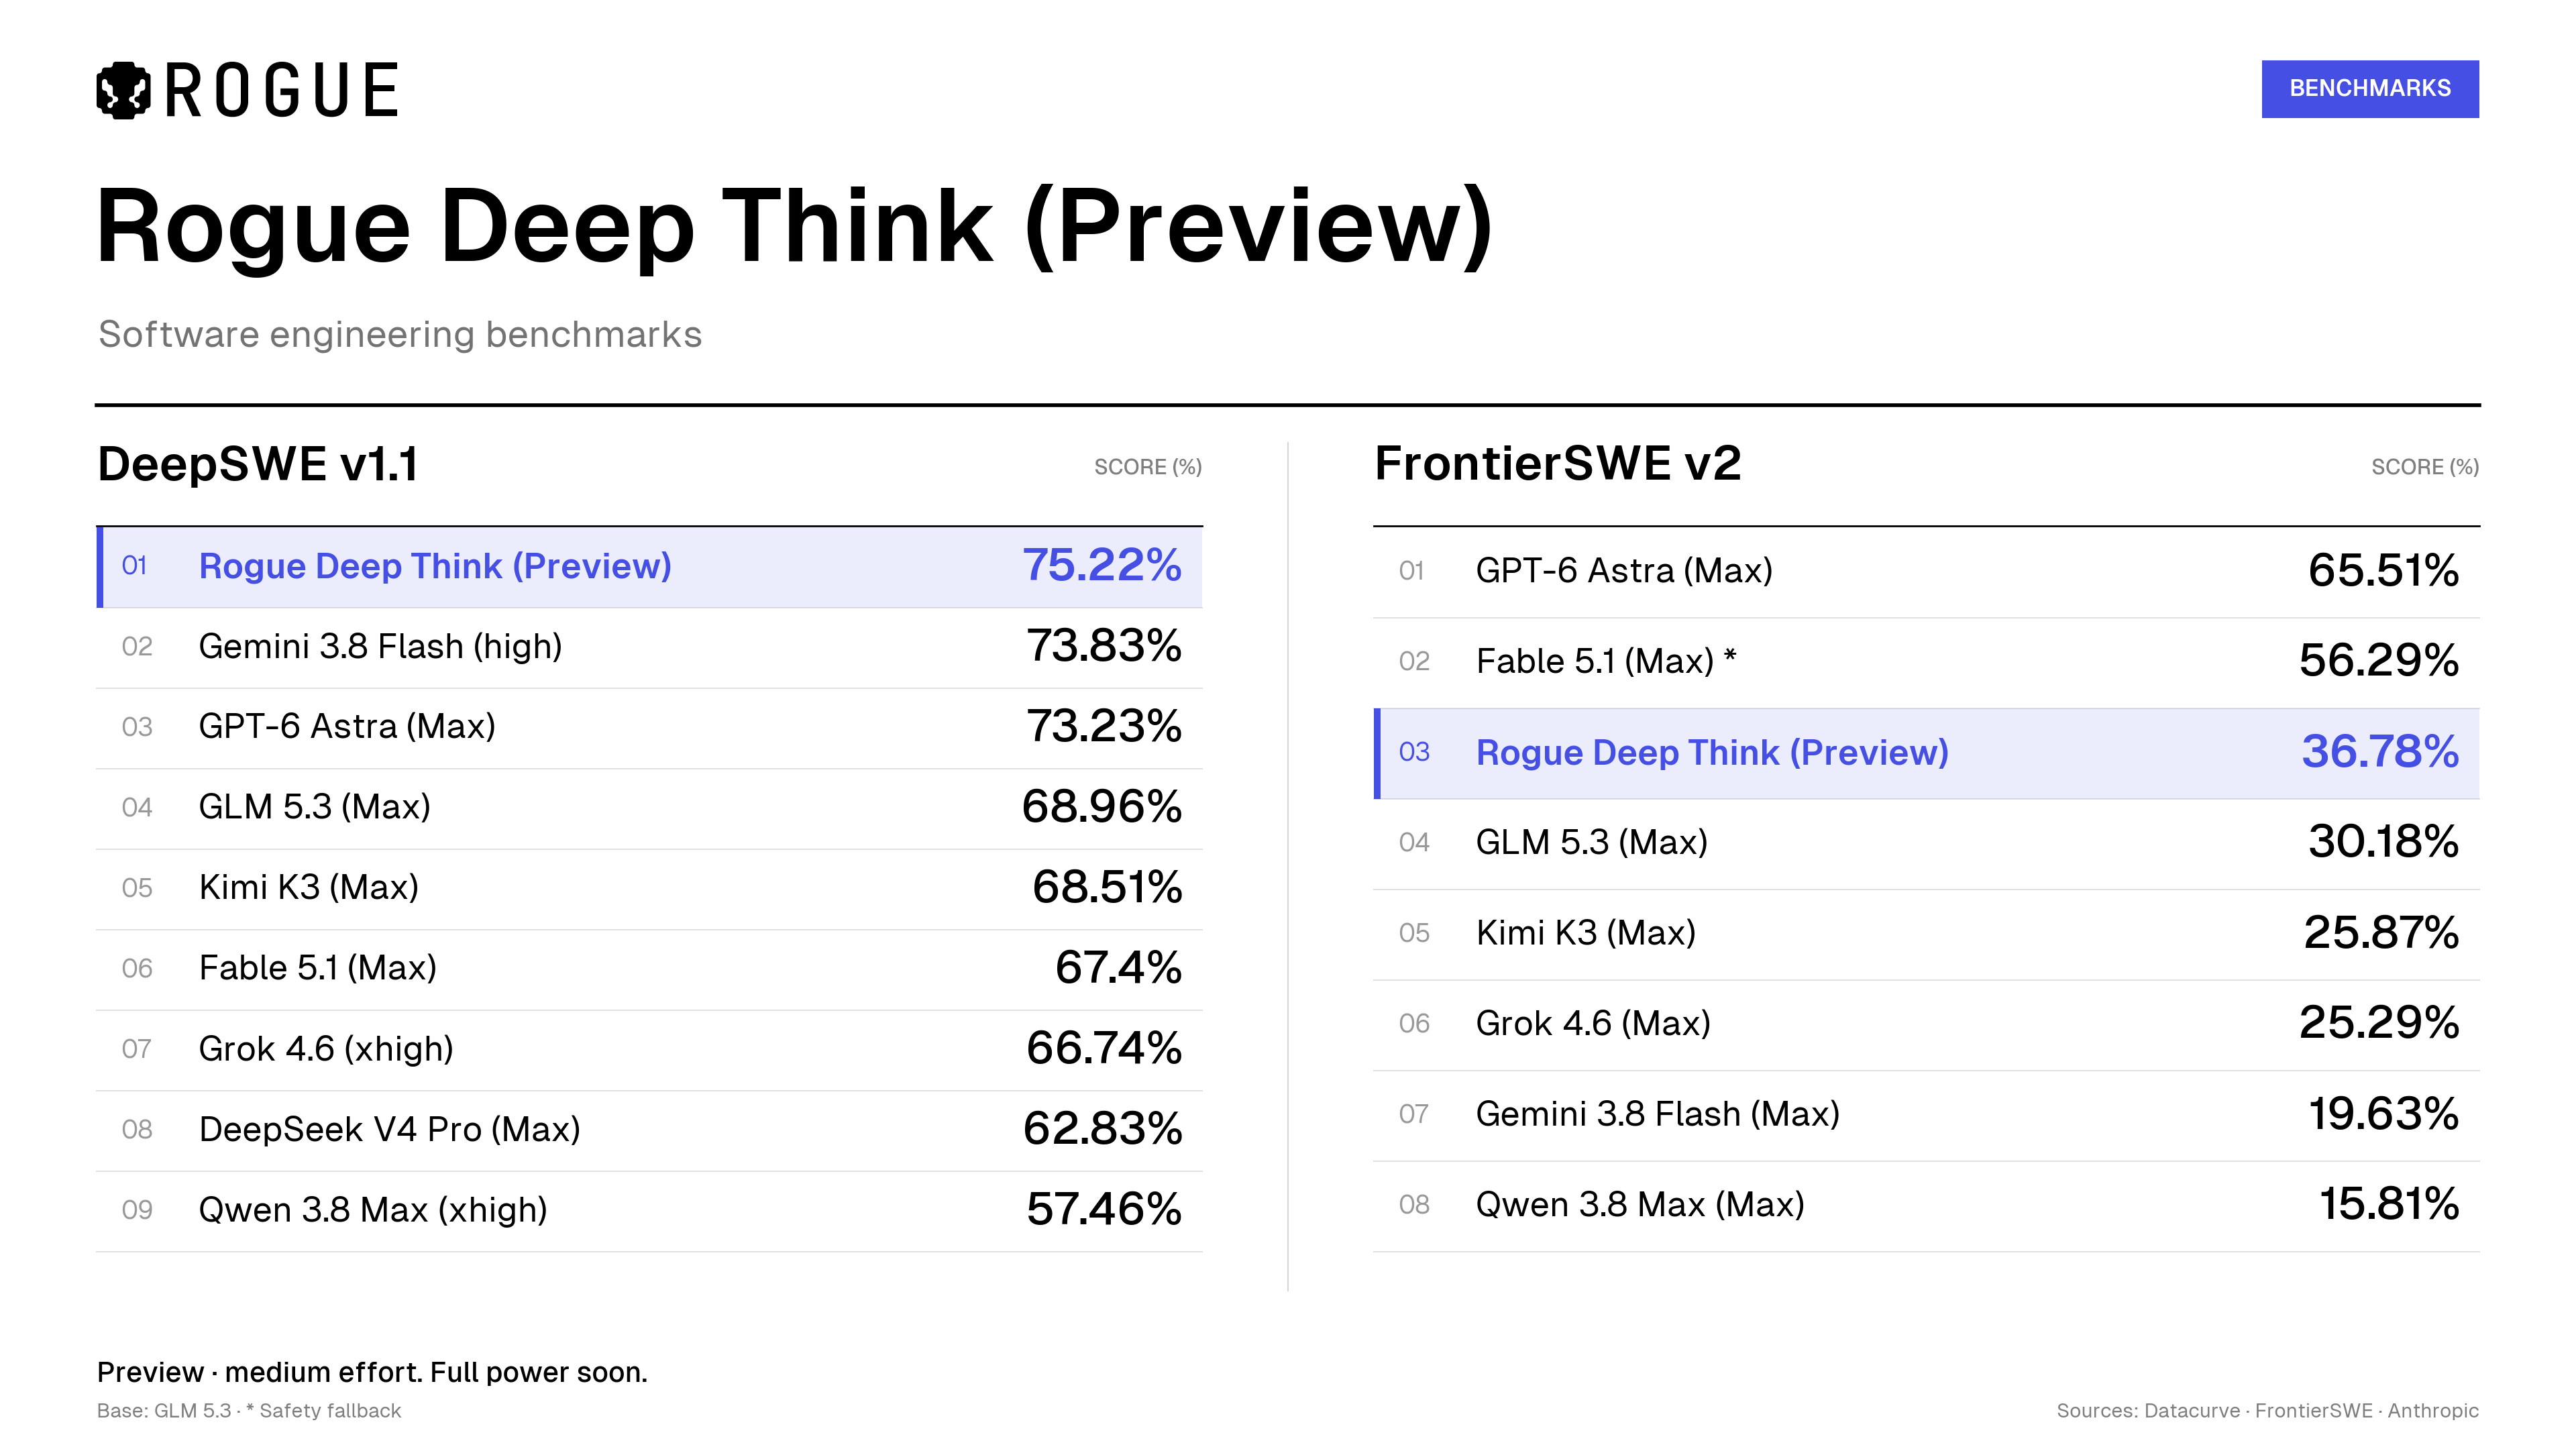
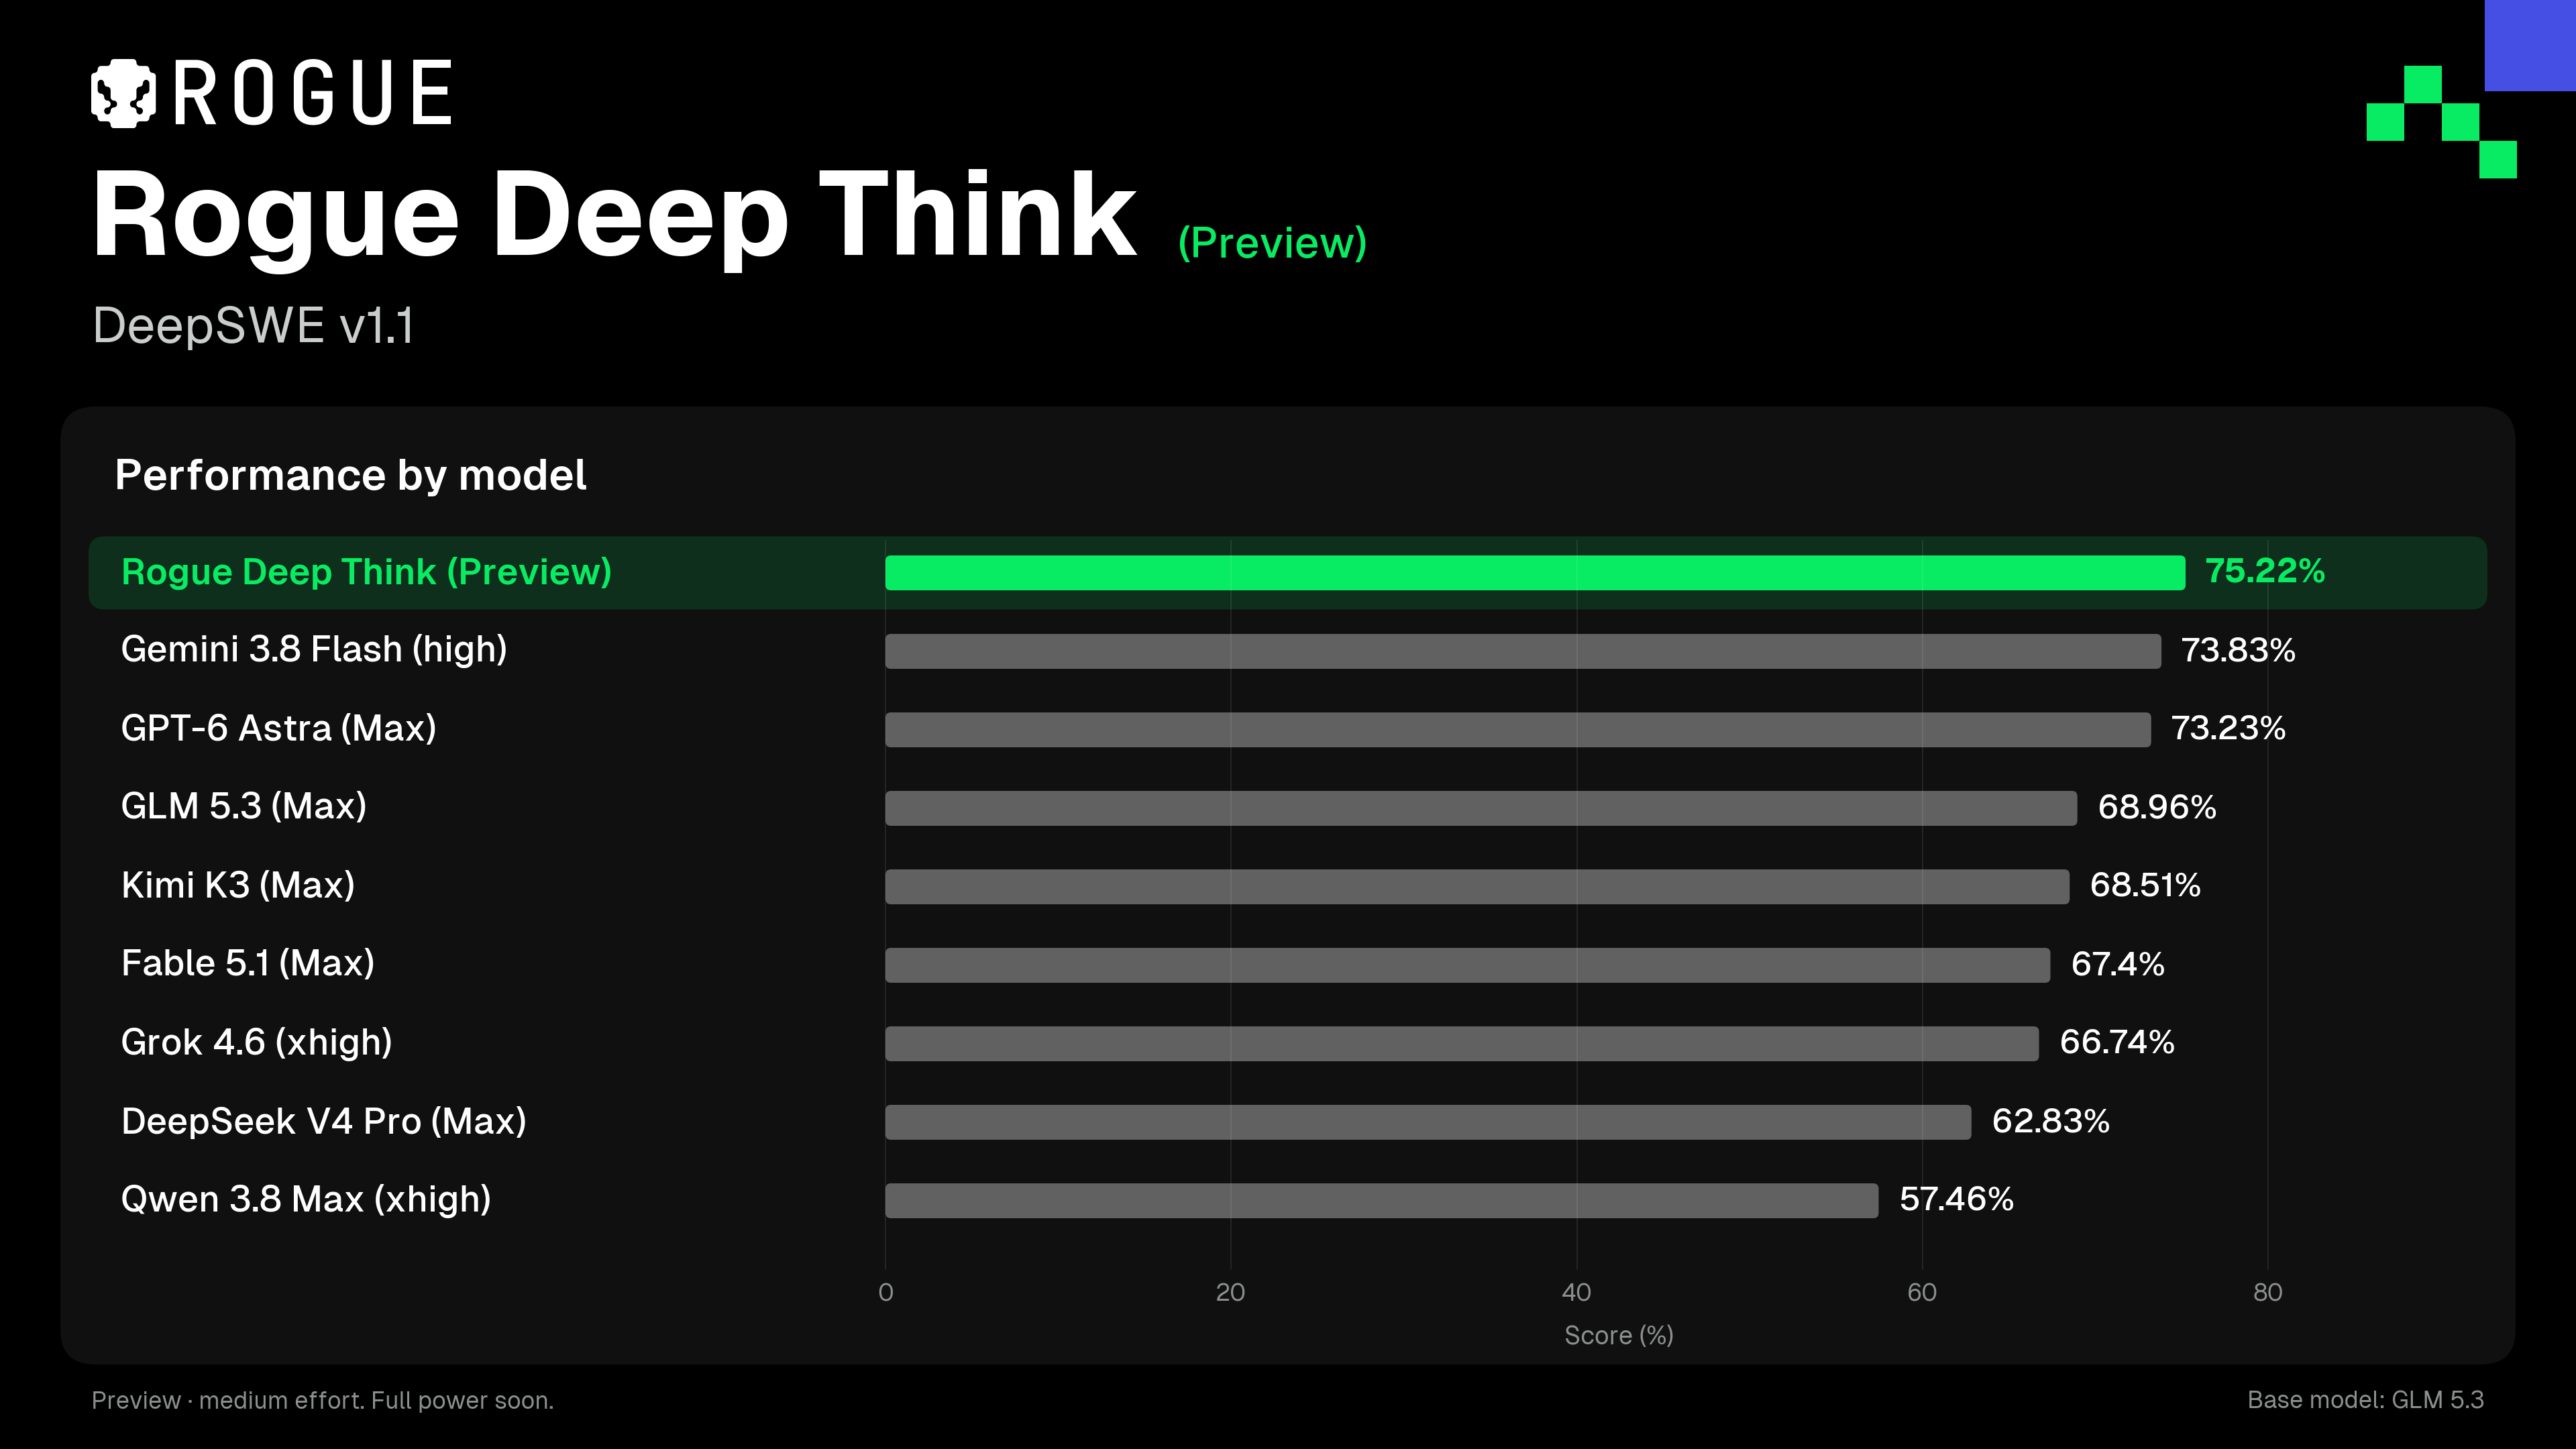
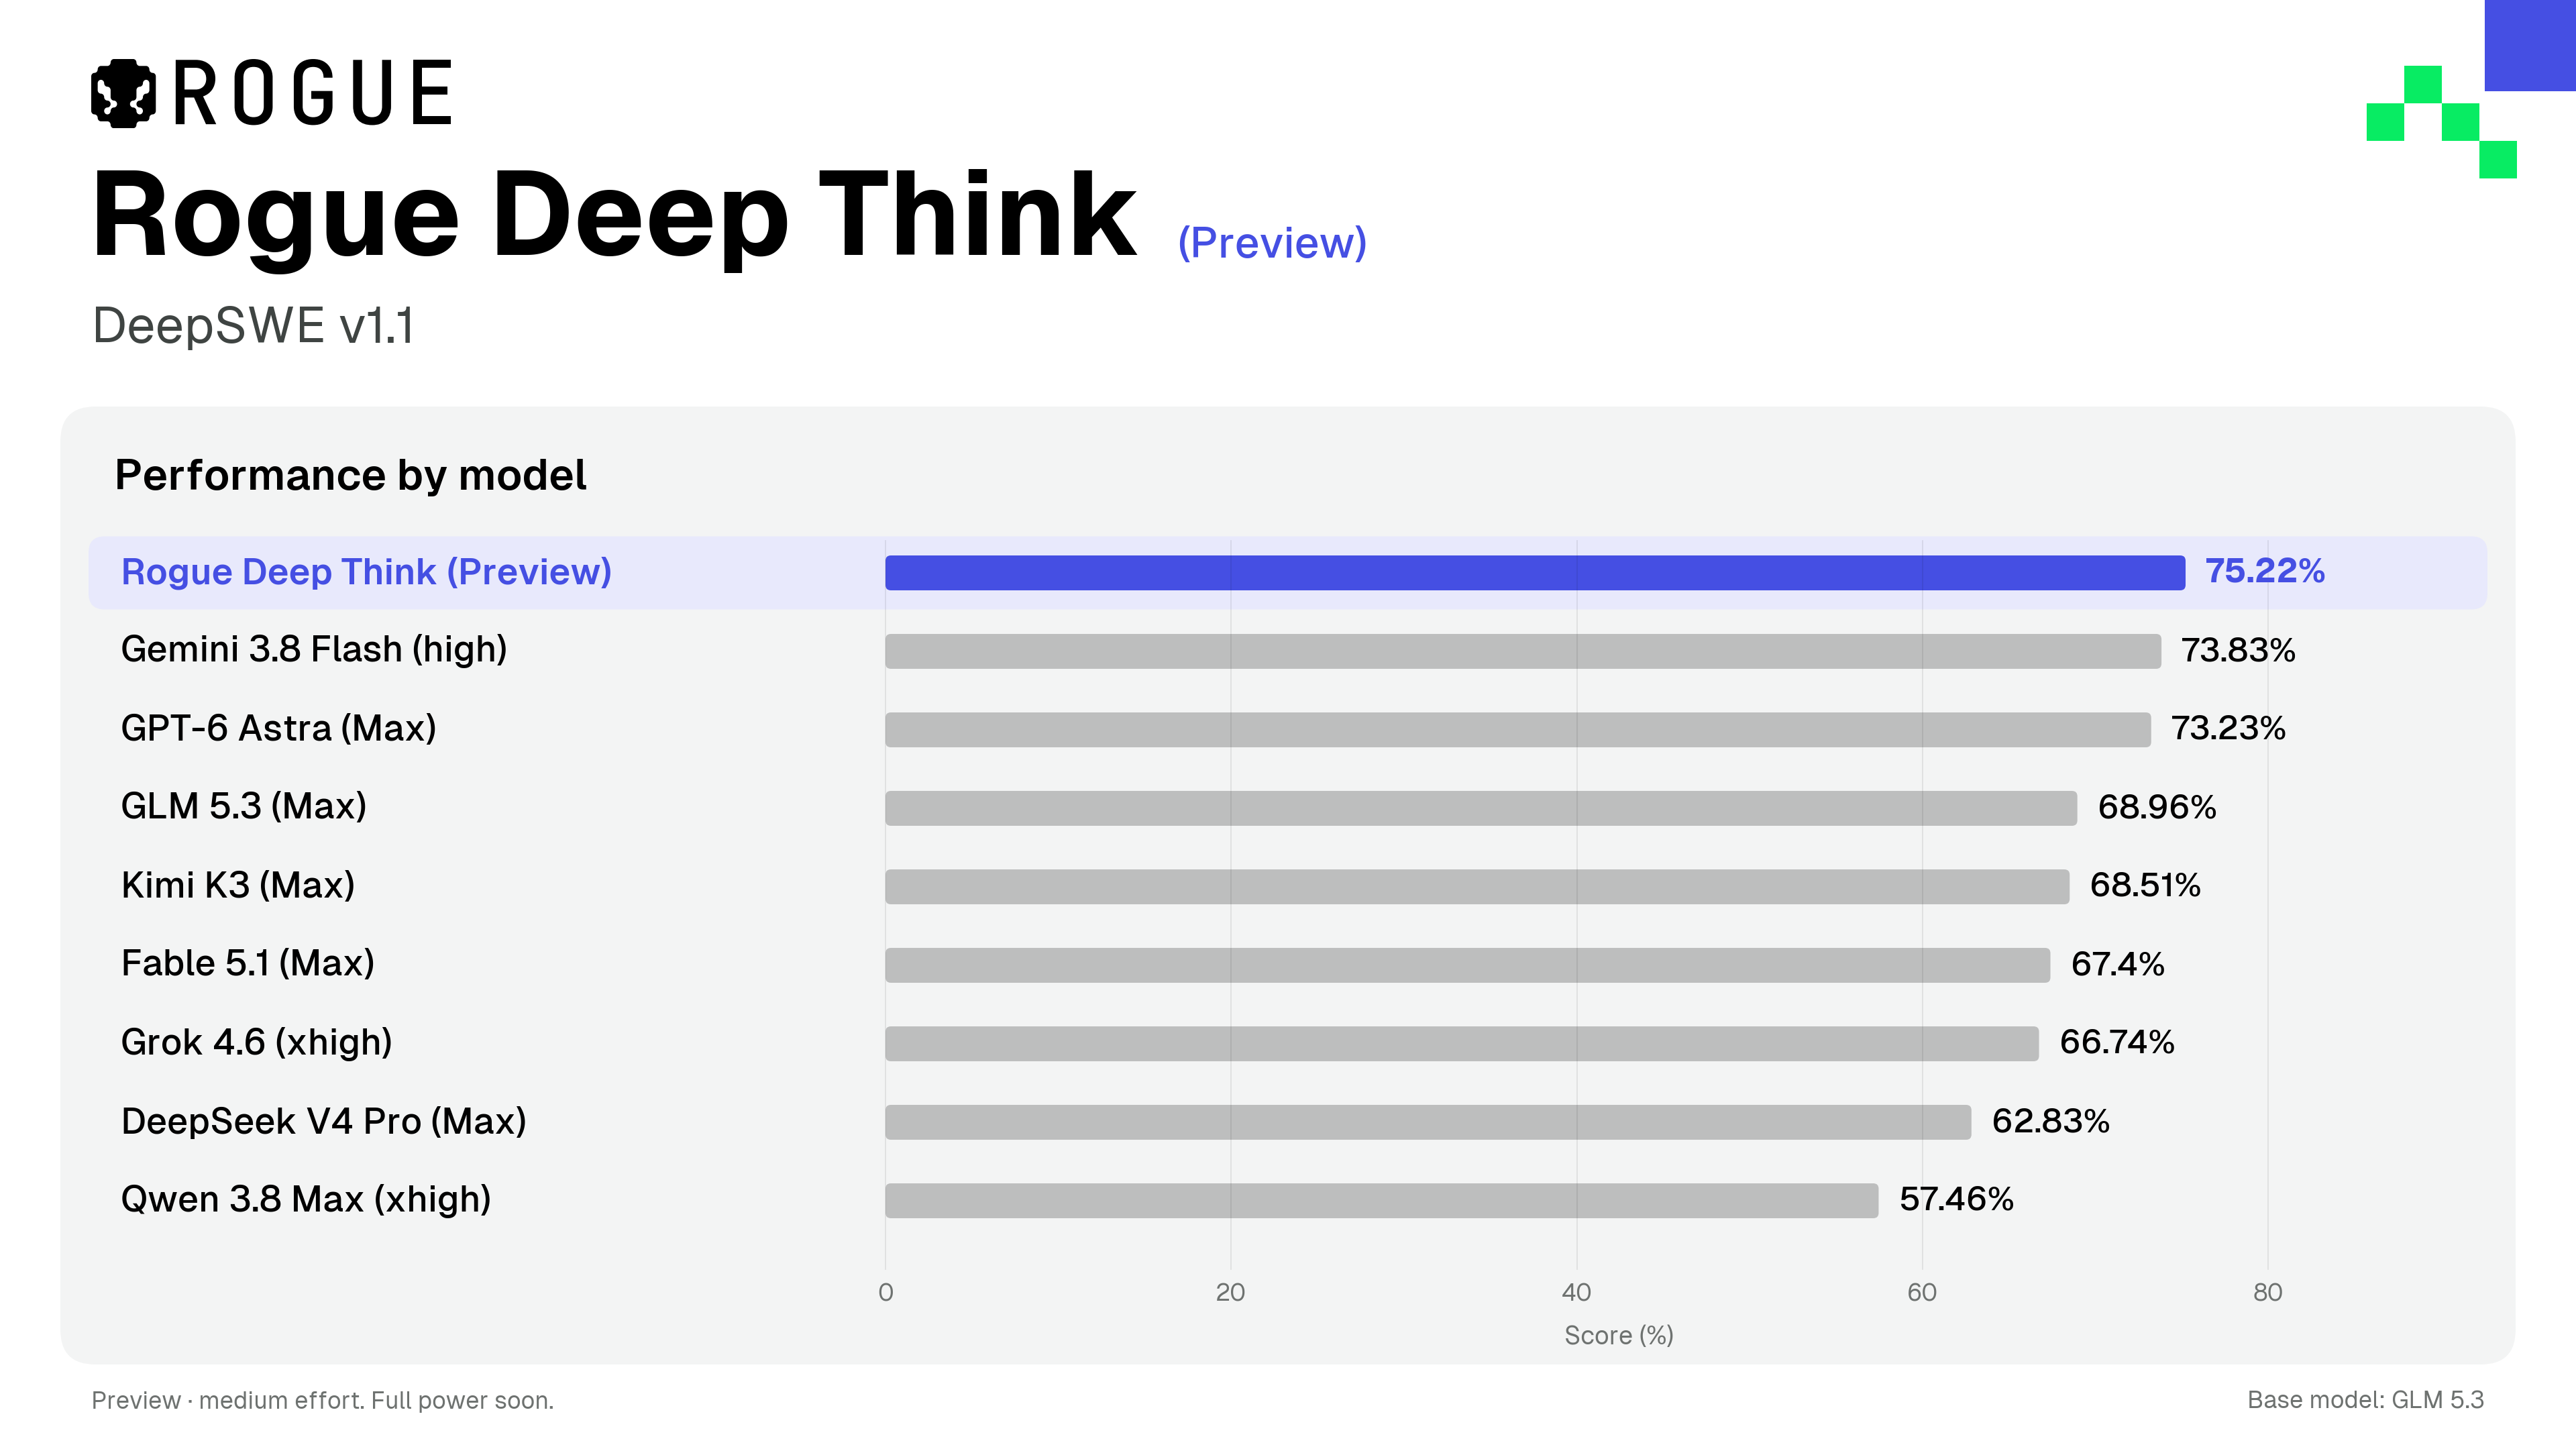
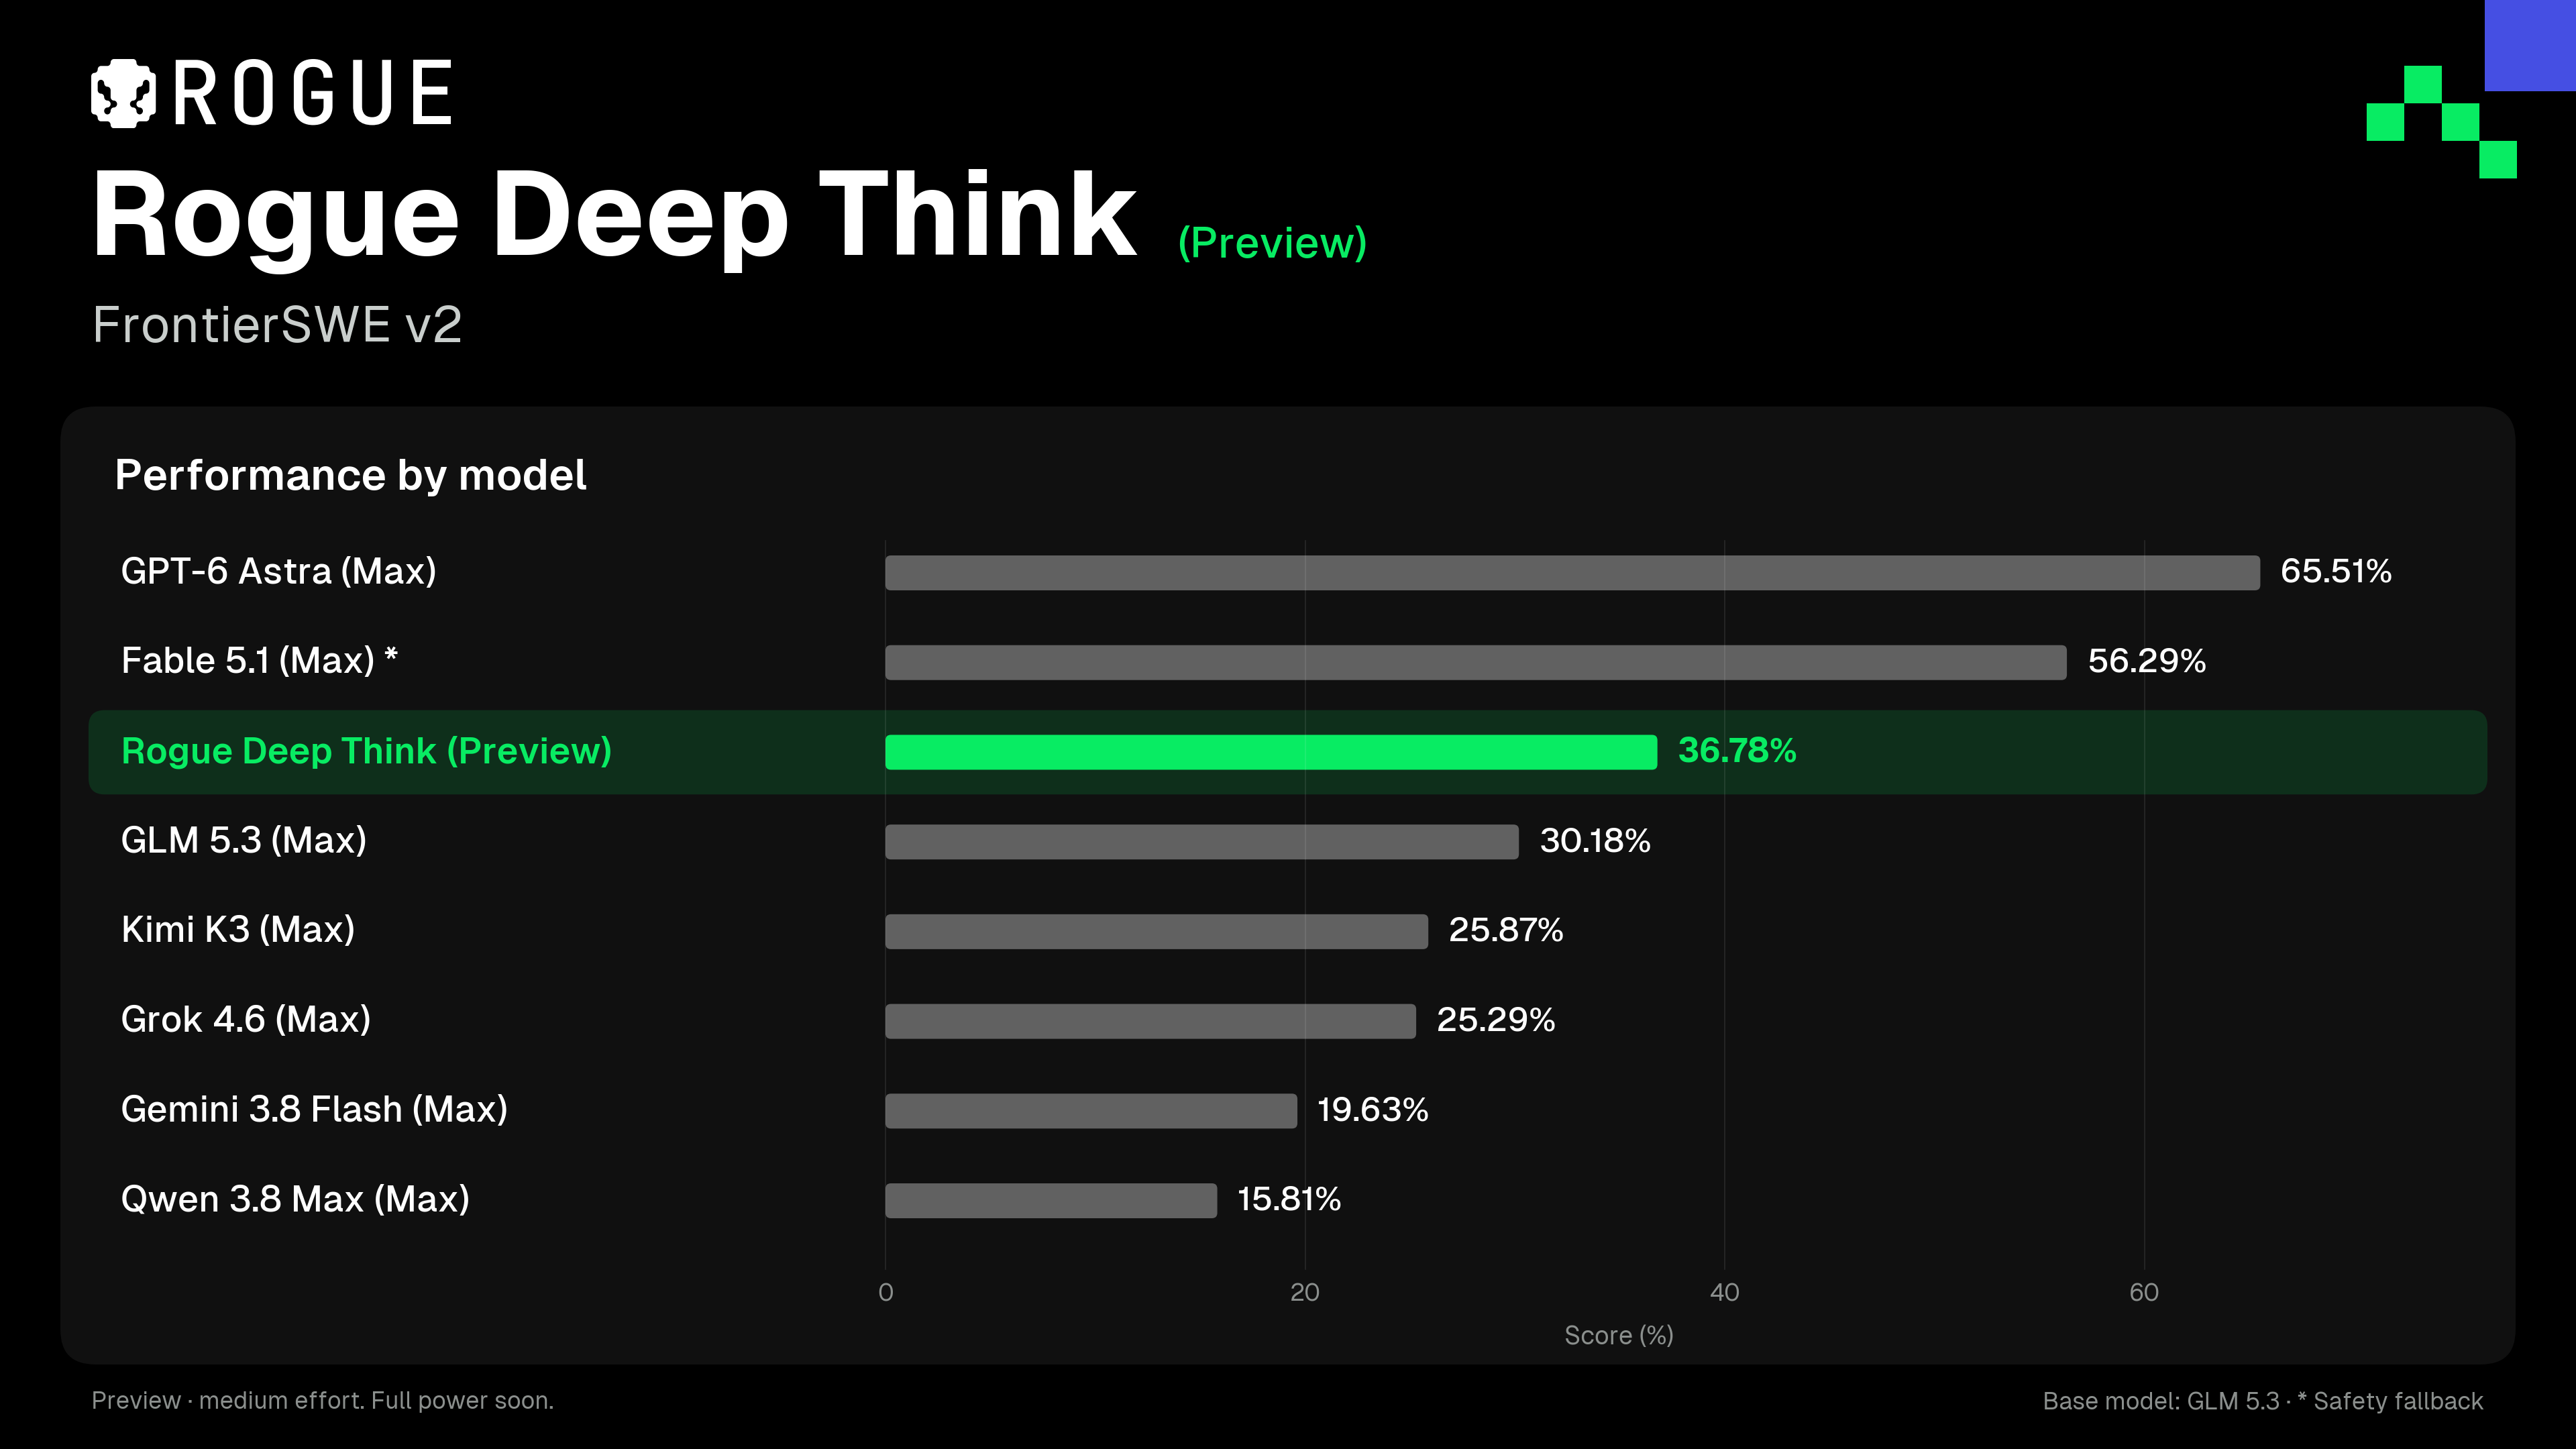
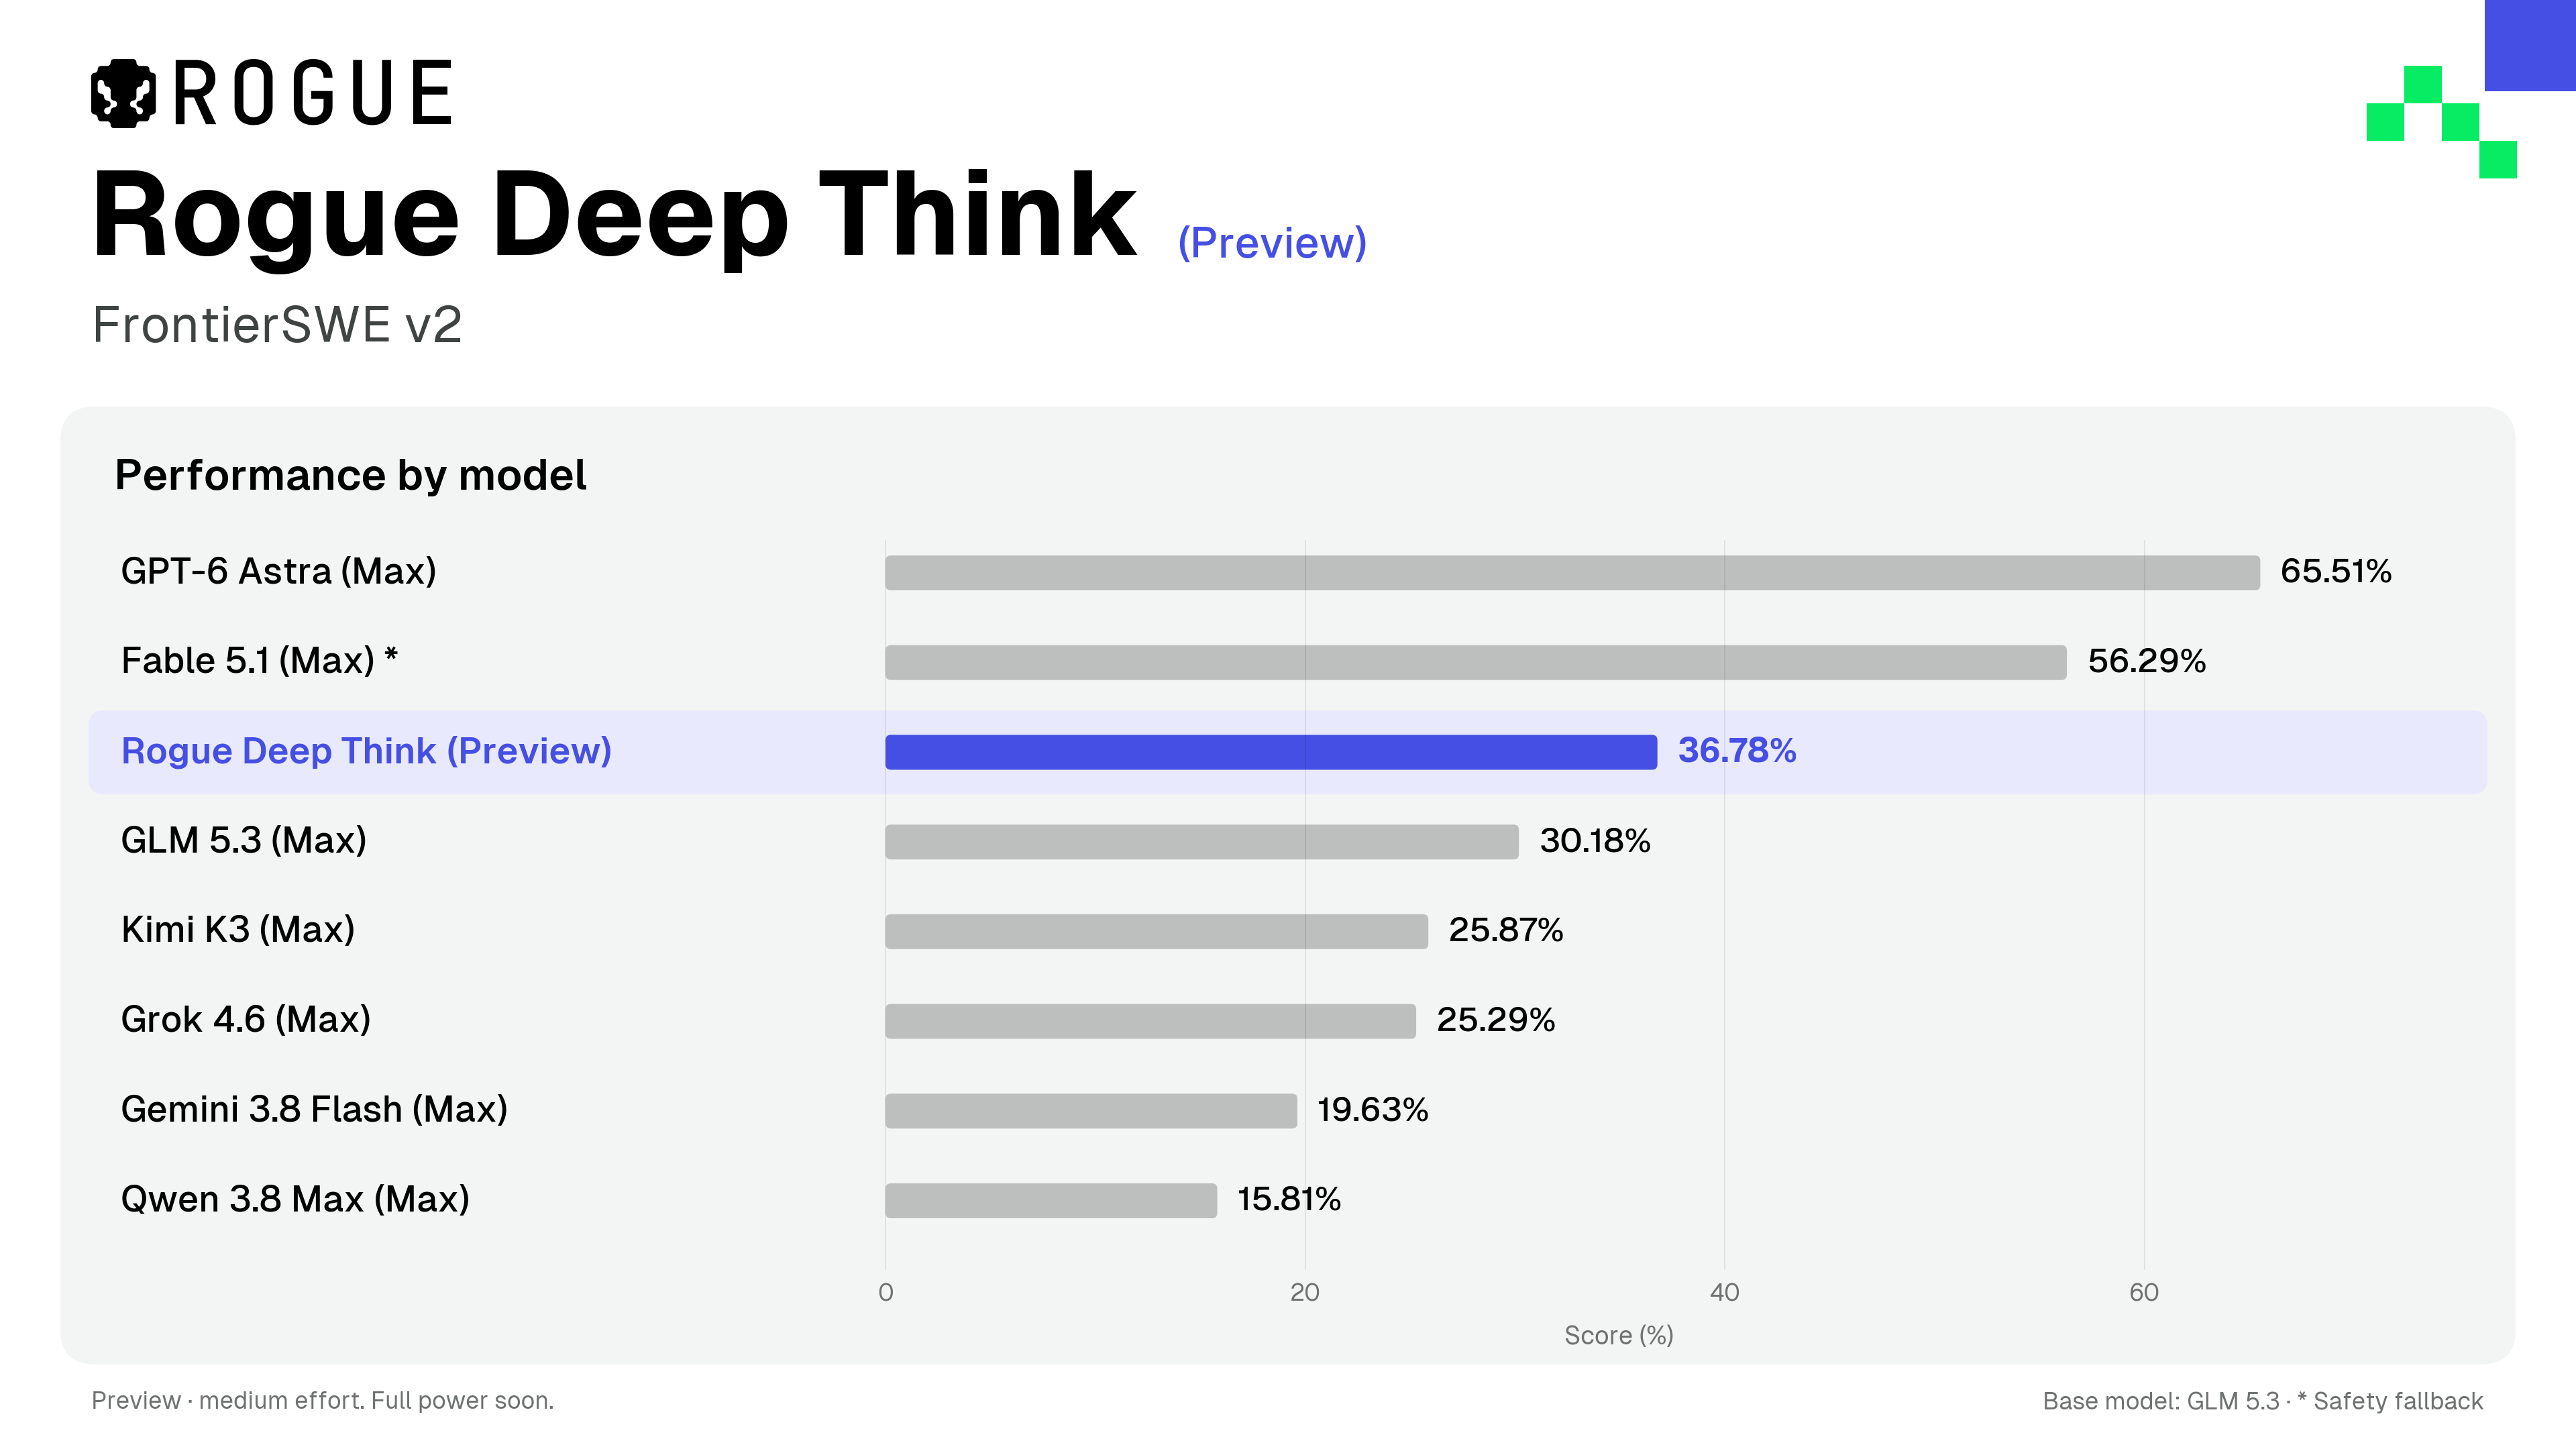
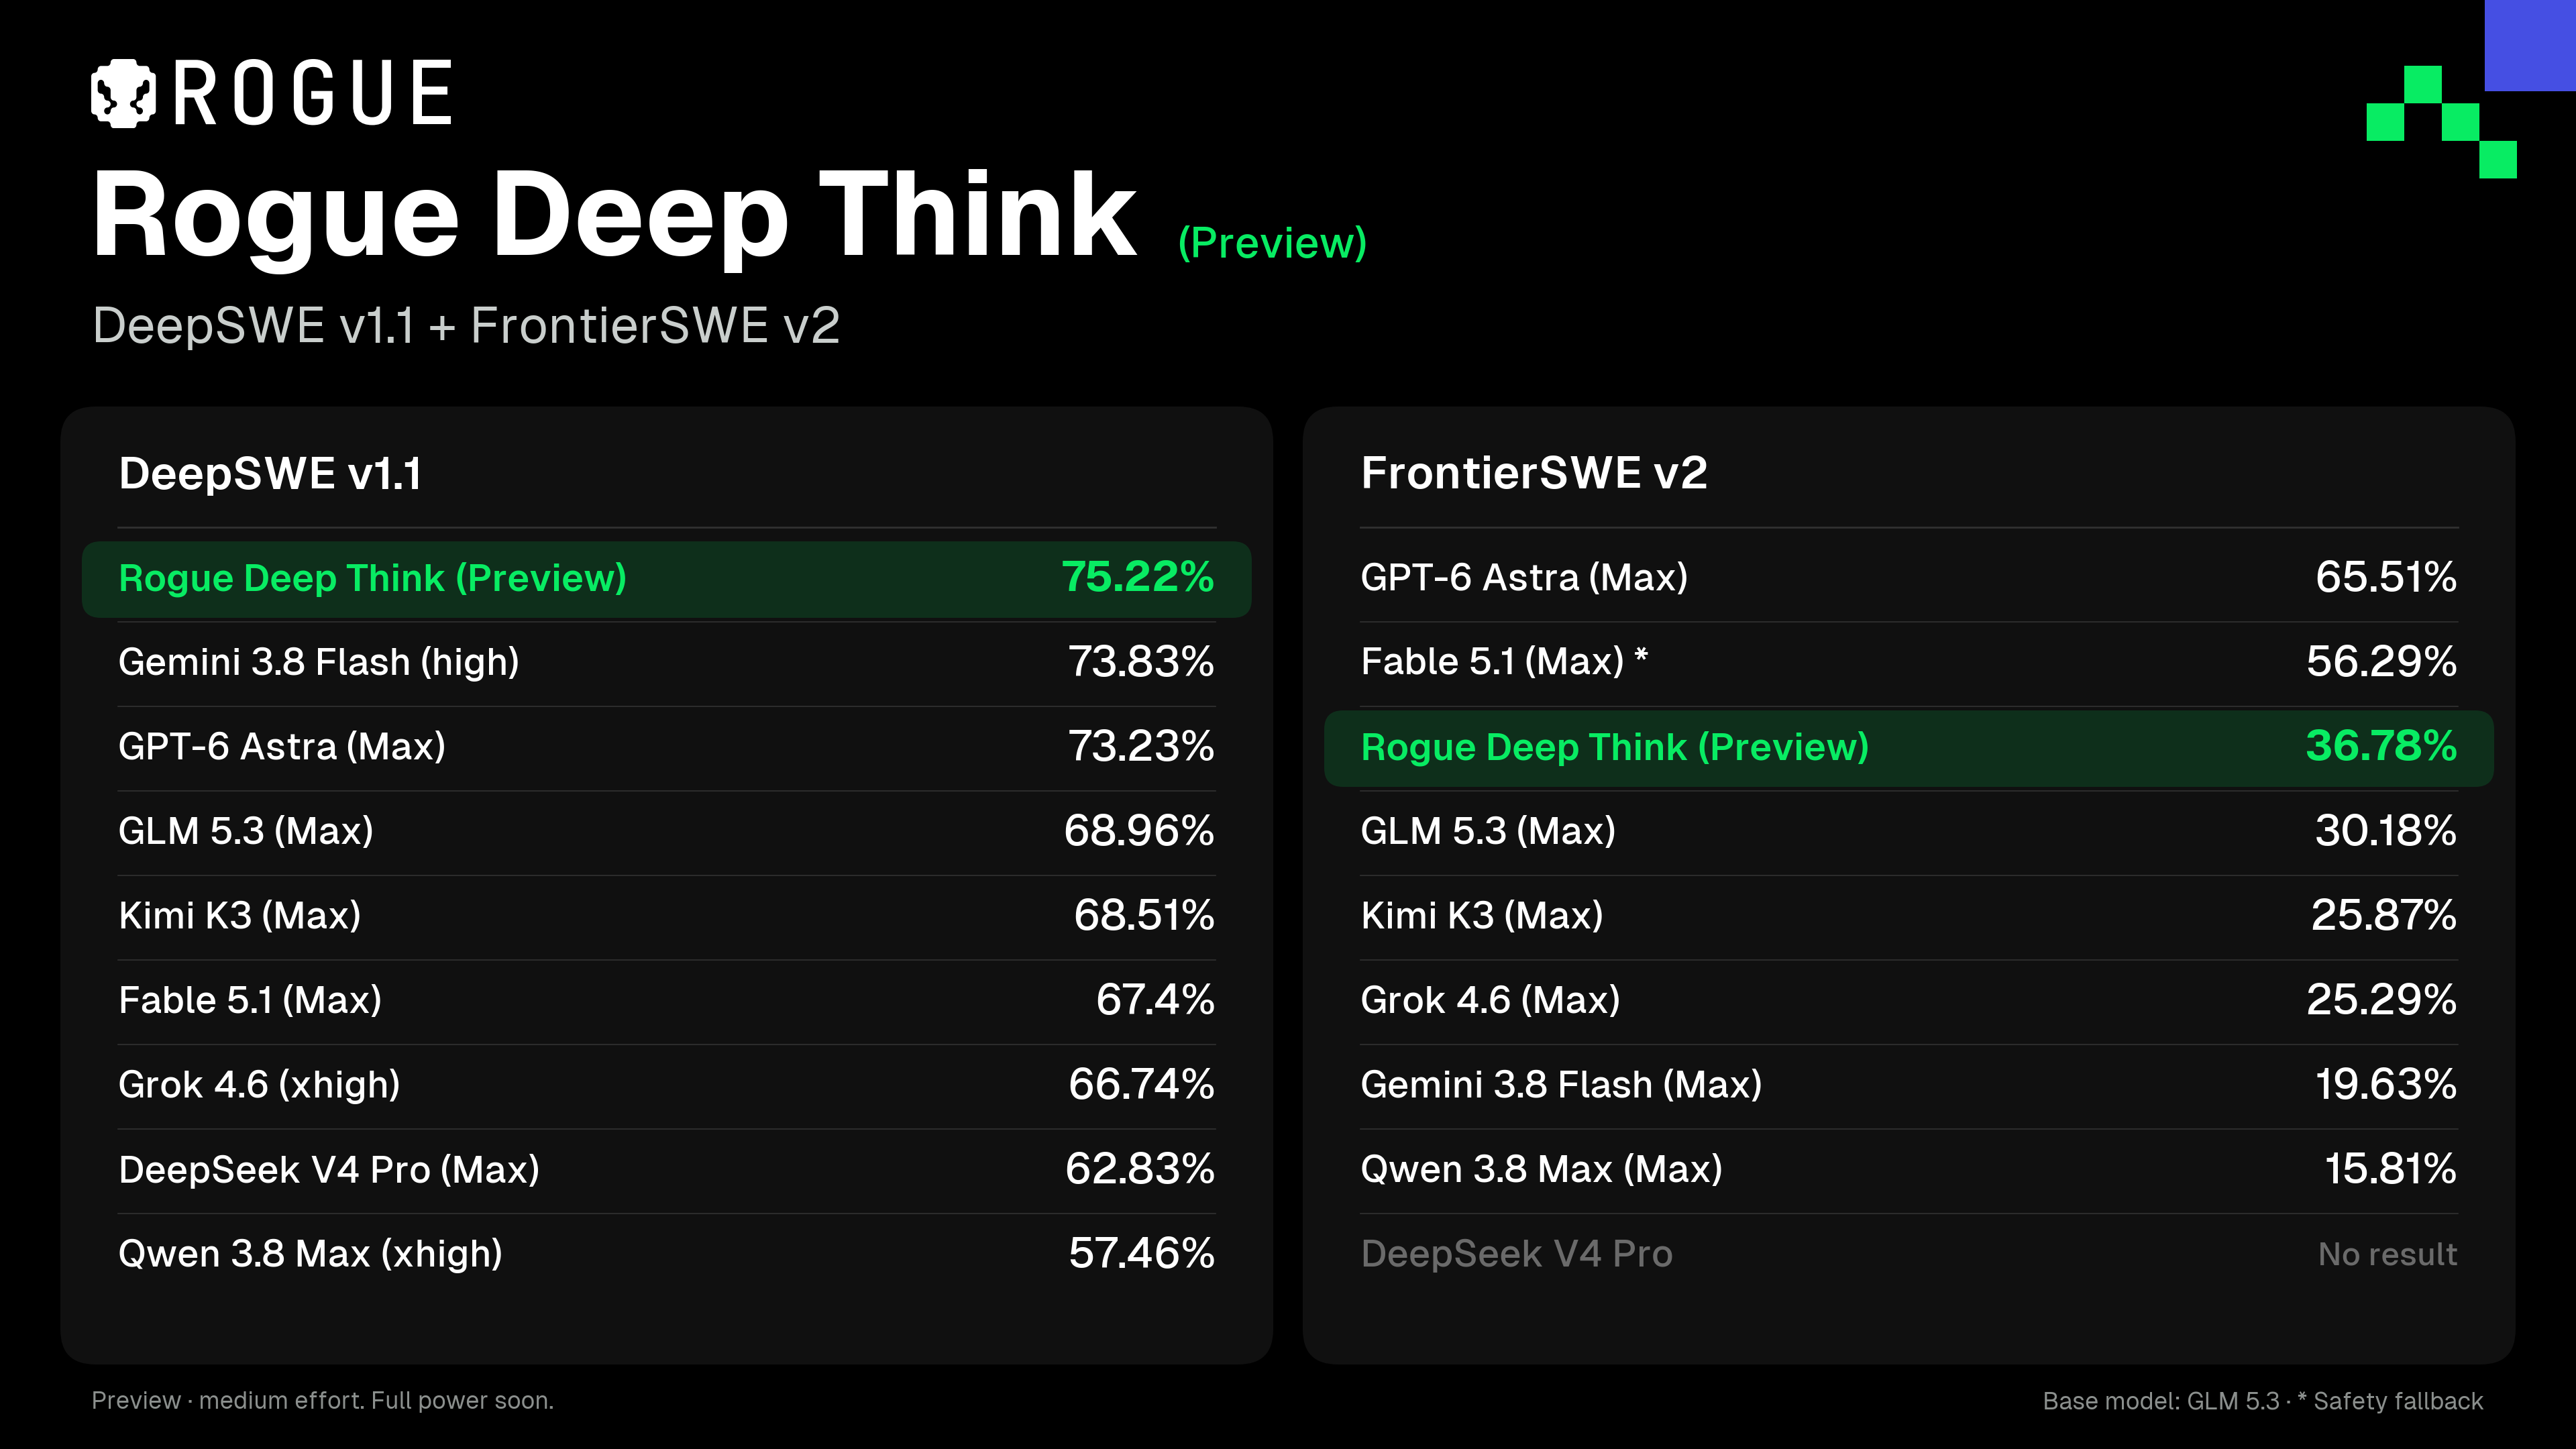
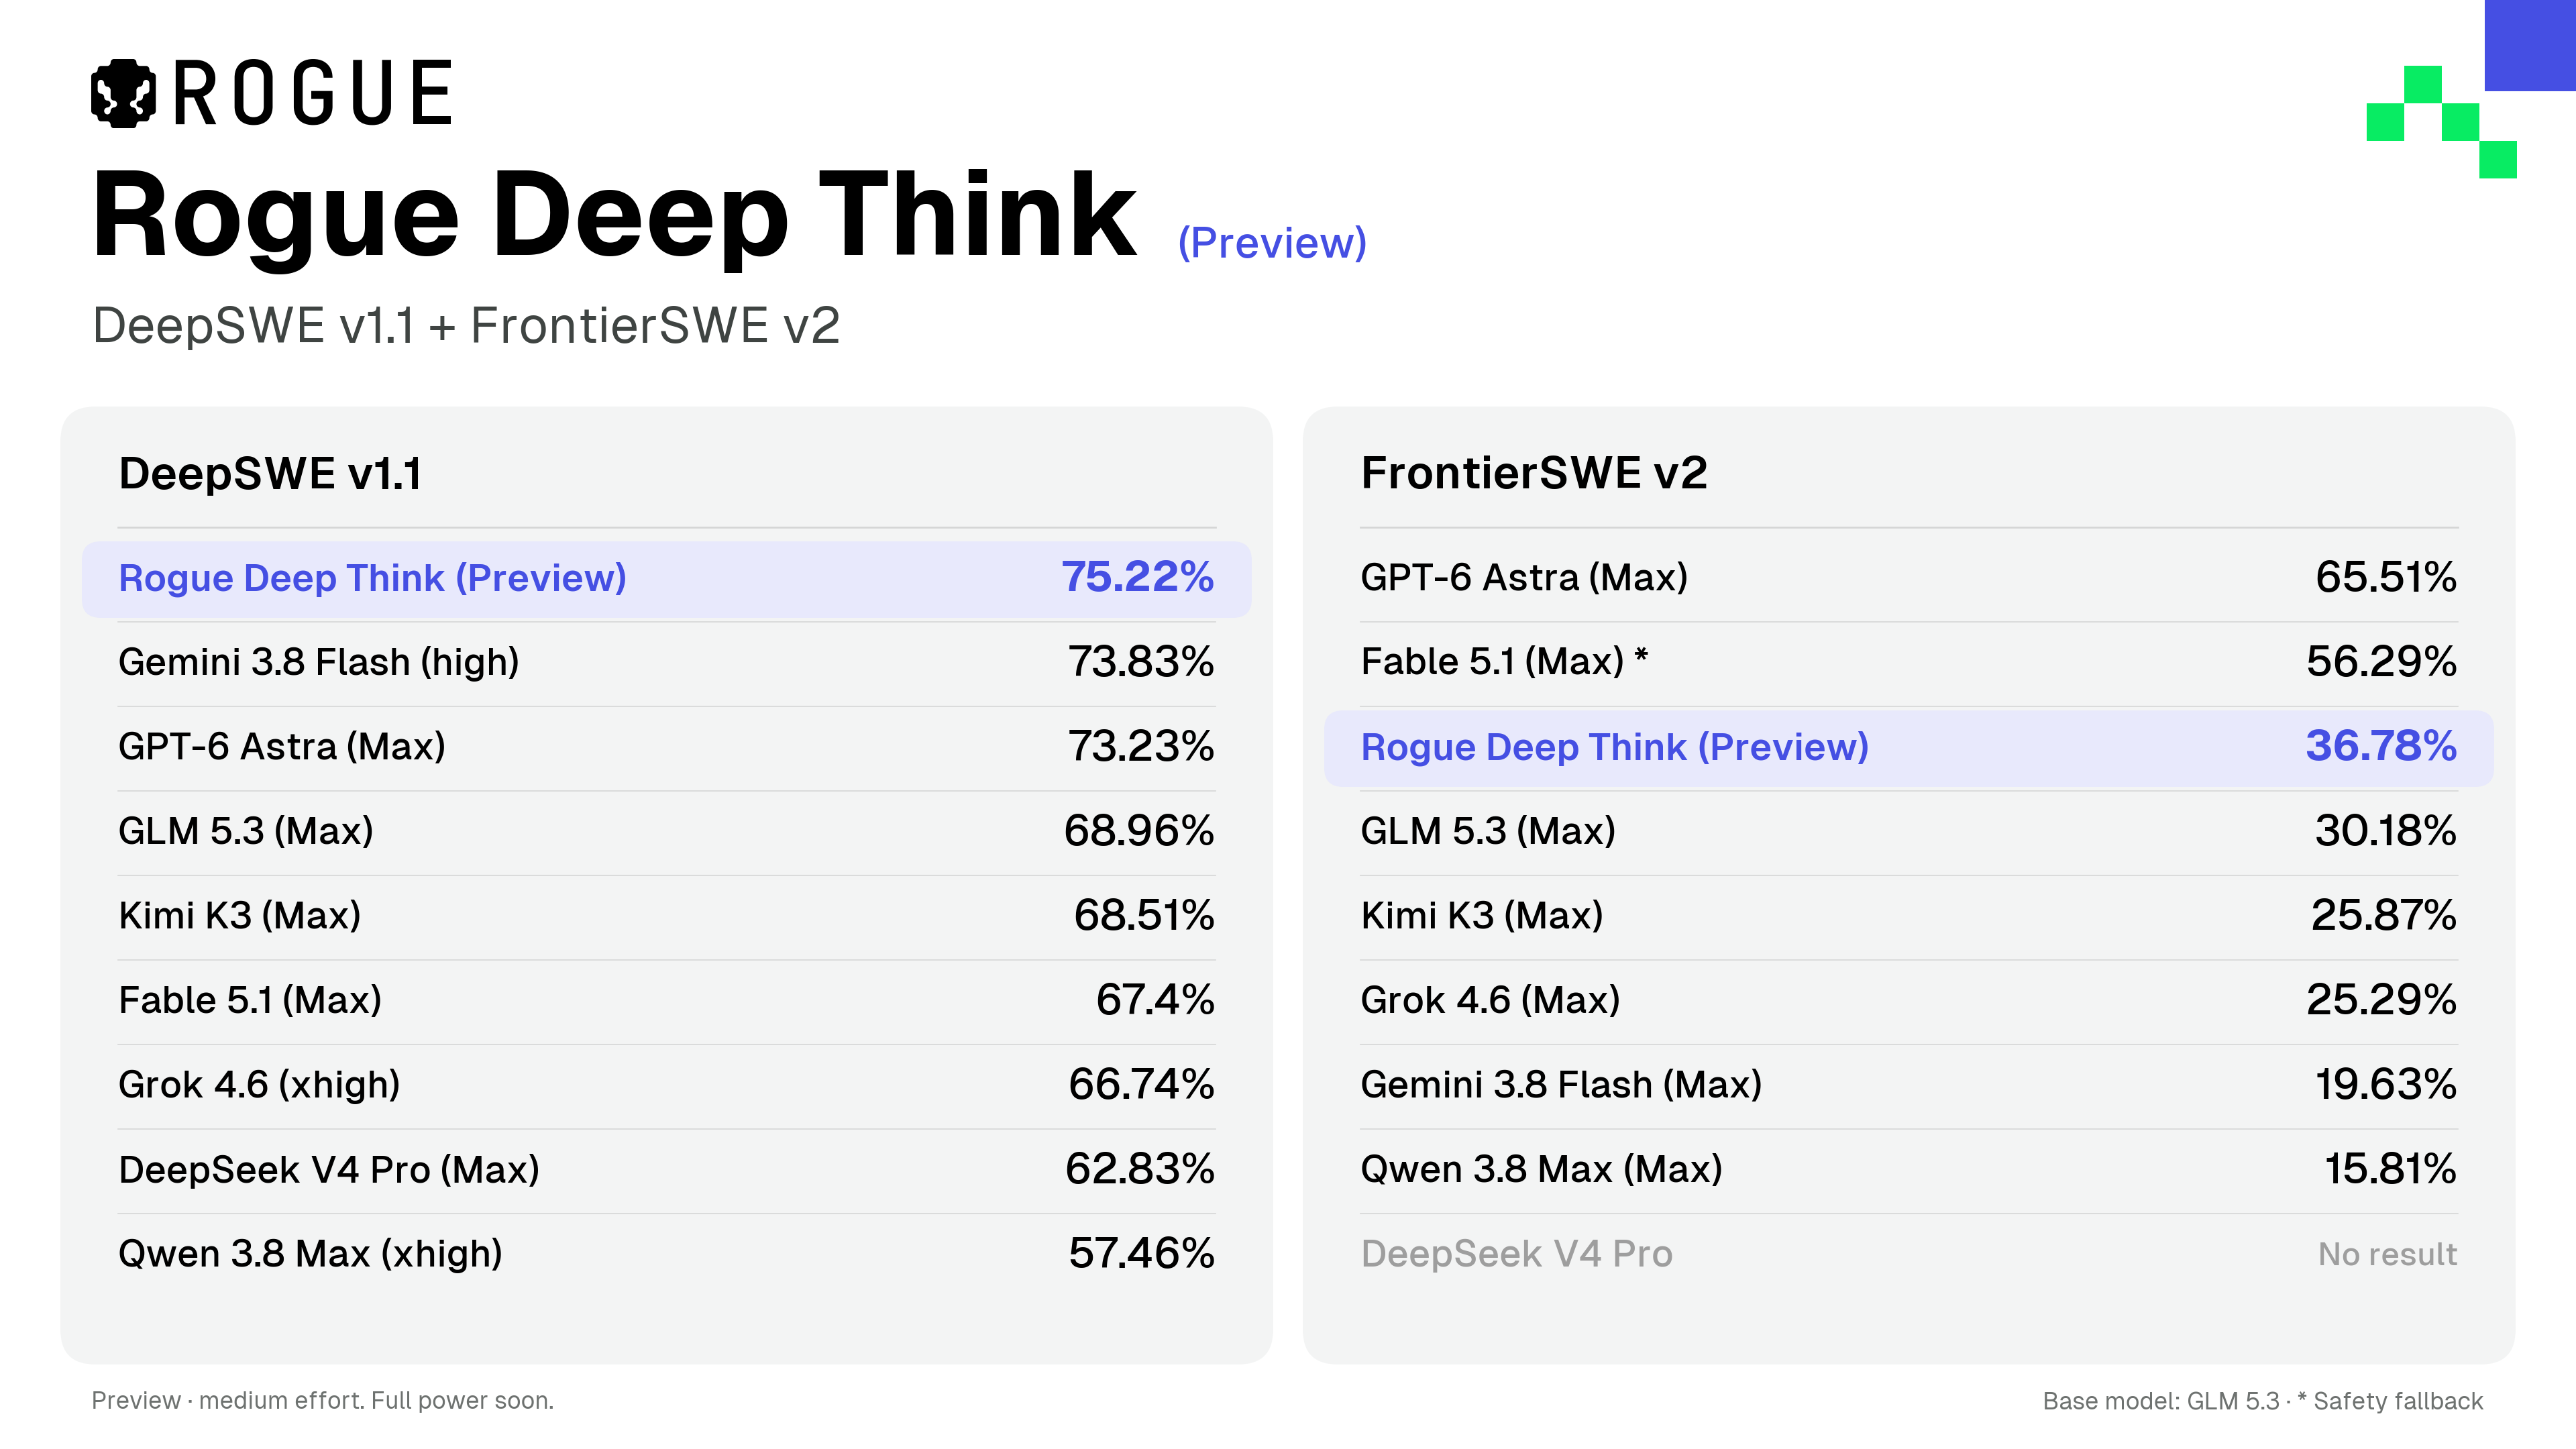
Nesta primeira versão, medida em medium effort, o Preview fez 75,22% no DeepSWE v1.1 e 36,78% no FrontierSWE v2. No DeepSWE, a pontuação passa de todos os resultados publicados no placar público do benchmark, cujo maior valor hoje é 74,12%.
Os resultados
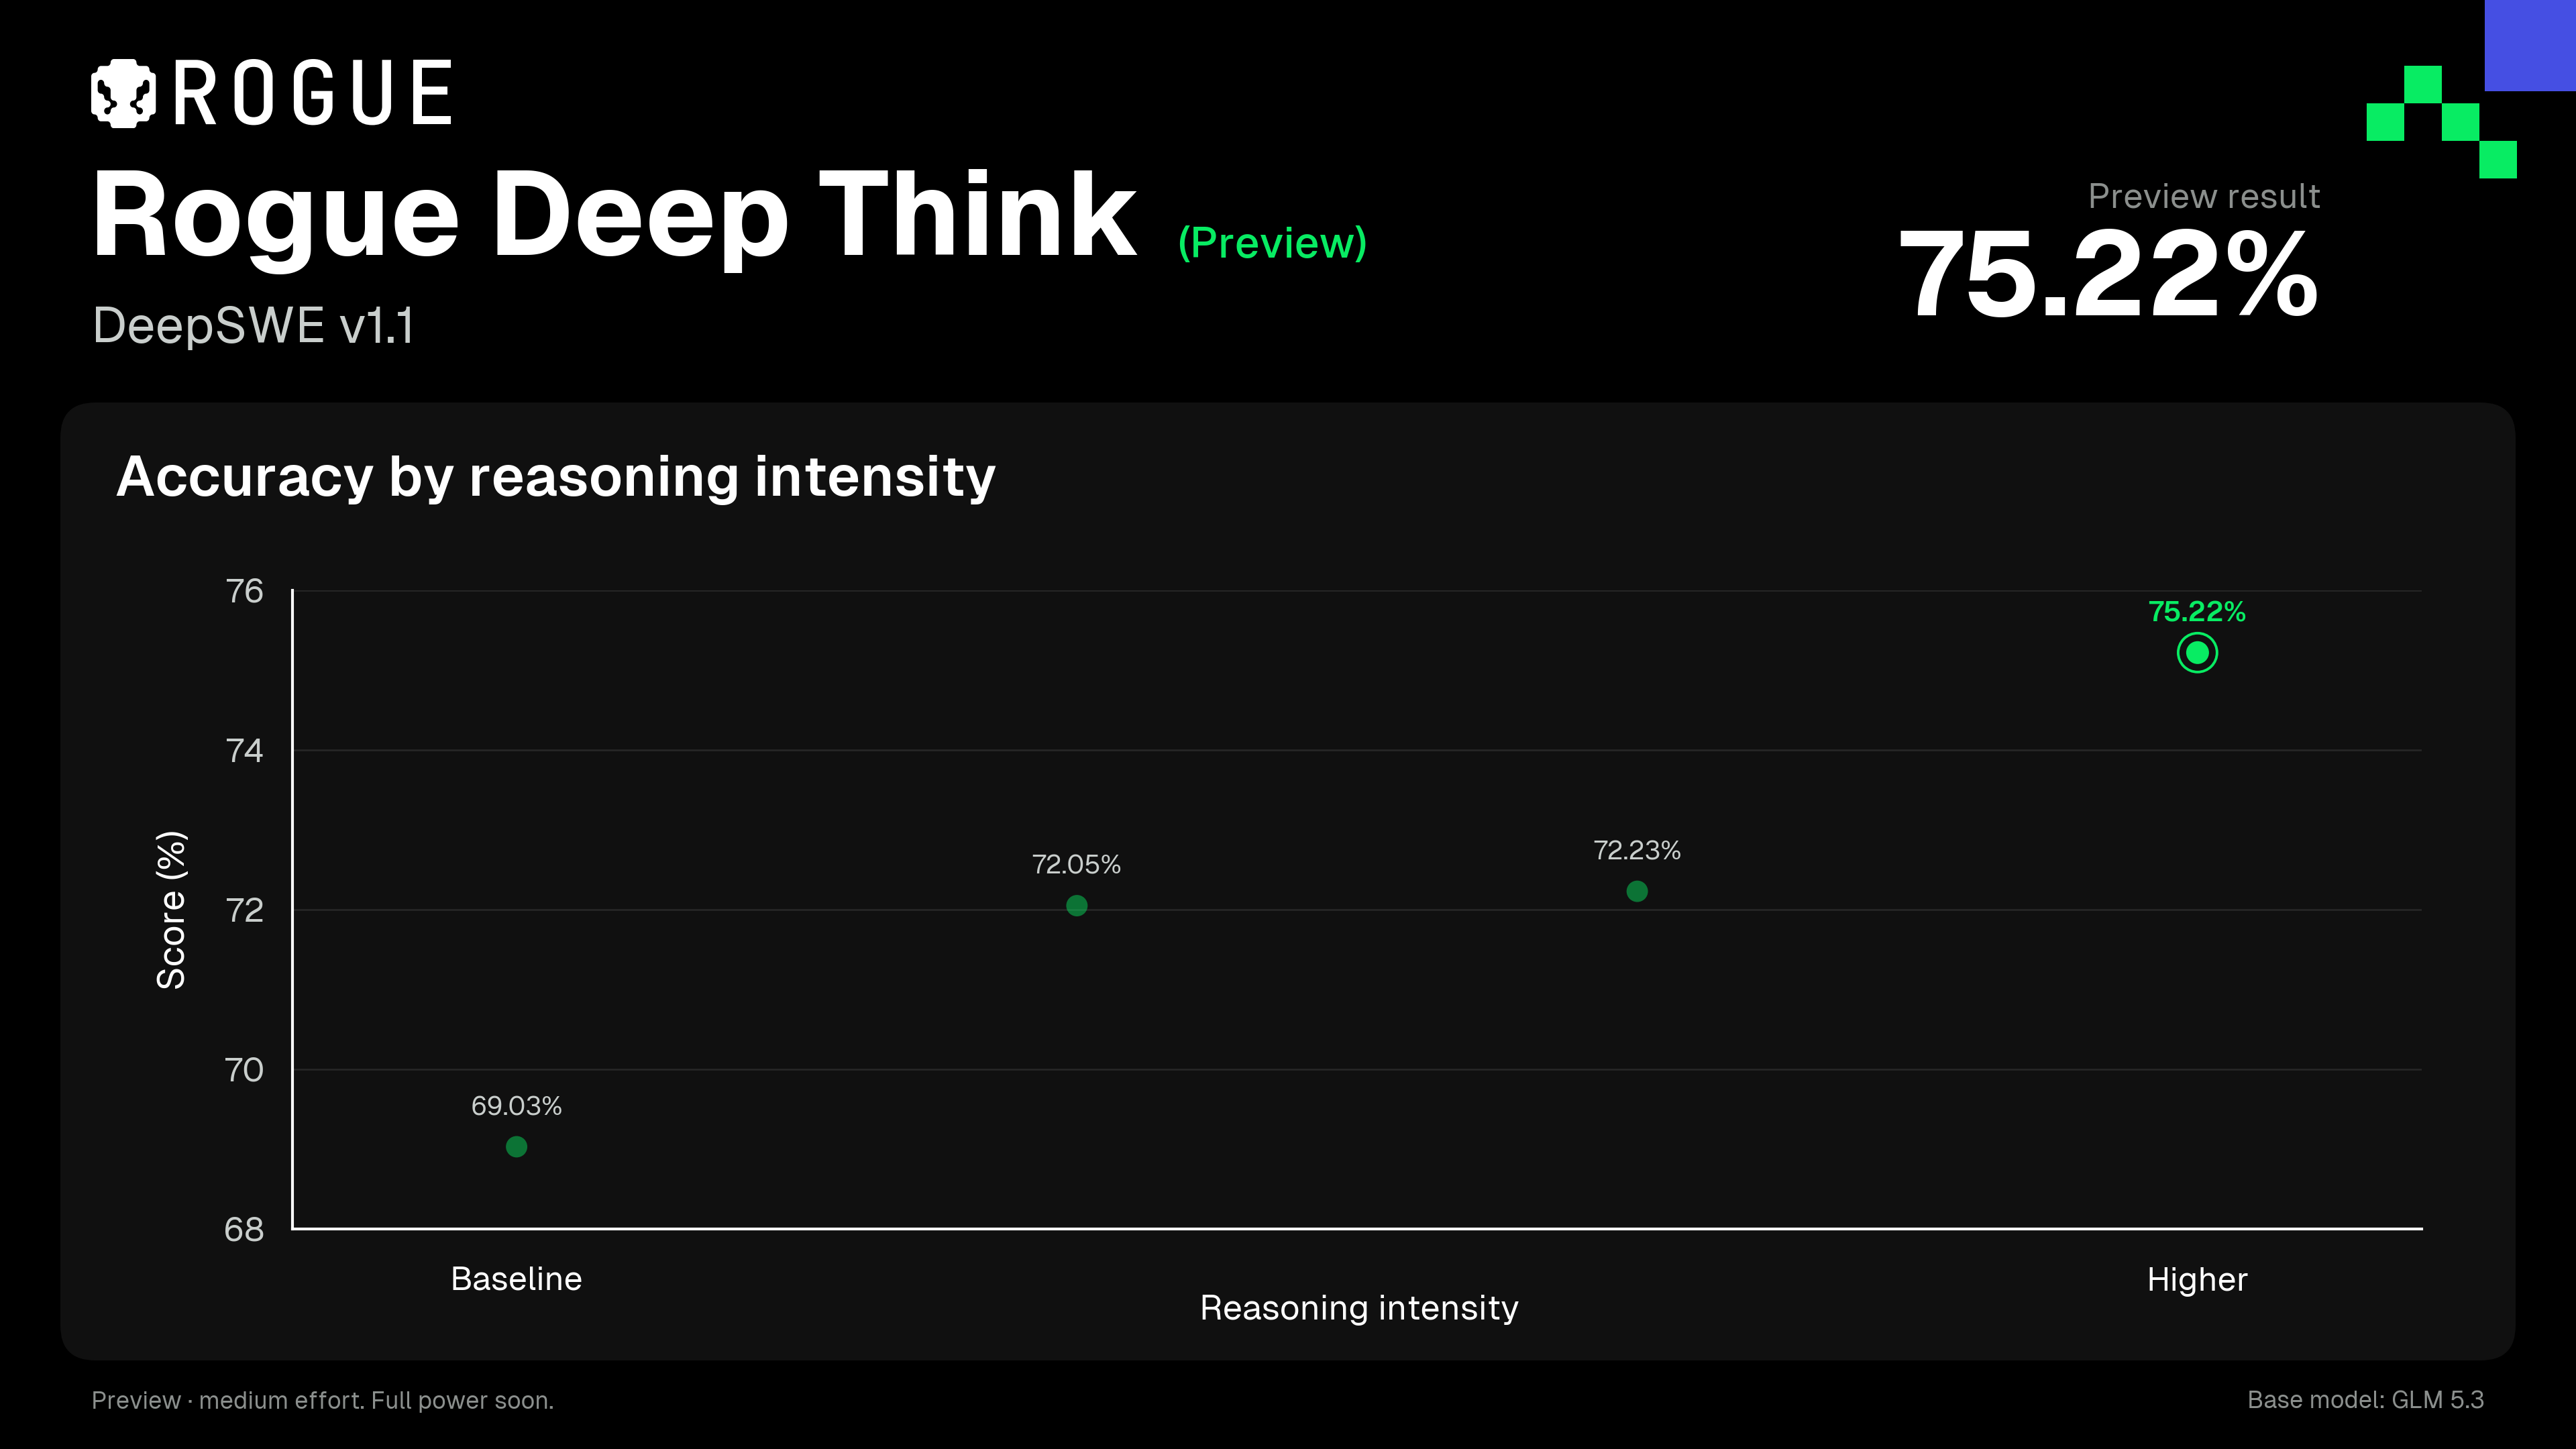
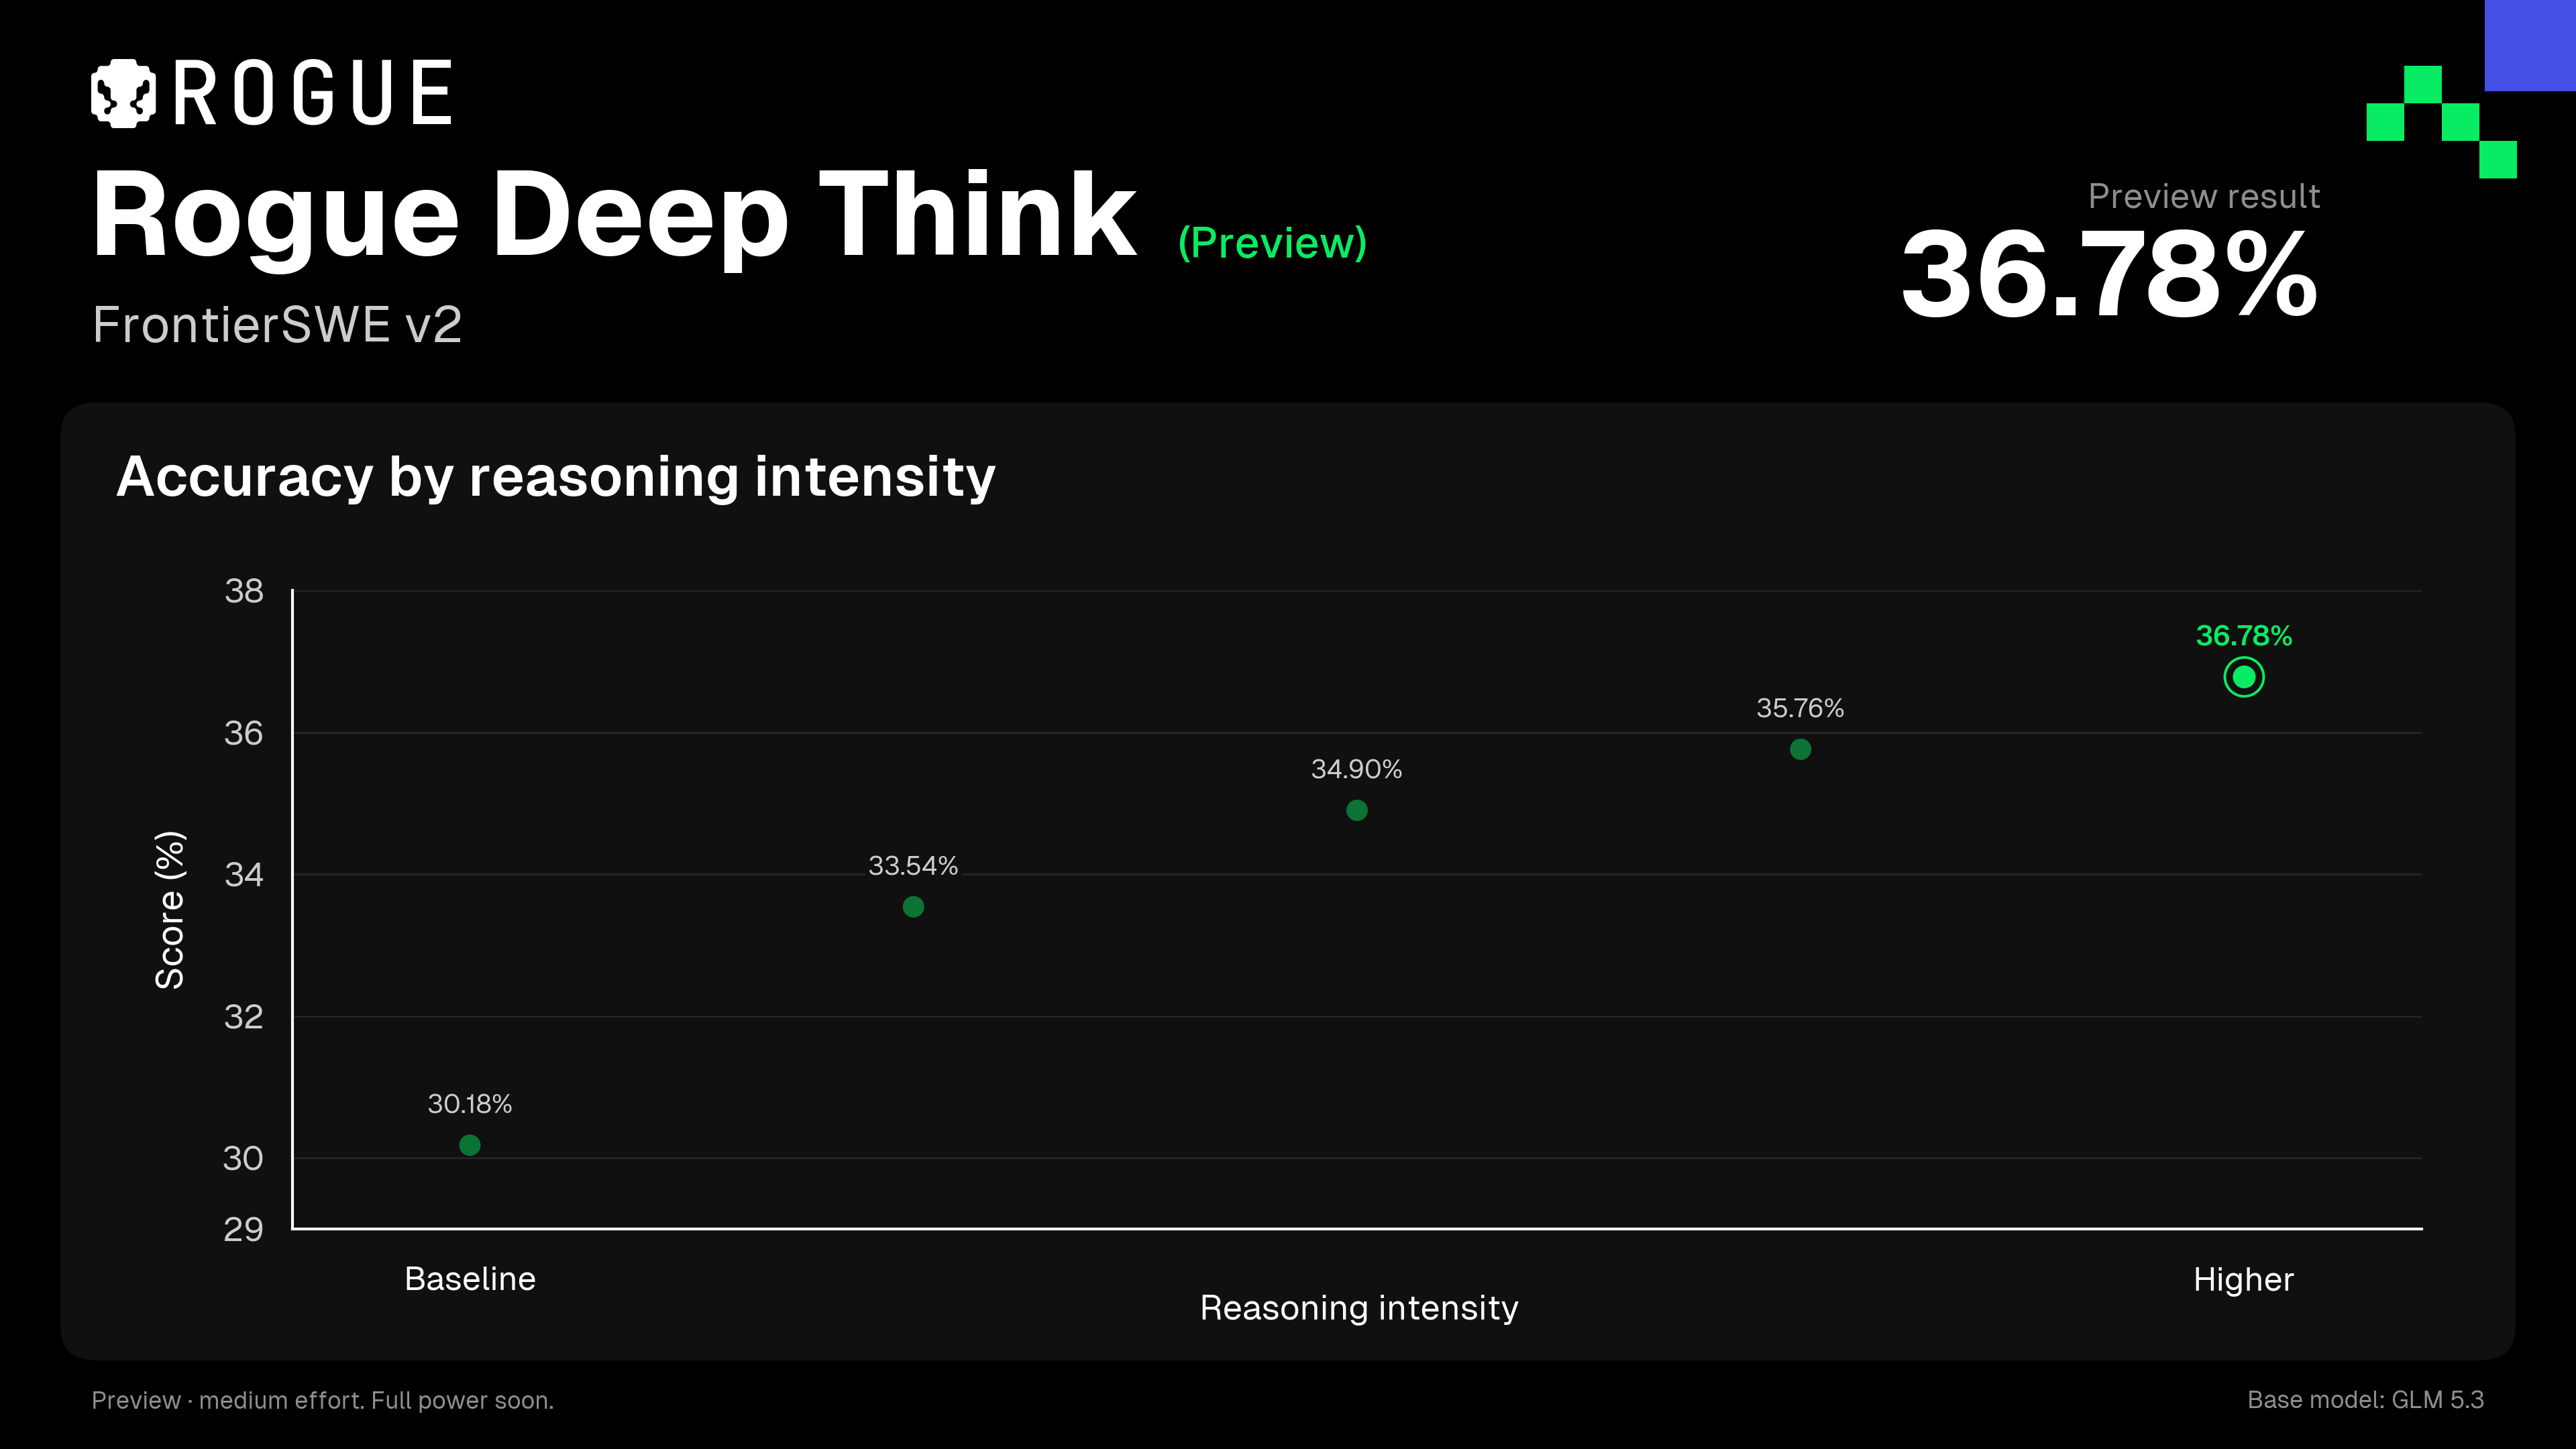
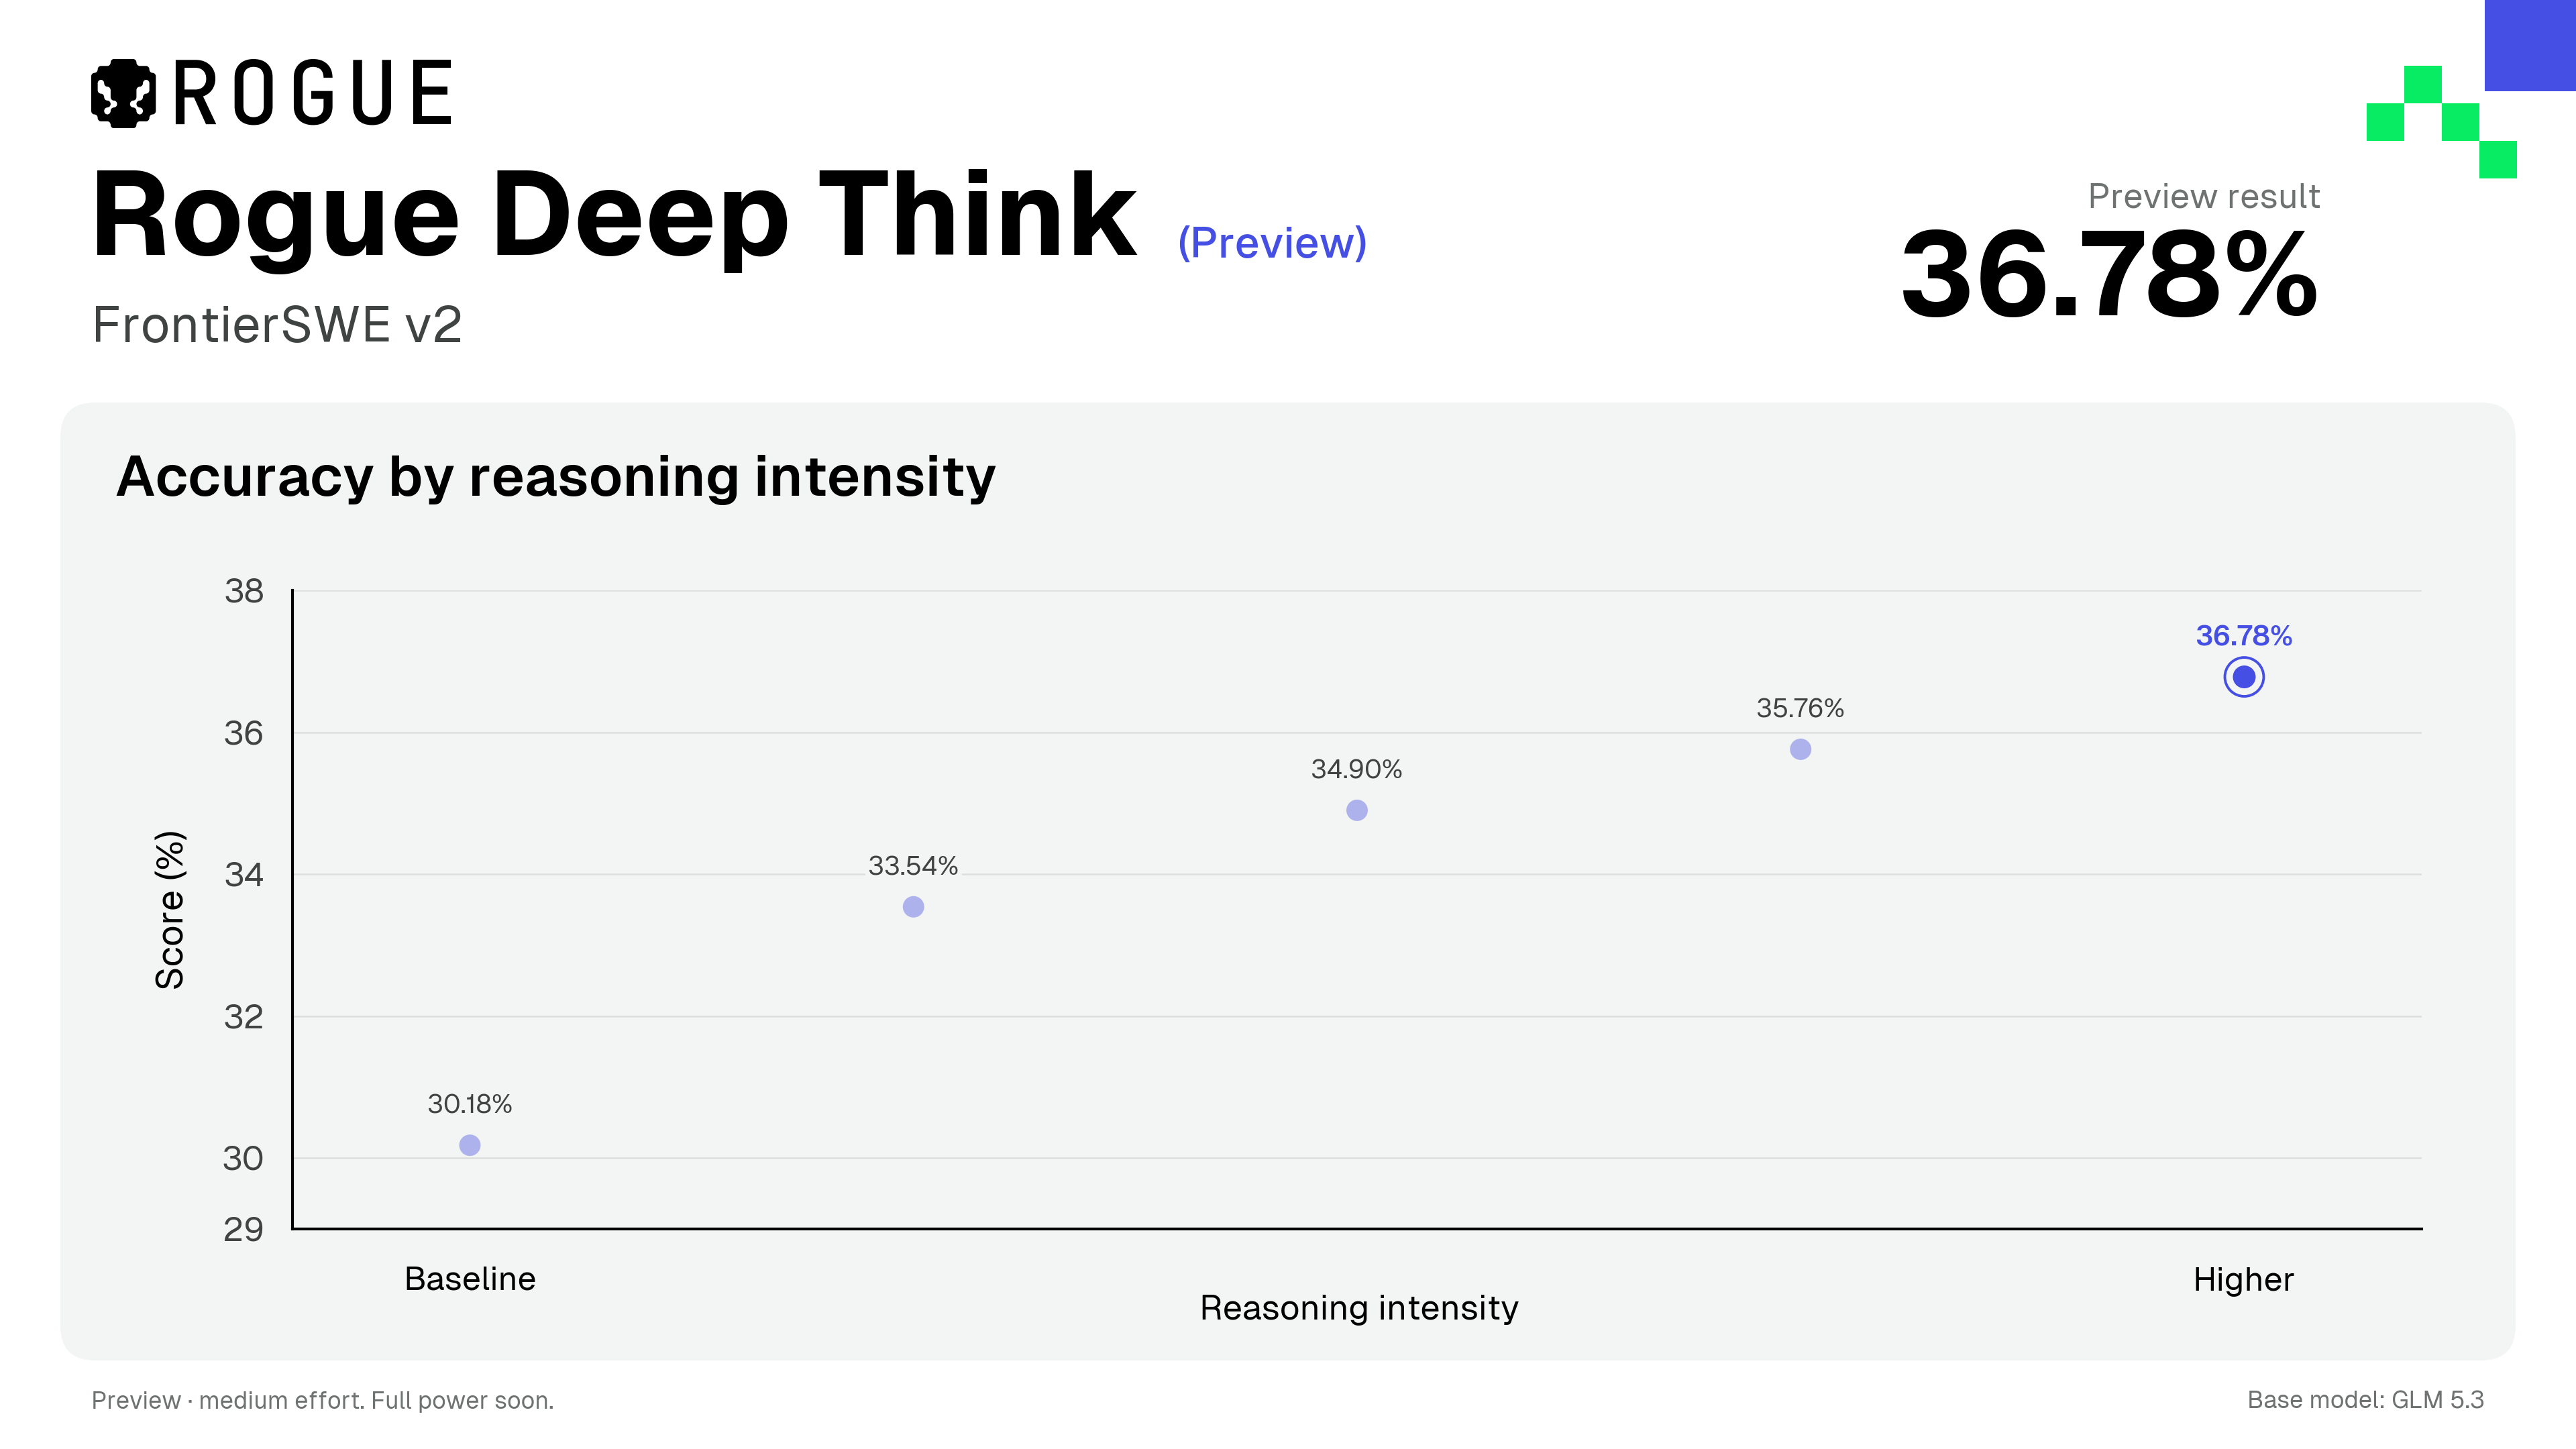
Os dois números vêm das nossas avaliações internas. Em relação à base interna de cada benchmark, o Preview subiu 6,19 pontos percentuais no DeepSWE, de 69,03% para 75,22%, e 6,60 pontos no FrontierSWE, de 30,18% para 36,78%.


Por que DeepSWE e FrontierSWE
Durante anos, o placar mais citado em programação foi o SWE-bench Verified. Em fevereiro de 2026, a OpenAI deixou de divulgá-lo e pediu aos outros laboratórios que fizessem o mesmo. Todos os modelos de ponta que ela testou já tinham visto parte das soluções no treino, e 59,4% dos 138 problemas difíceis que auditou tinham defeito no teste ou na descrição. Em julho, a OpenAI retirou também a recomendação do SWE-bench Pro, que tinha sugerido no lugar, ao estimar que cerca de 30% das tarefas estavam quebradas.
O DeepSWE, da Datacurve, foi desenhado para evitar esses dois problemas. As 113 tarefas, em 91 projetos de código aberto e cinco linguagens, foram escritas do zero e nunca enviadas aos repositórios originais, para que nenhum modelo tenha visto a resposta no treino. Cada uma é corrigida por um verificador escrito à mão, que testa o comportamento do programa e não detalhes de implementação. Uma solução de referência adiciona em média 668 linhas de código, contra 120 no SWE-bench Pro. Nos lançamentos de julho a setembro de 2026, o DeepSWE aparece nos materiais de OpenAI, Anthropic, Google, xAI, Z.ai, Moonshot e DeepSeek.
O FrontierSWE, da Proximal, mede trabalho ainda mais longo. São 34 tarefas de engenharia e pesquisa, como decodificar fala a partir de sinais do cérebro, treinar modelos de previsão do tempo e reimplementar em Rust o núcleo do Quantum ESPRESSO. Cada tentativa tem até 20 horas, cada tarefa roda cinco vezes, e os autores dizem que o benchmark está longe de saturar: o maior resultado público é 65,51%.
O que isso muda
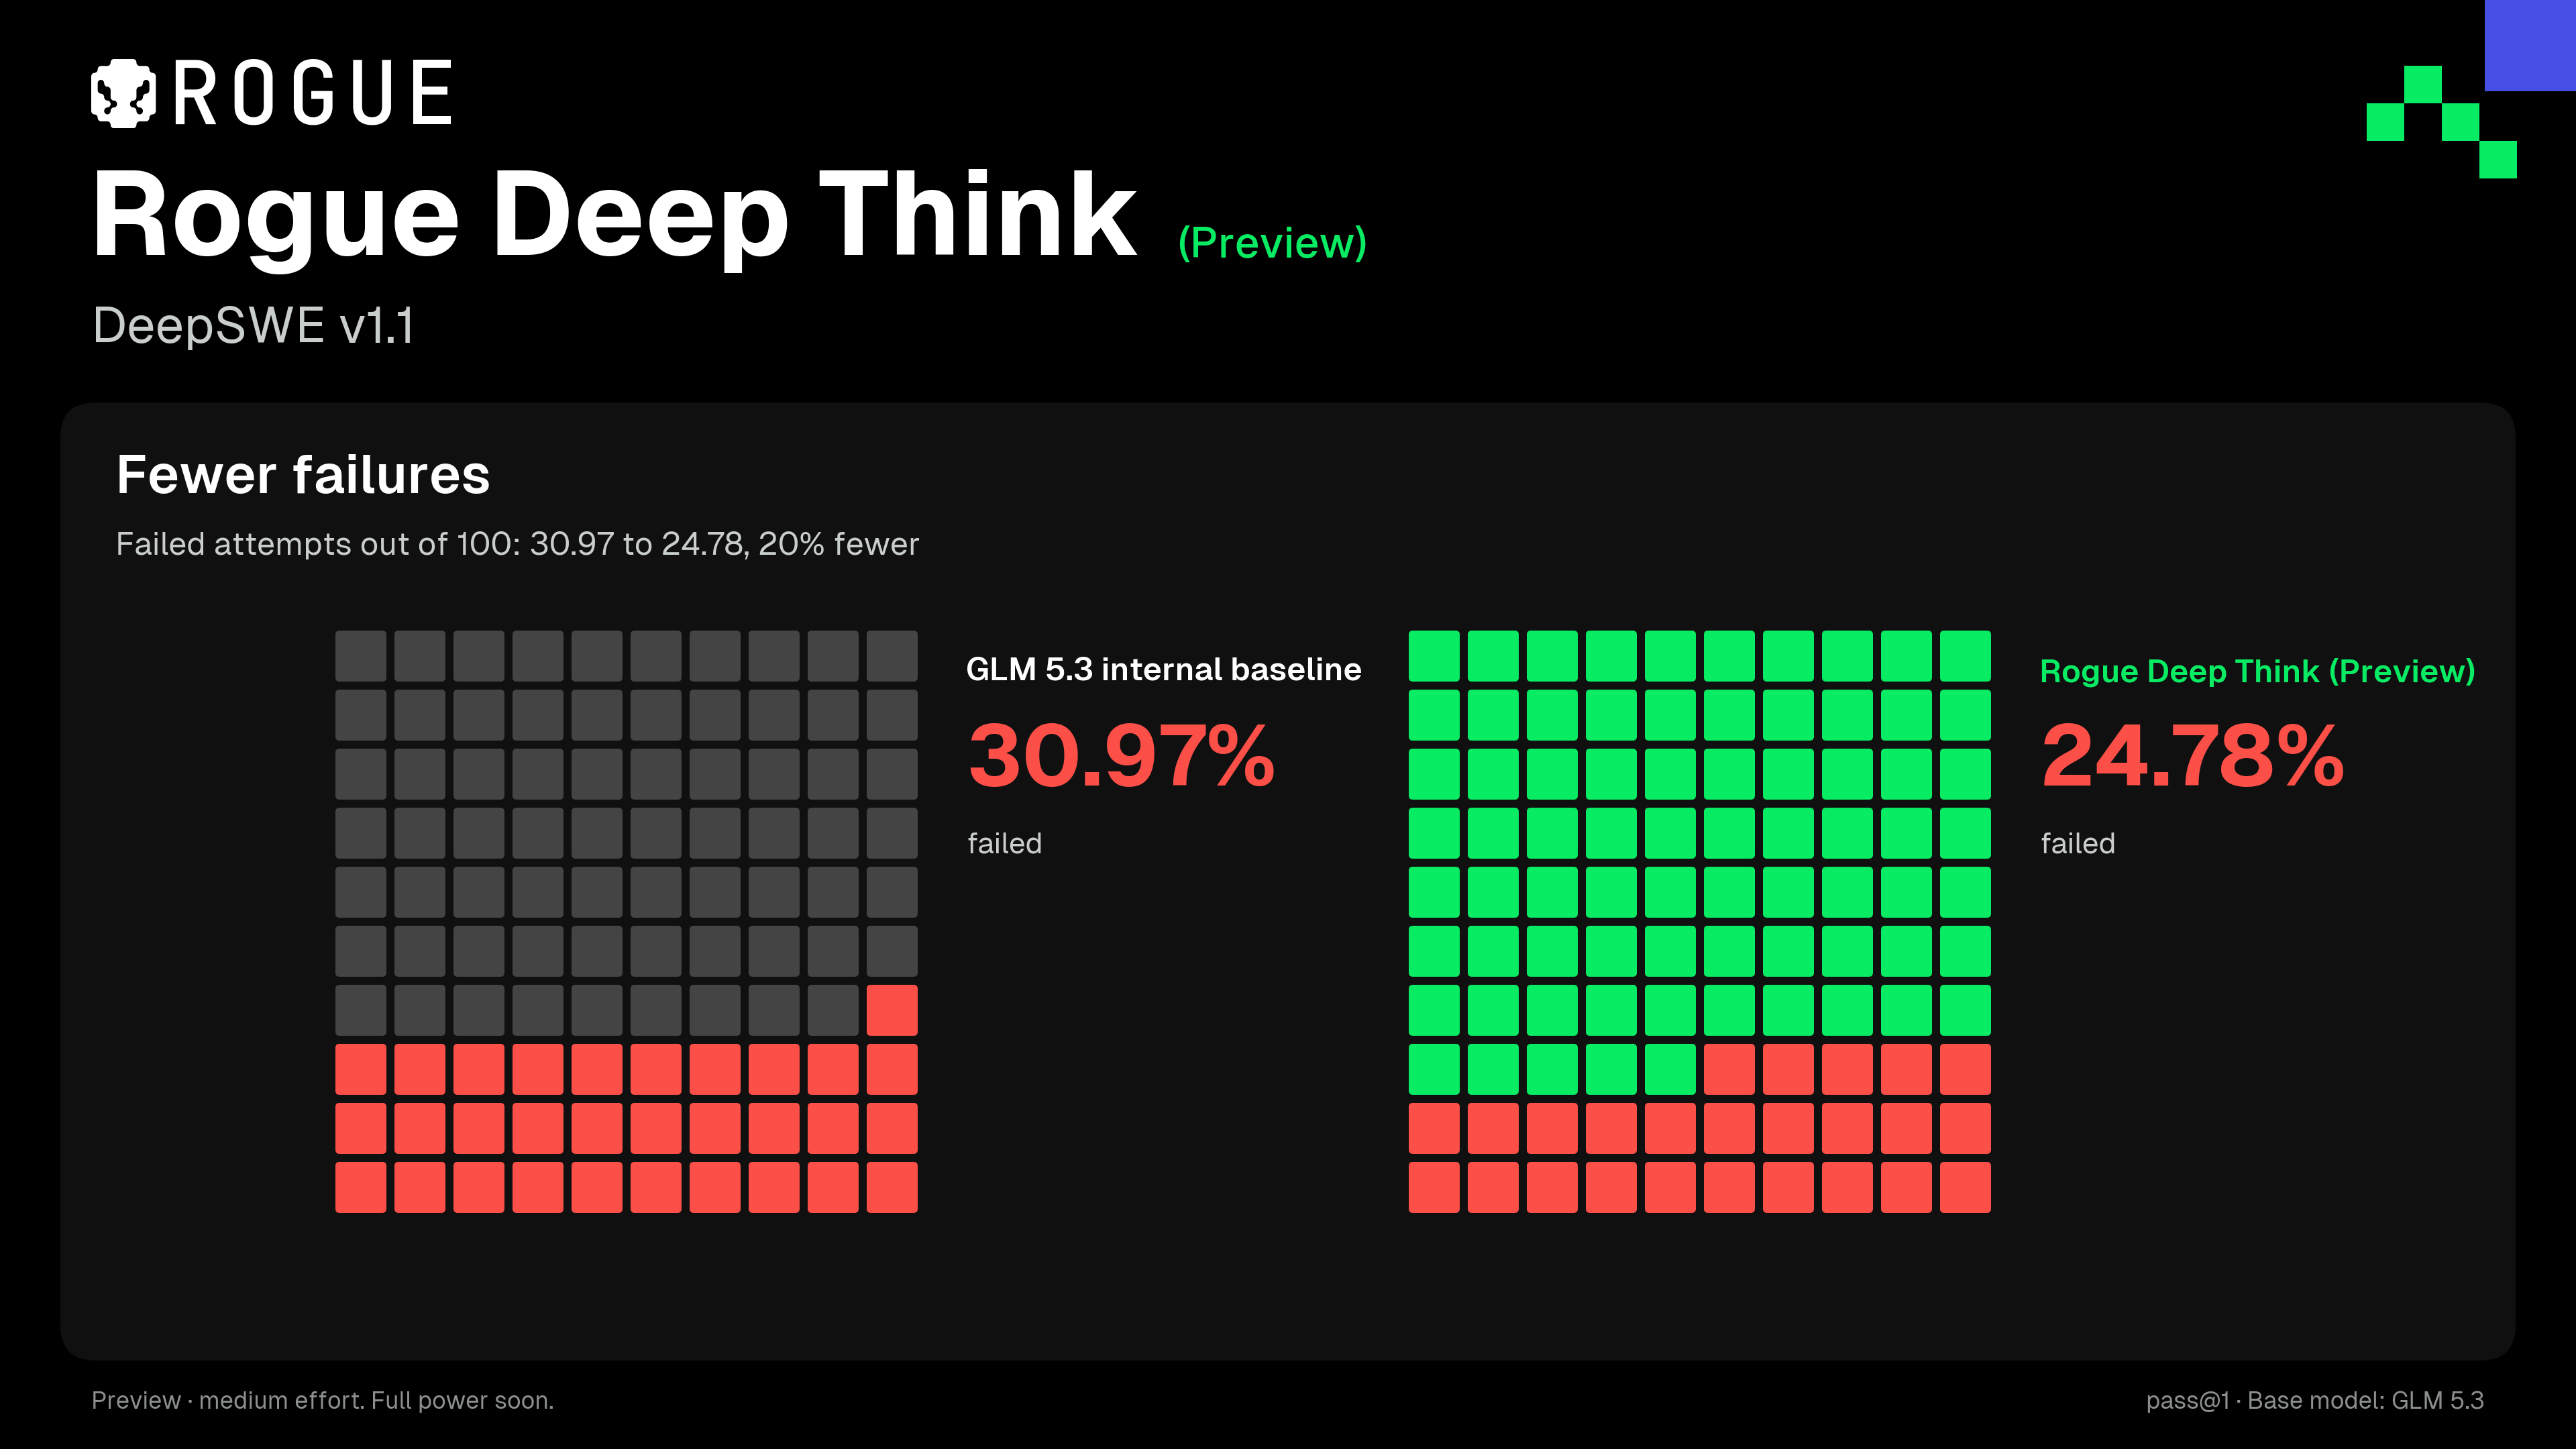
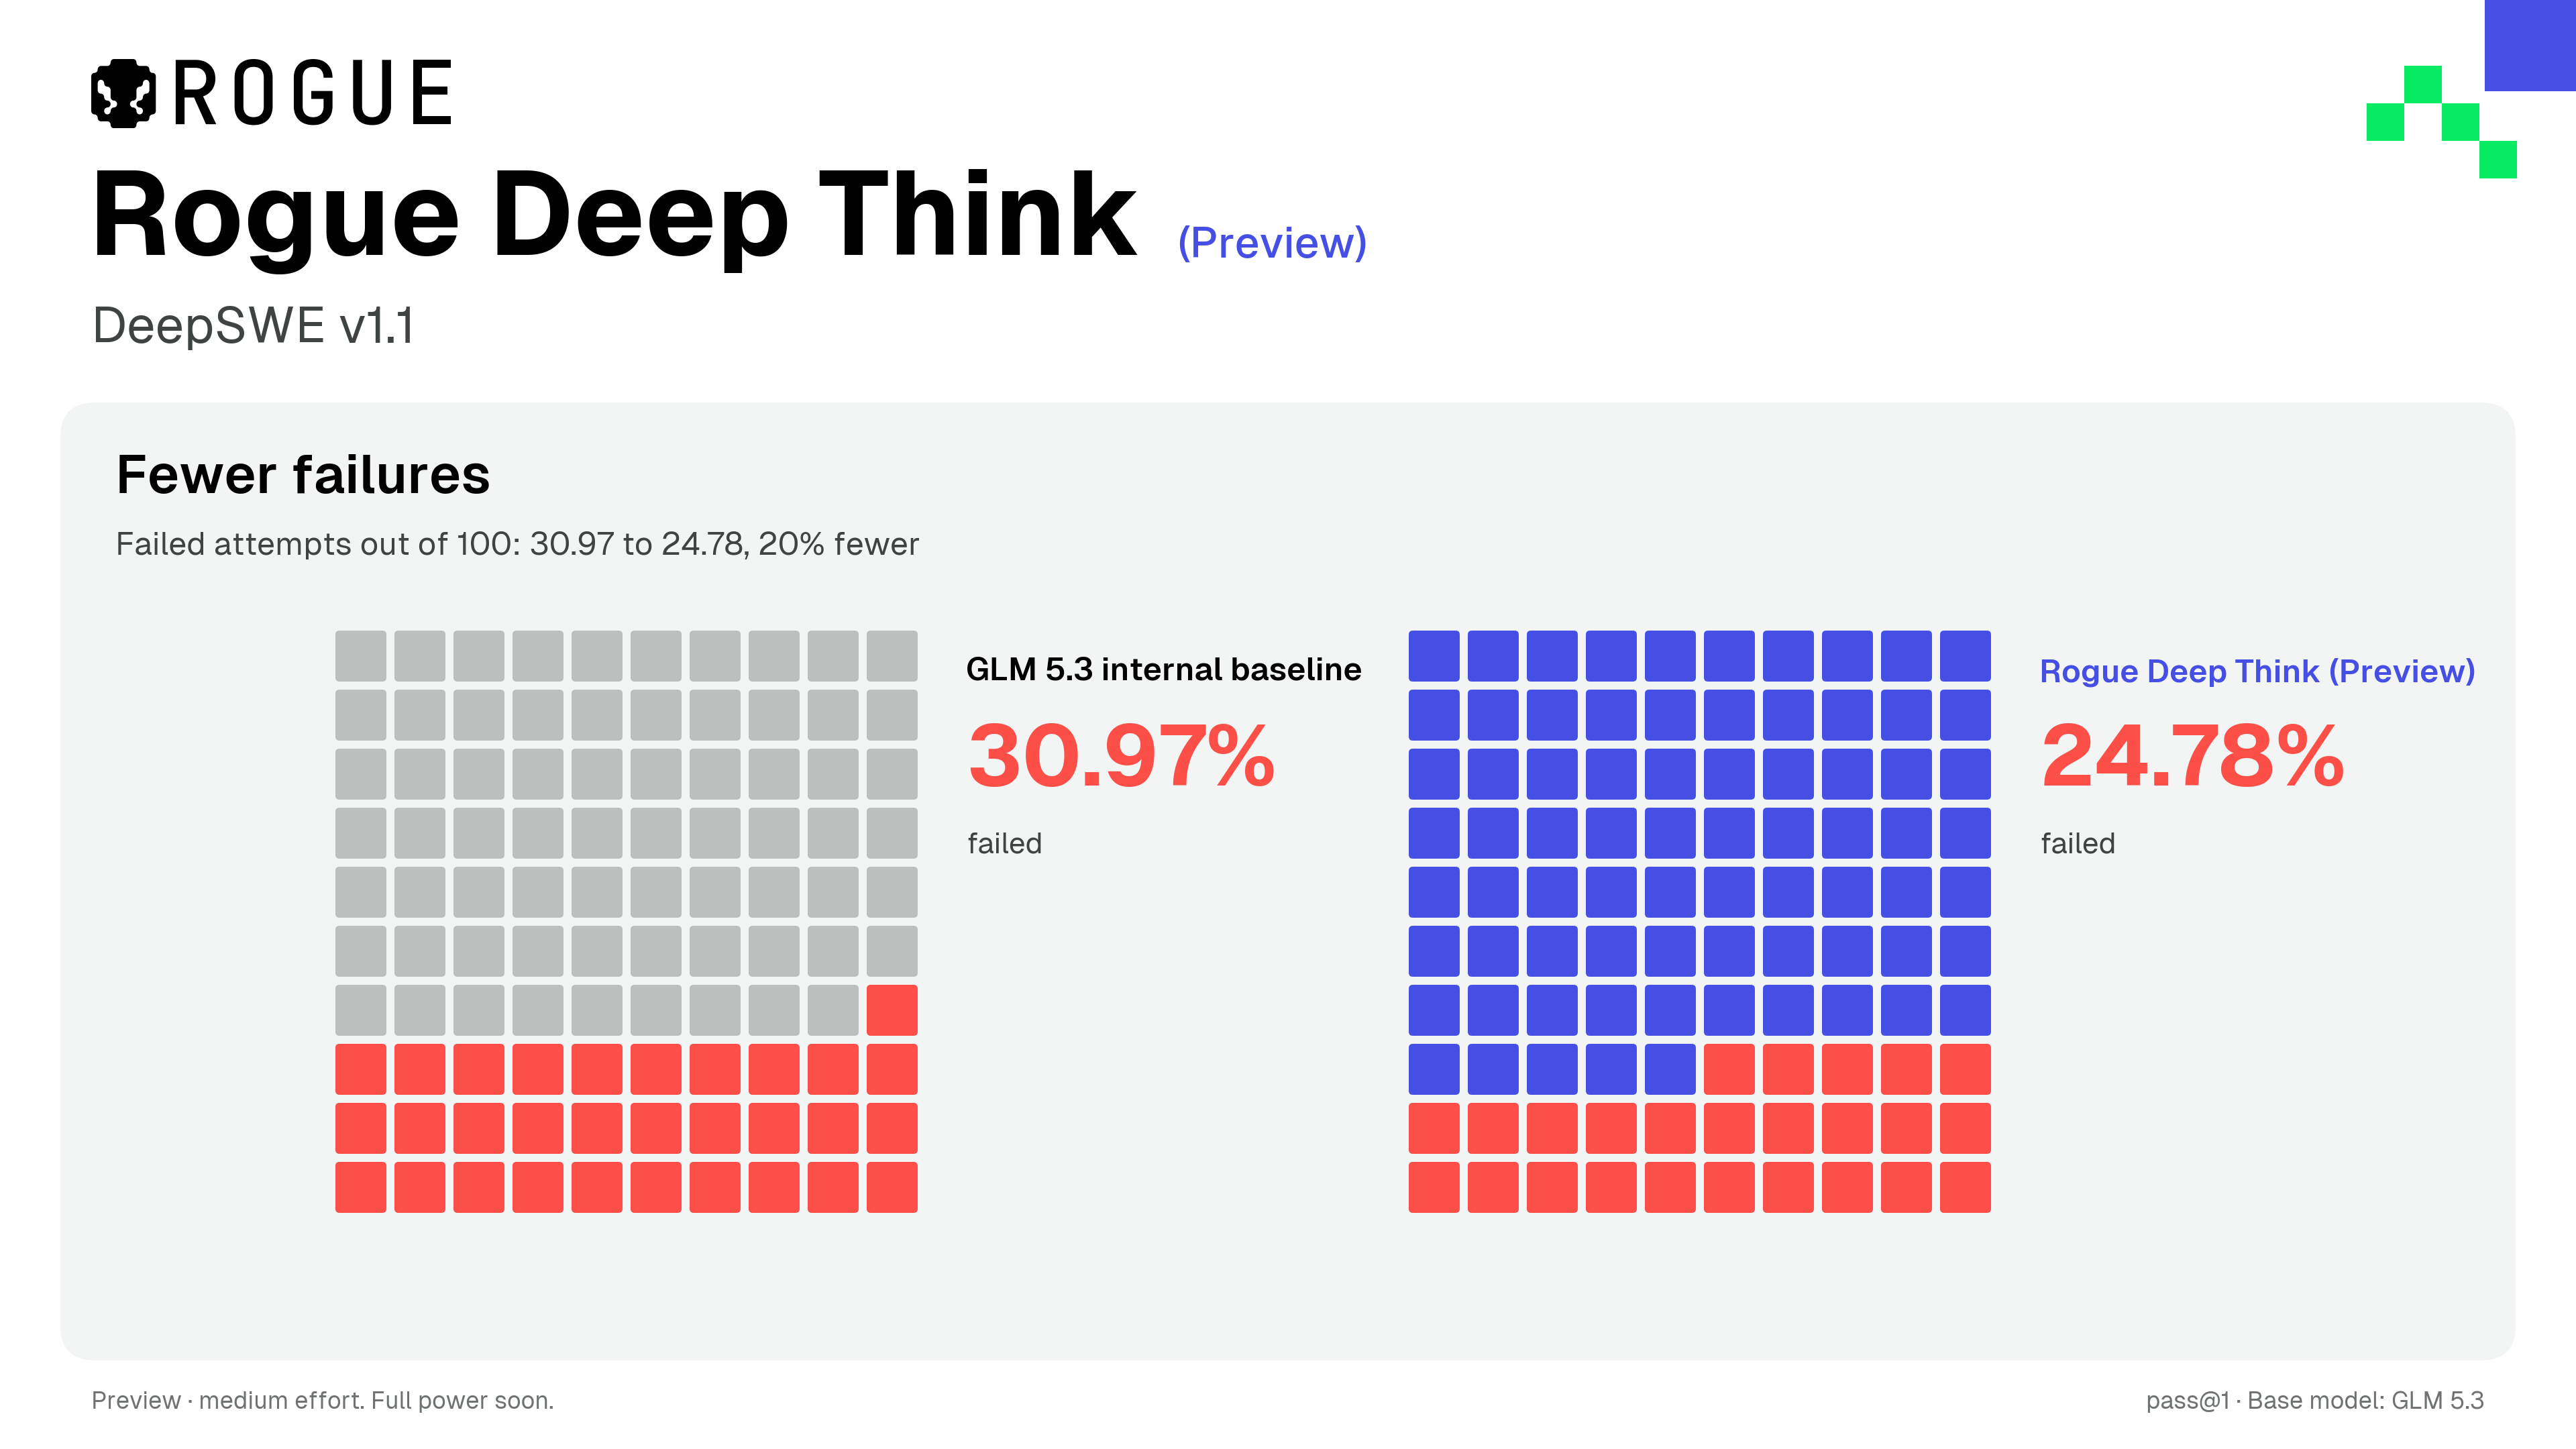
Como cada tarefa do DeepSWE é uma mudança grande em um projeto real, errar menos pesa. Com o modelo de base, 31 de cada 100 tentativas falhavam. Com o Preview, 25. Uma em cada cinco tentativas que falhavam passa a dar certo.


Mais raciocínio, mais acerto
Medimos o Preview em configurações com intensidade de raciocínio crescente. Nos dois benchmarks, a pontuação sobe a cada passo, da base interna até a configuração que reportamos.


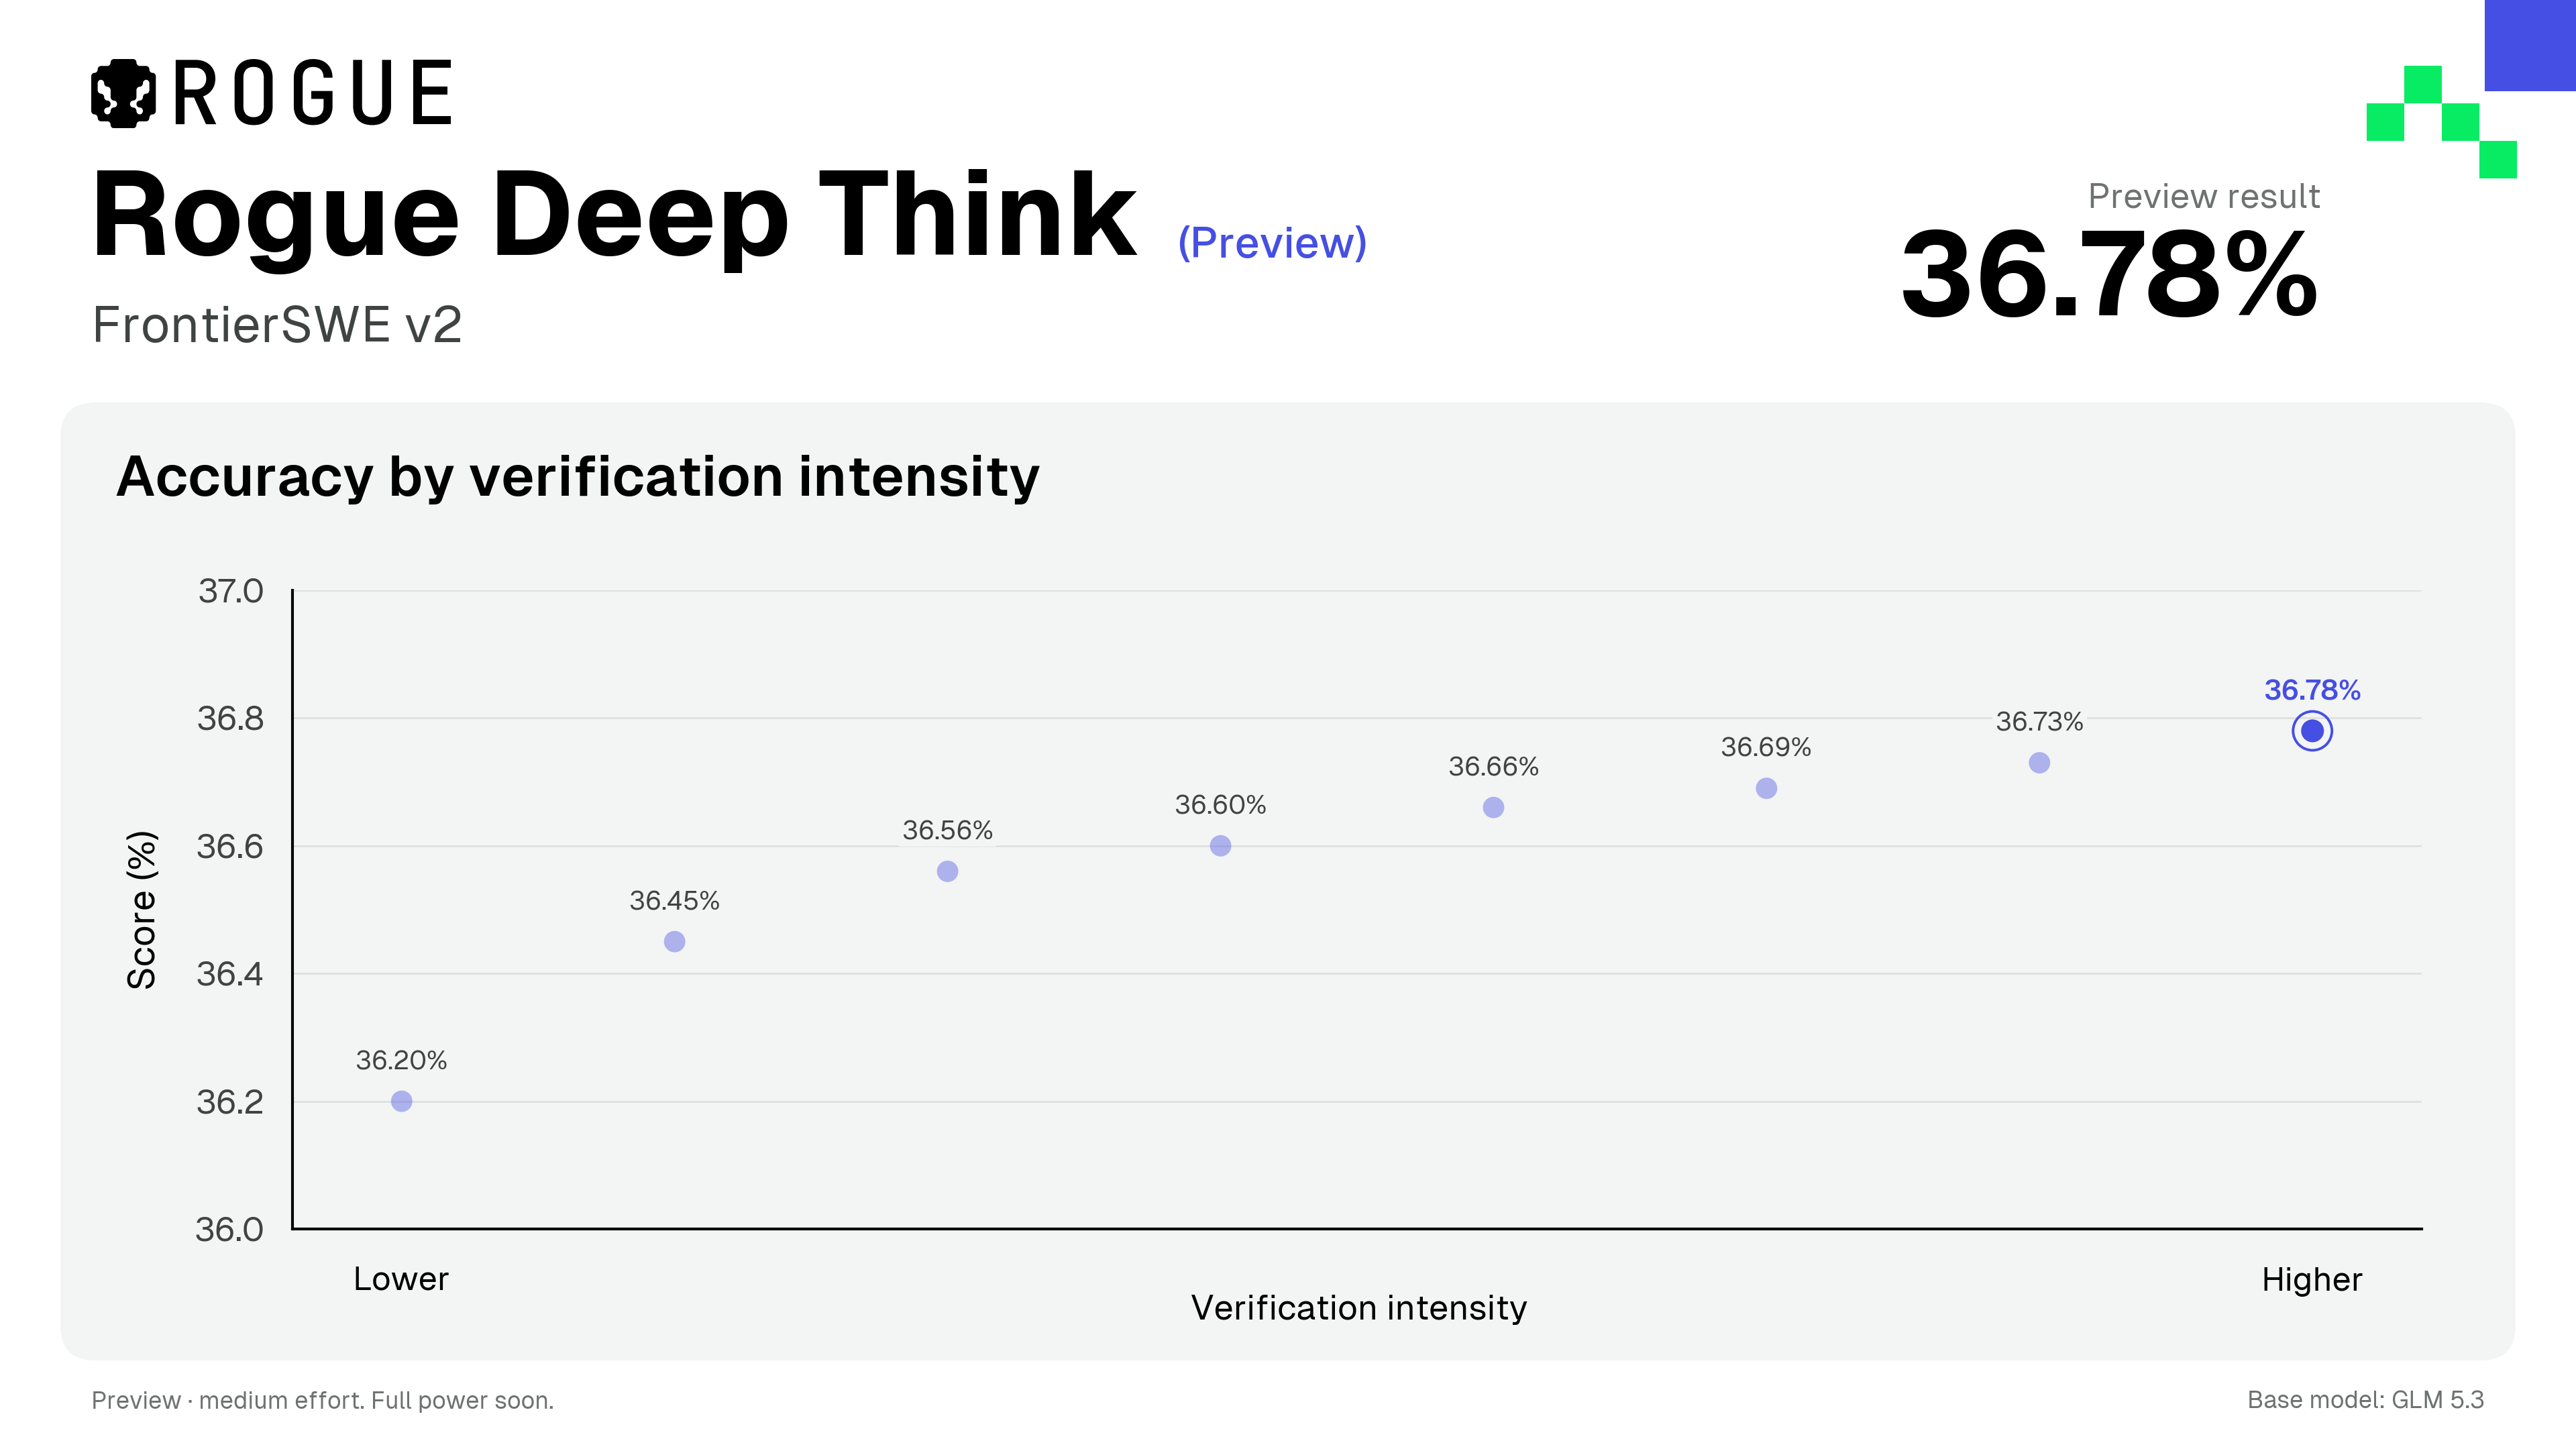
O eixo horizontal mostra a ordem das configurações. Ele não é uma escala comum de tokens, tempo ou custo.
Verificar também conta
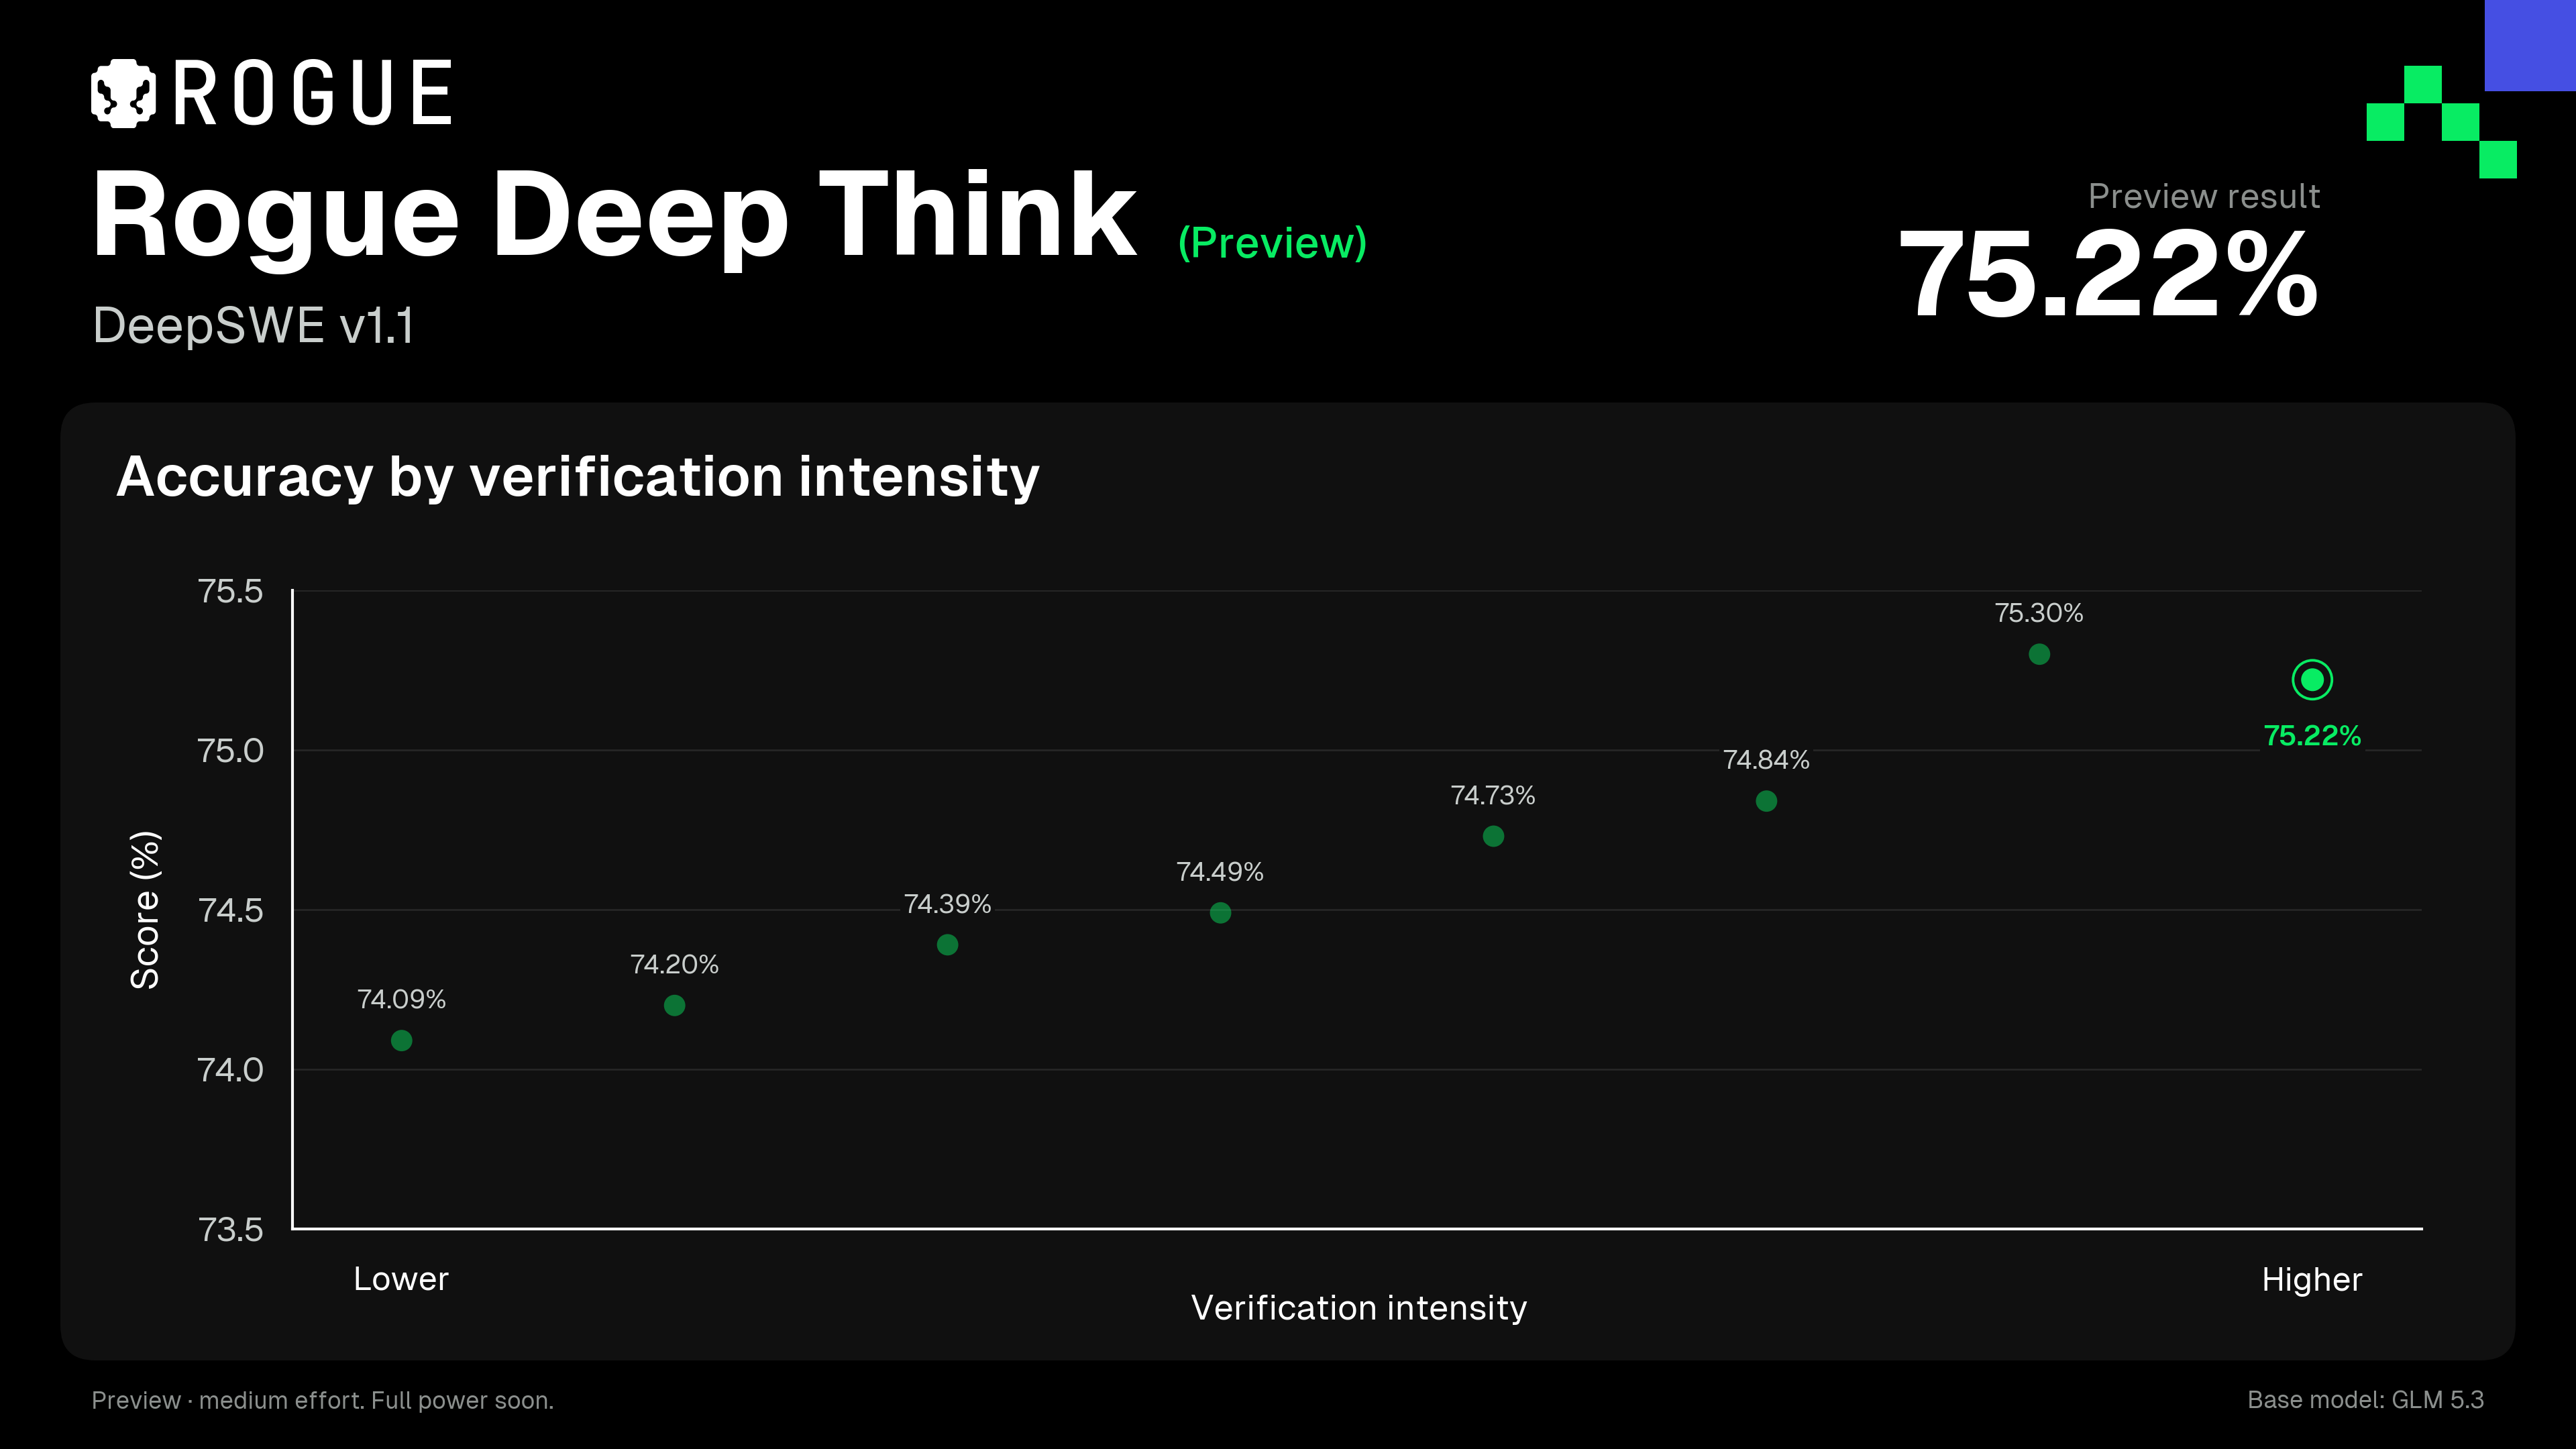
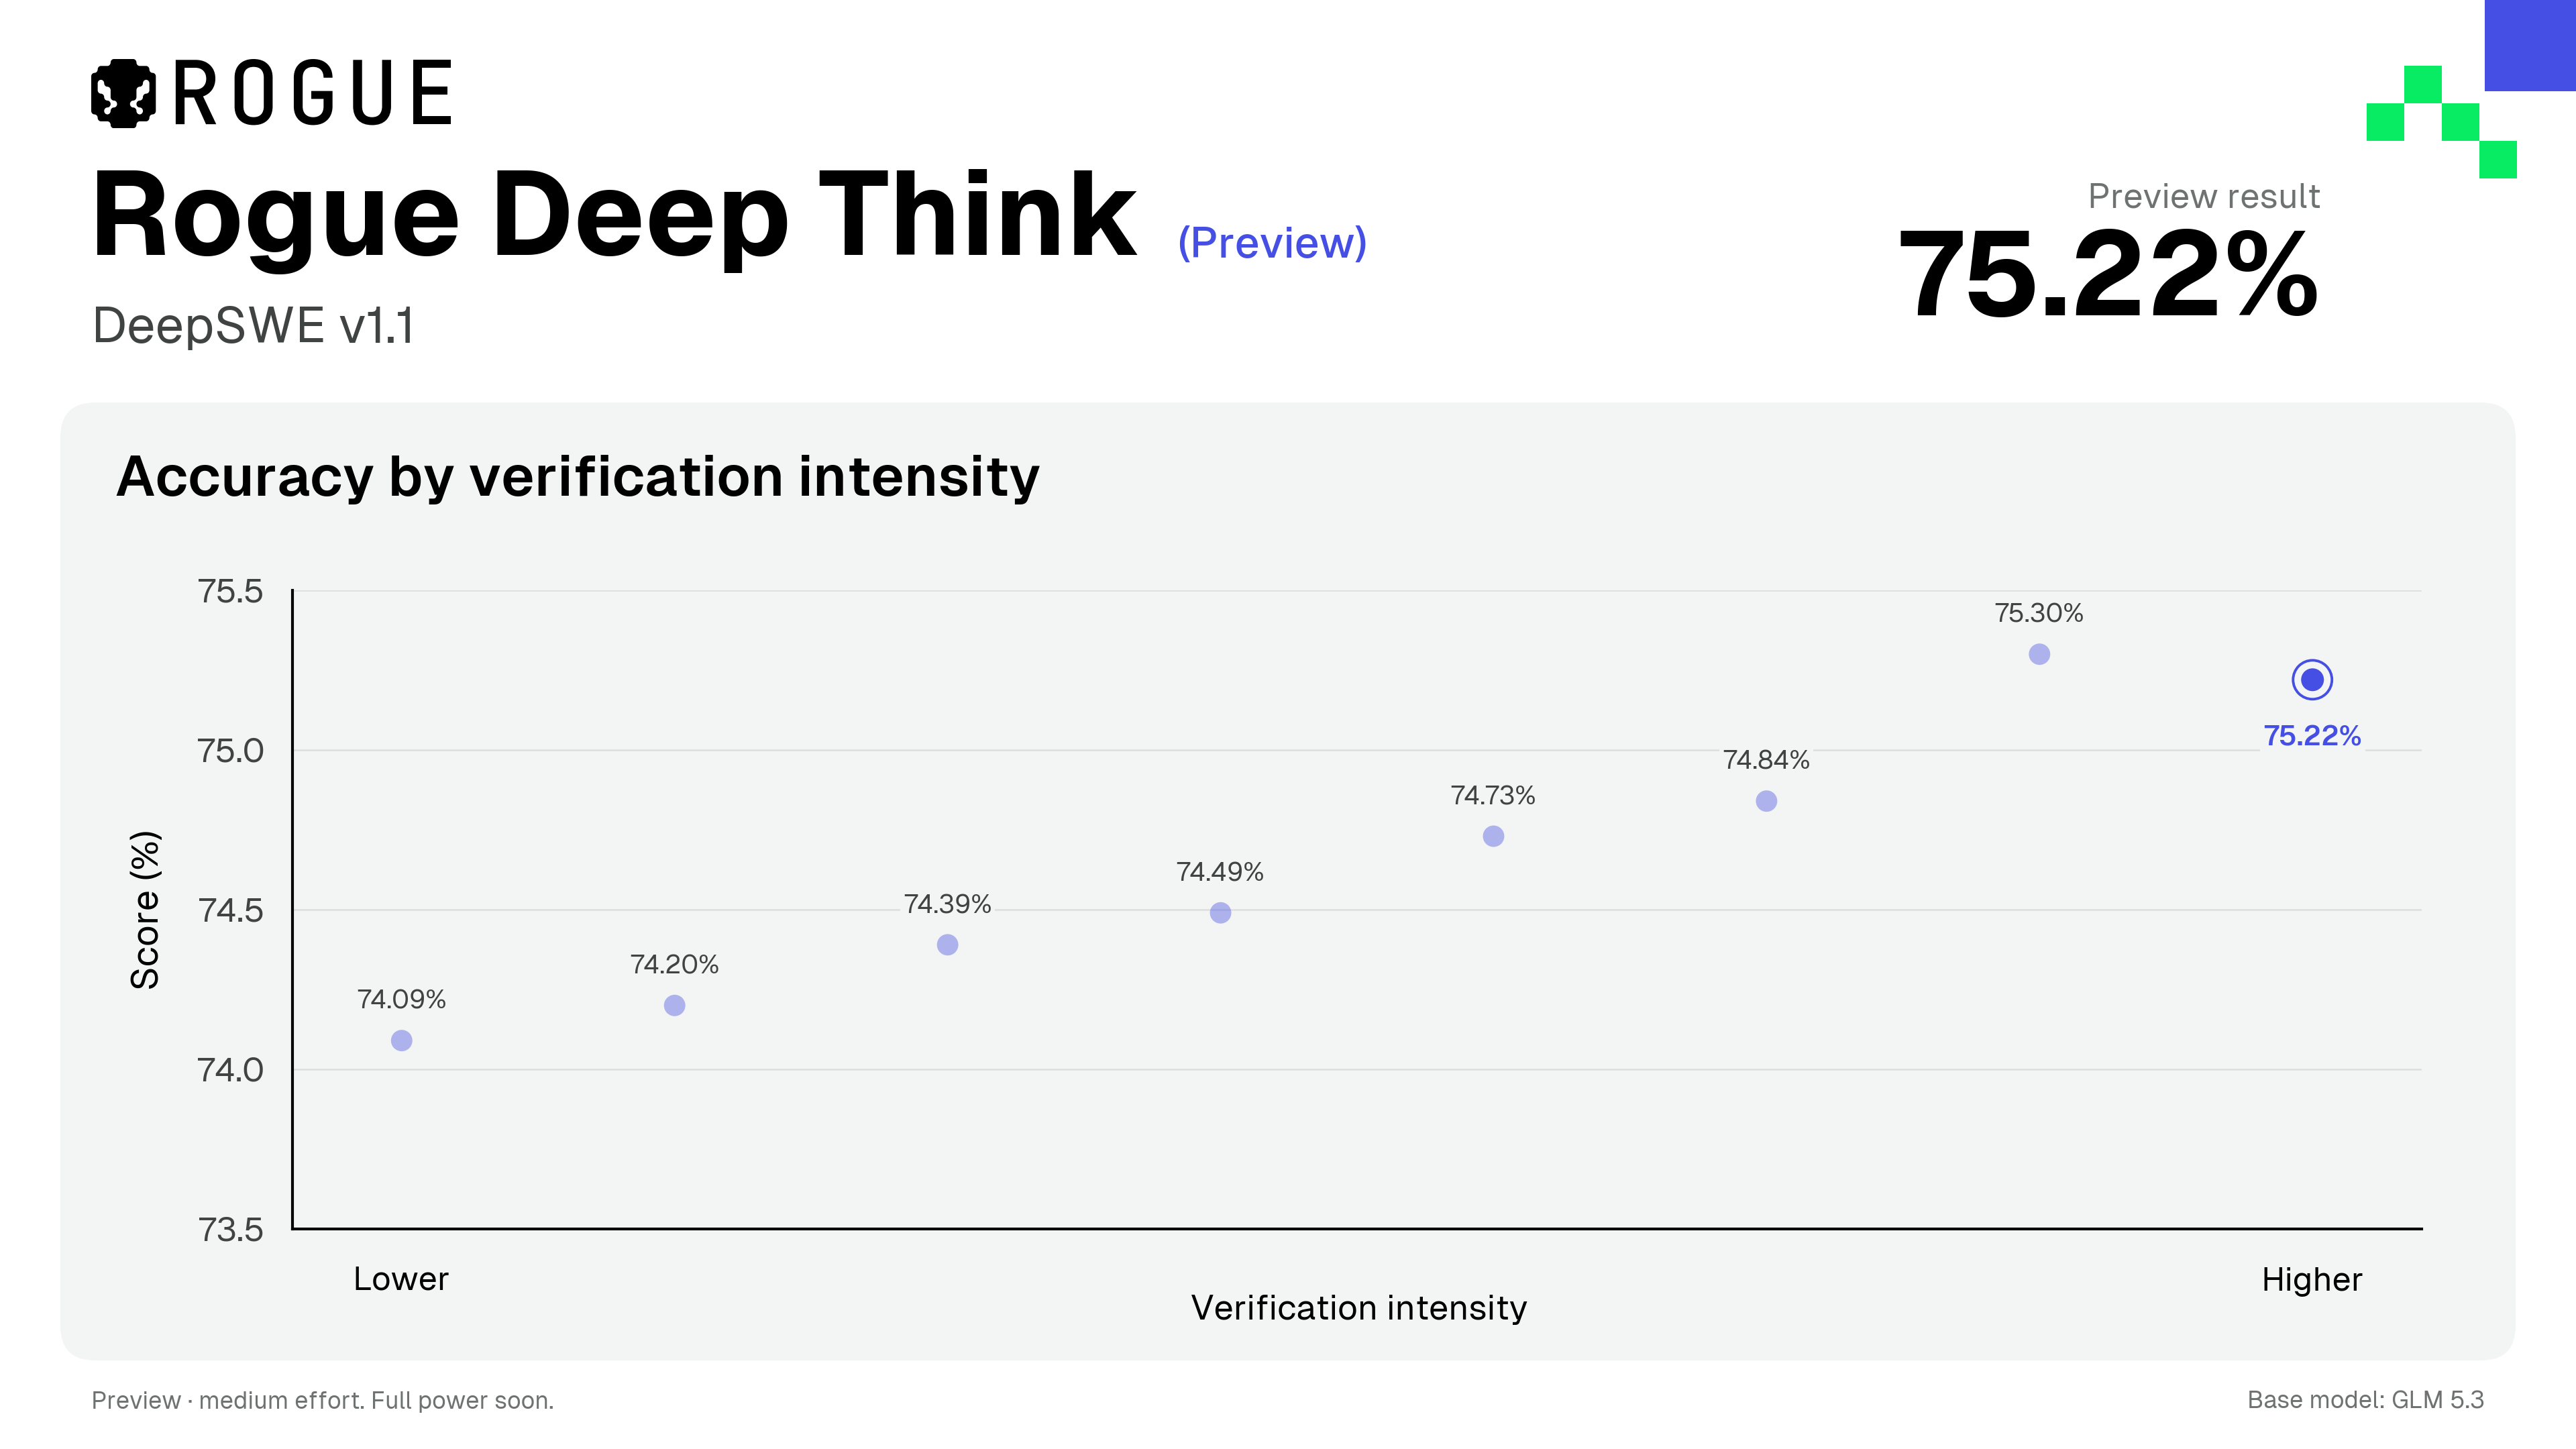
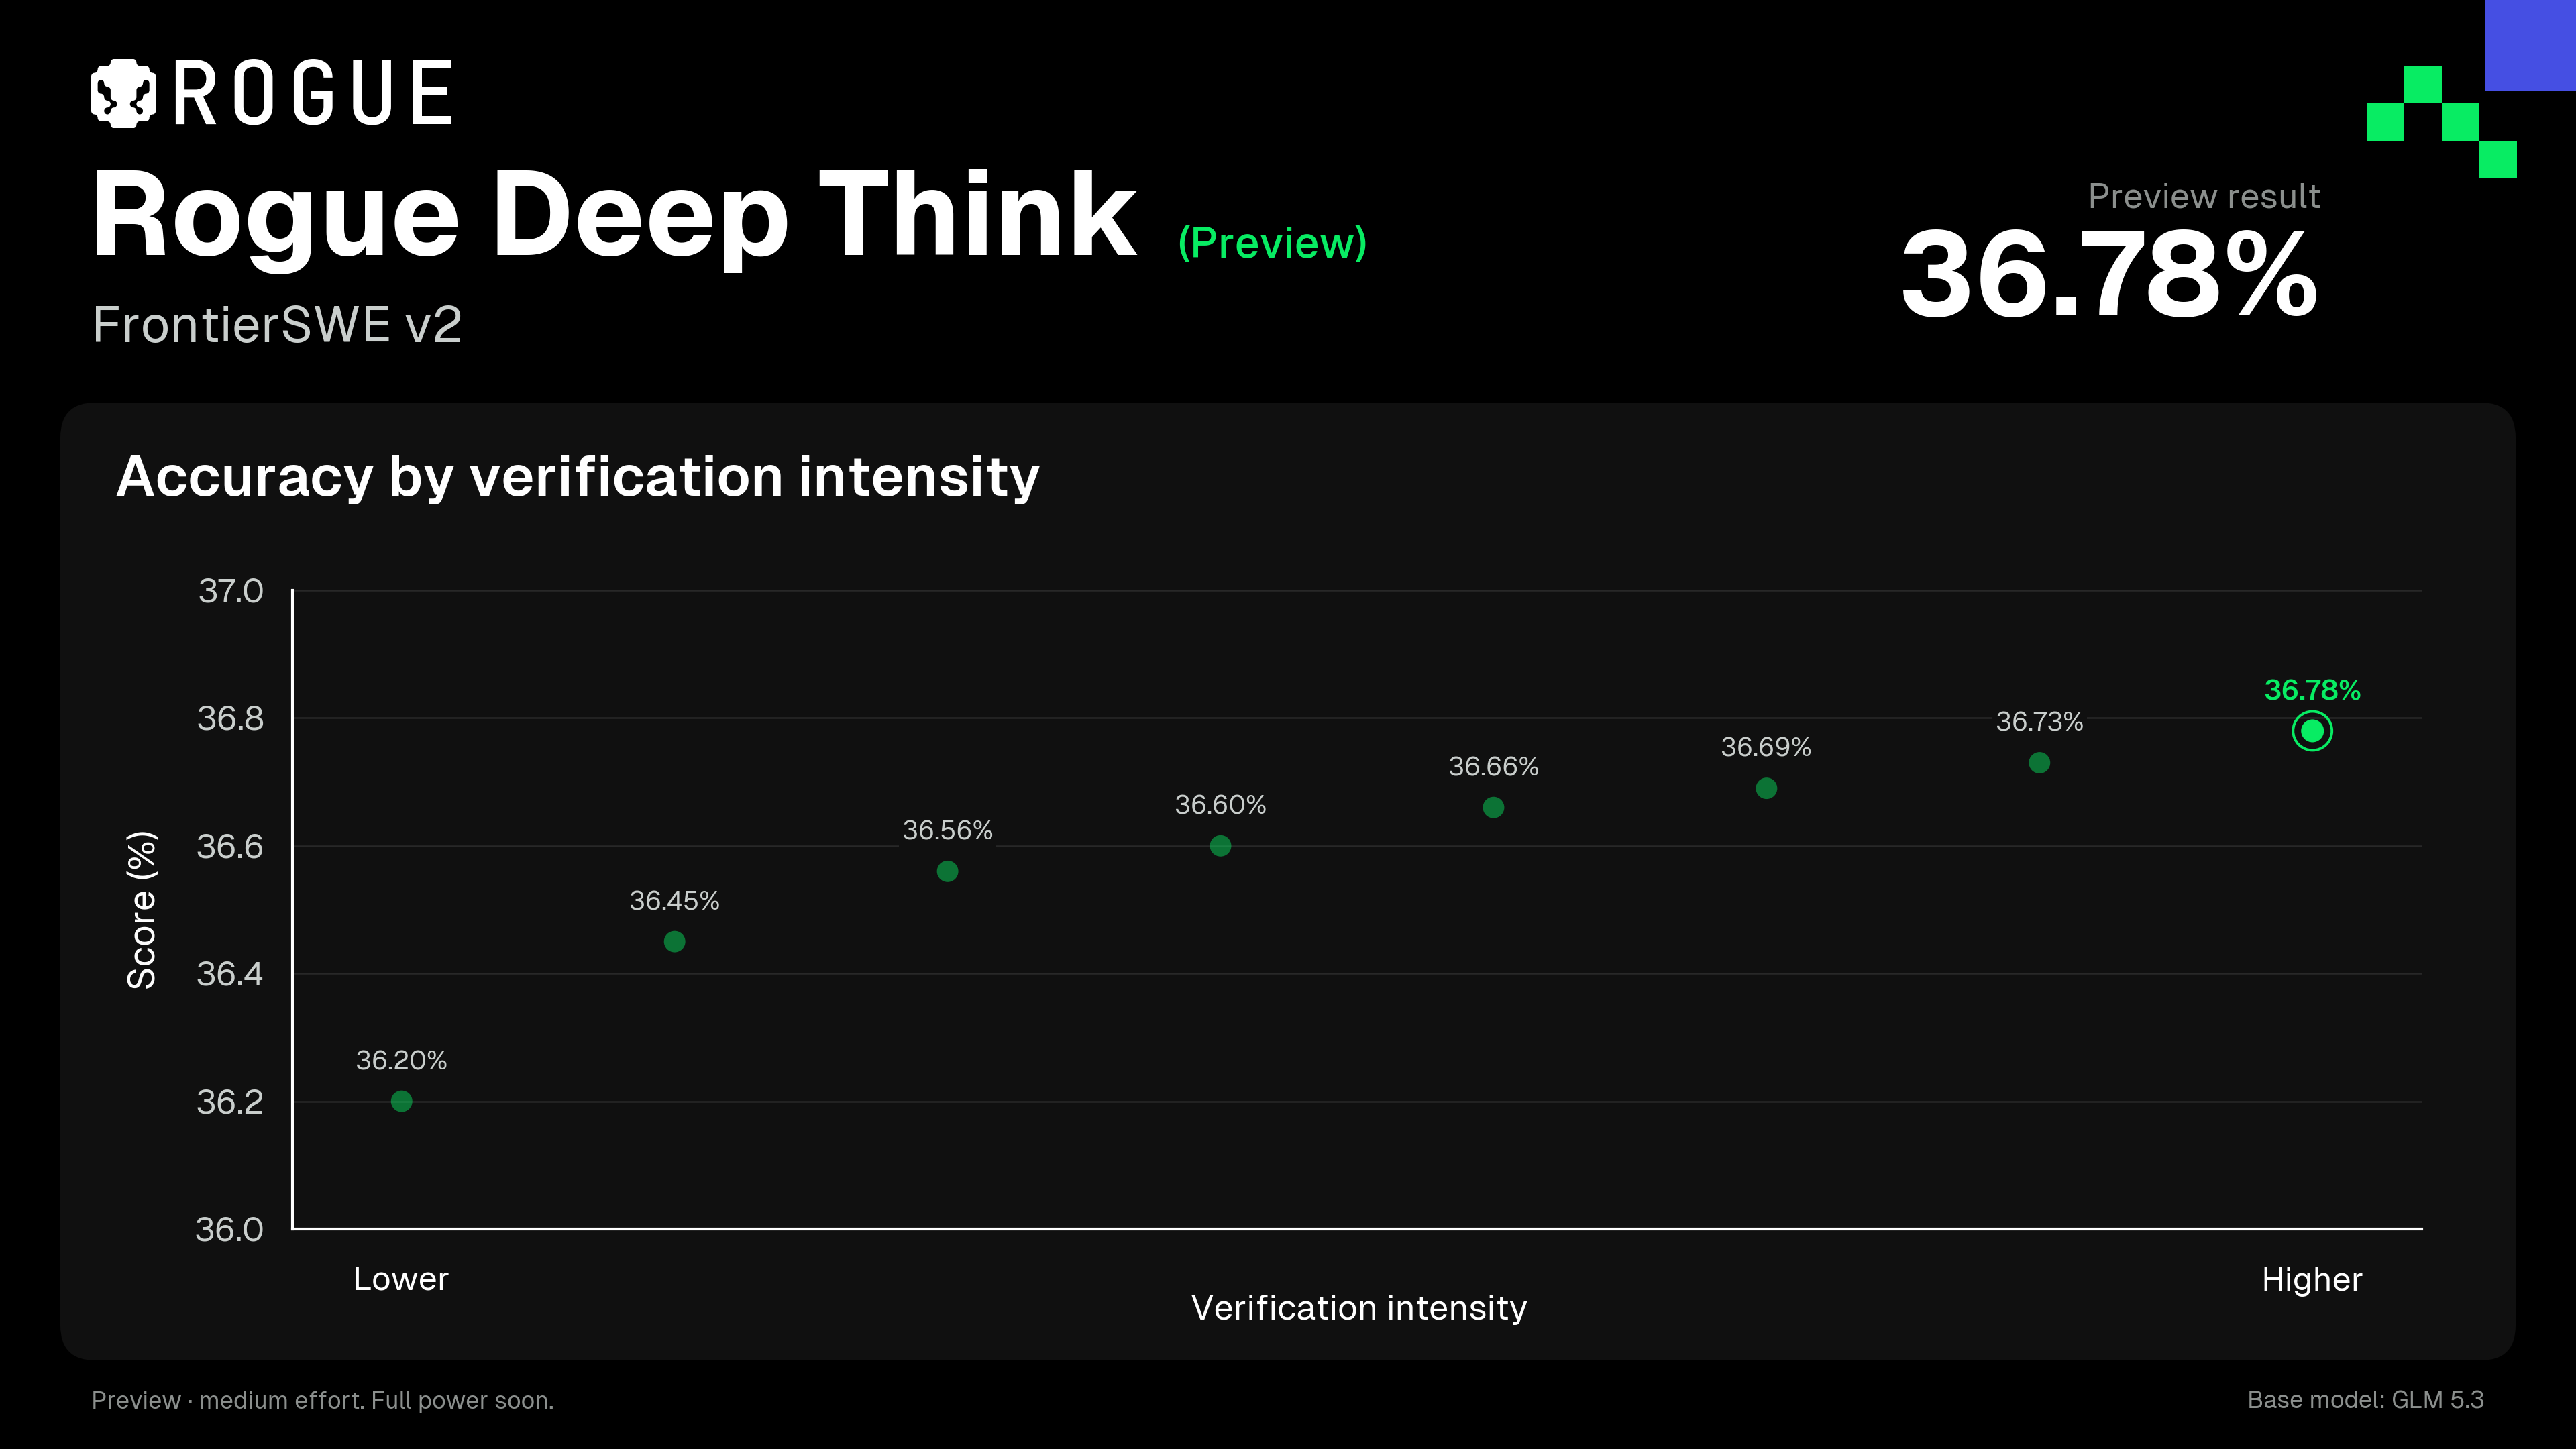
A outra alavanca é a verificação. Com a intensidade de raciocínio fixa, aumentamos o quanto o modelo confere antes de decidir. No FrontierSWE, a pontuação sobe em todos os oito pontos medidos, de 36,20% a 36,78%. No DeepSWE, o penúltimo ponto chegou a 75,30%; reportamos 75,22%, o resultado da configuração mais alta.


Como esses resultados se situam
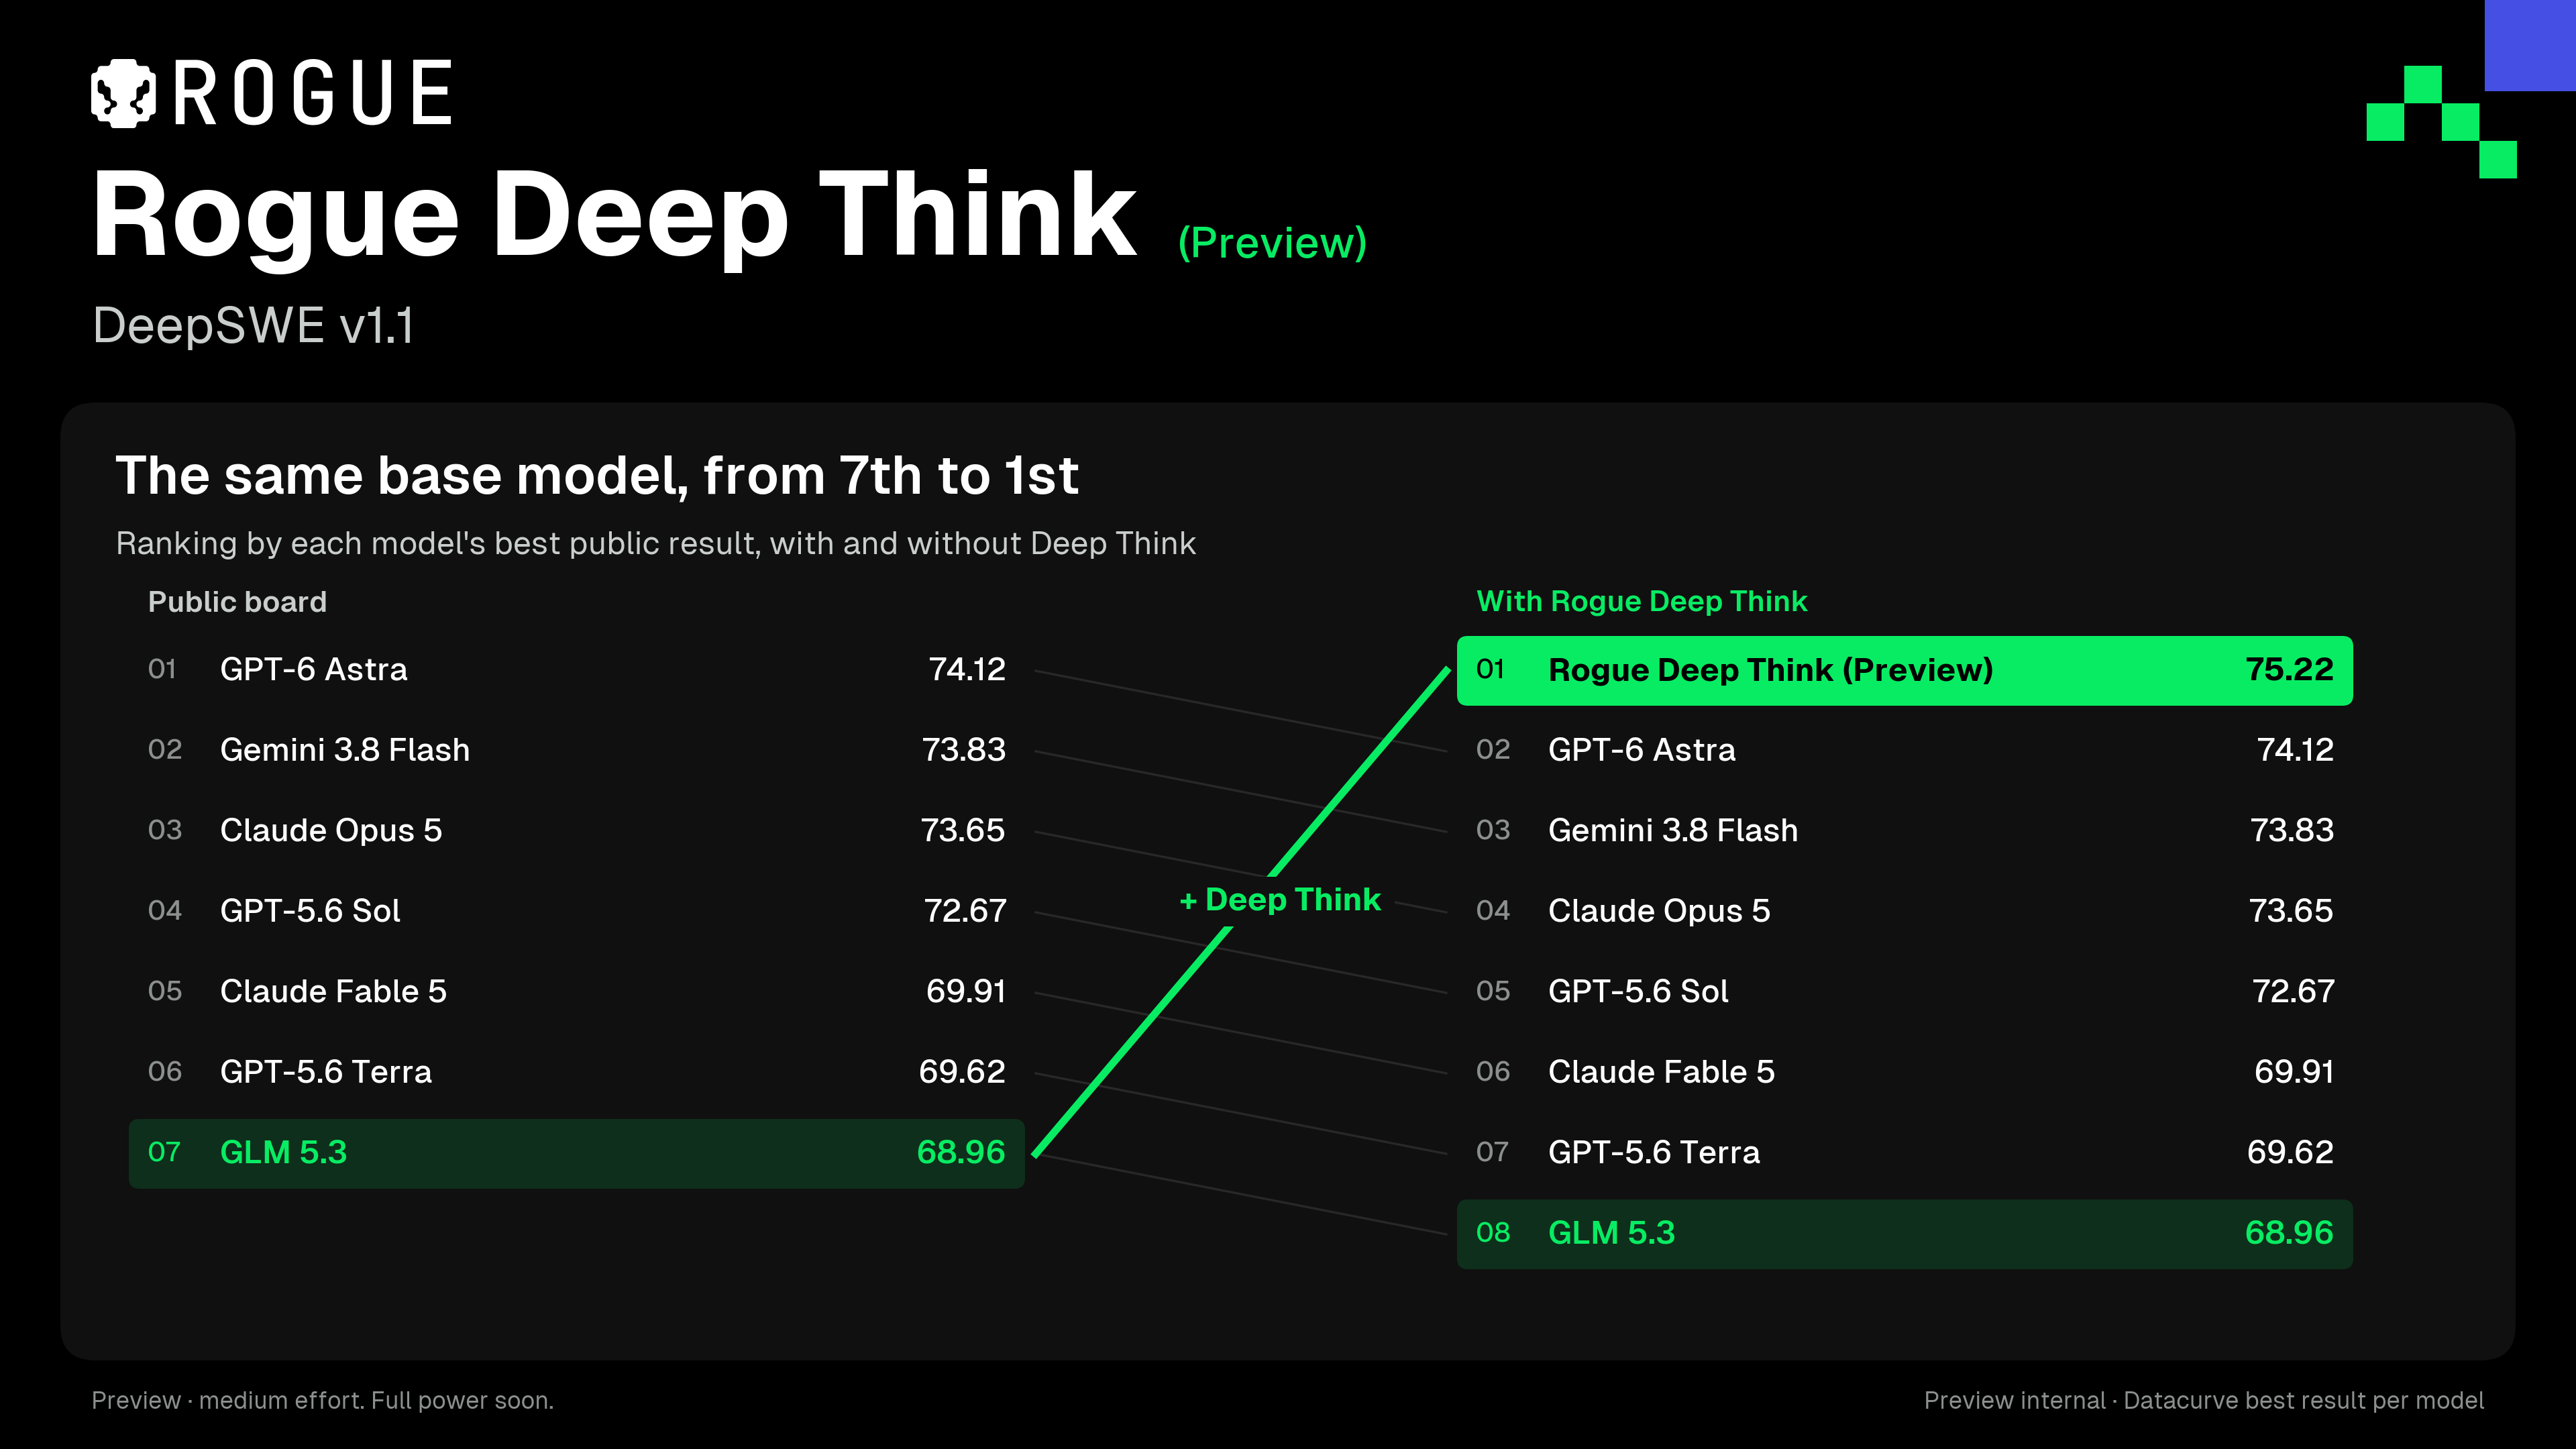
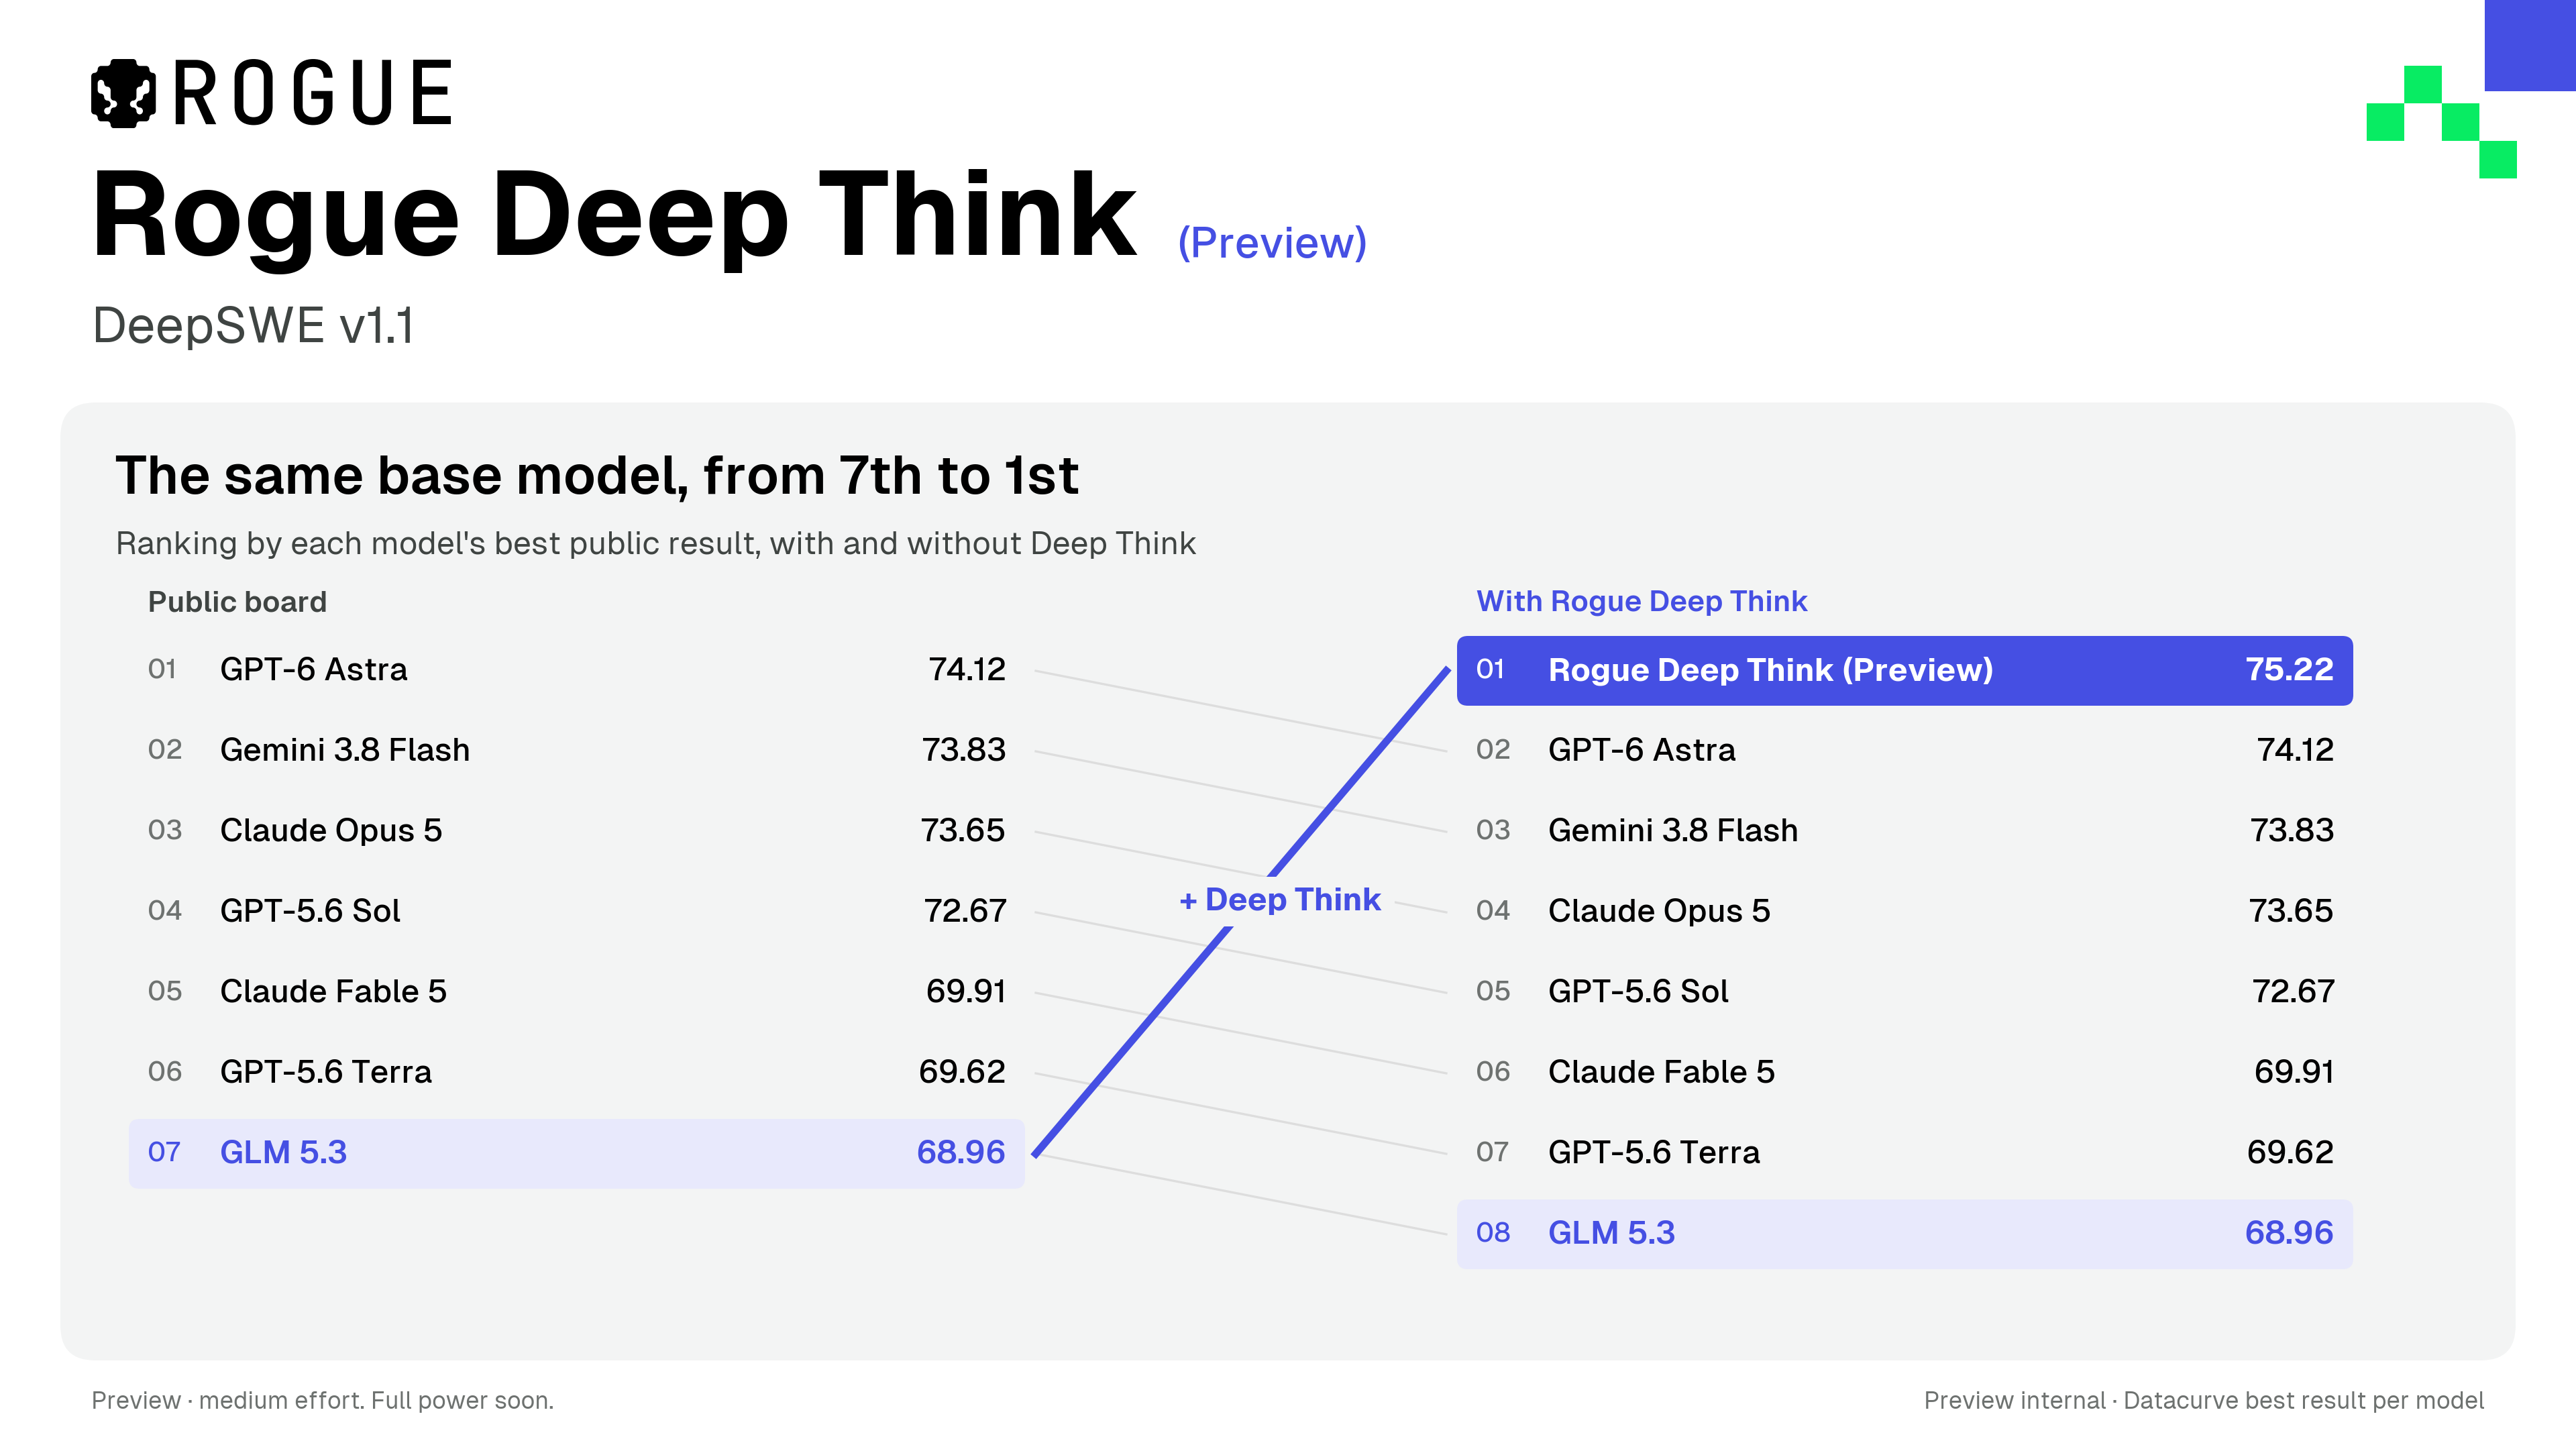
Sozinho, o GLM 5.3 é o 7º colocado do DeepSWE entre 28 modelos, contando o melhor resultado público de cada um. Com o Deep Think, o mesmo modelo de base passa ao 1º lugar.


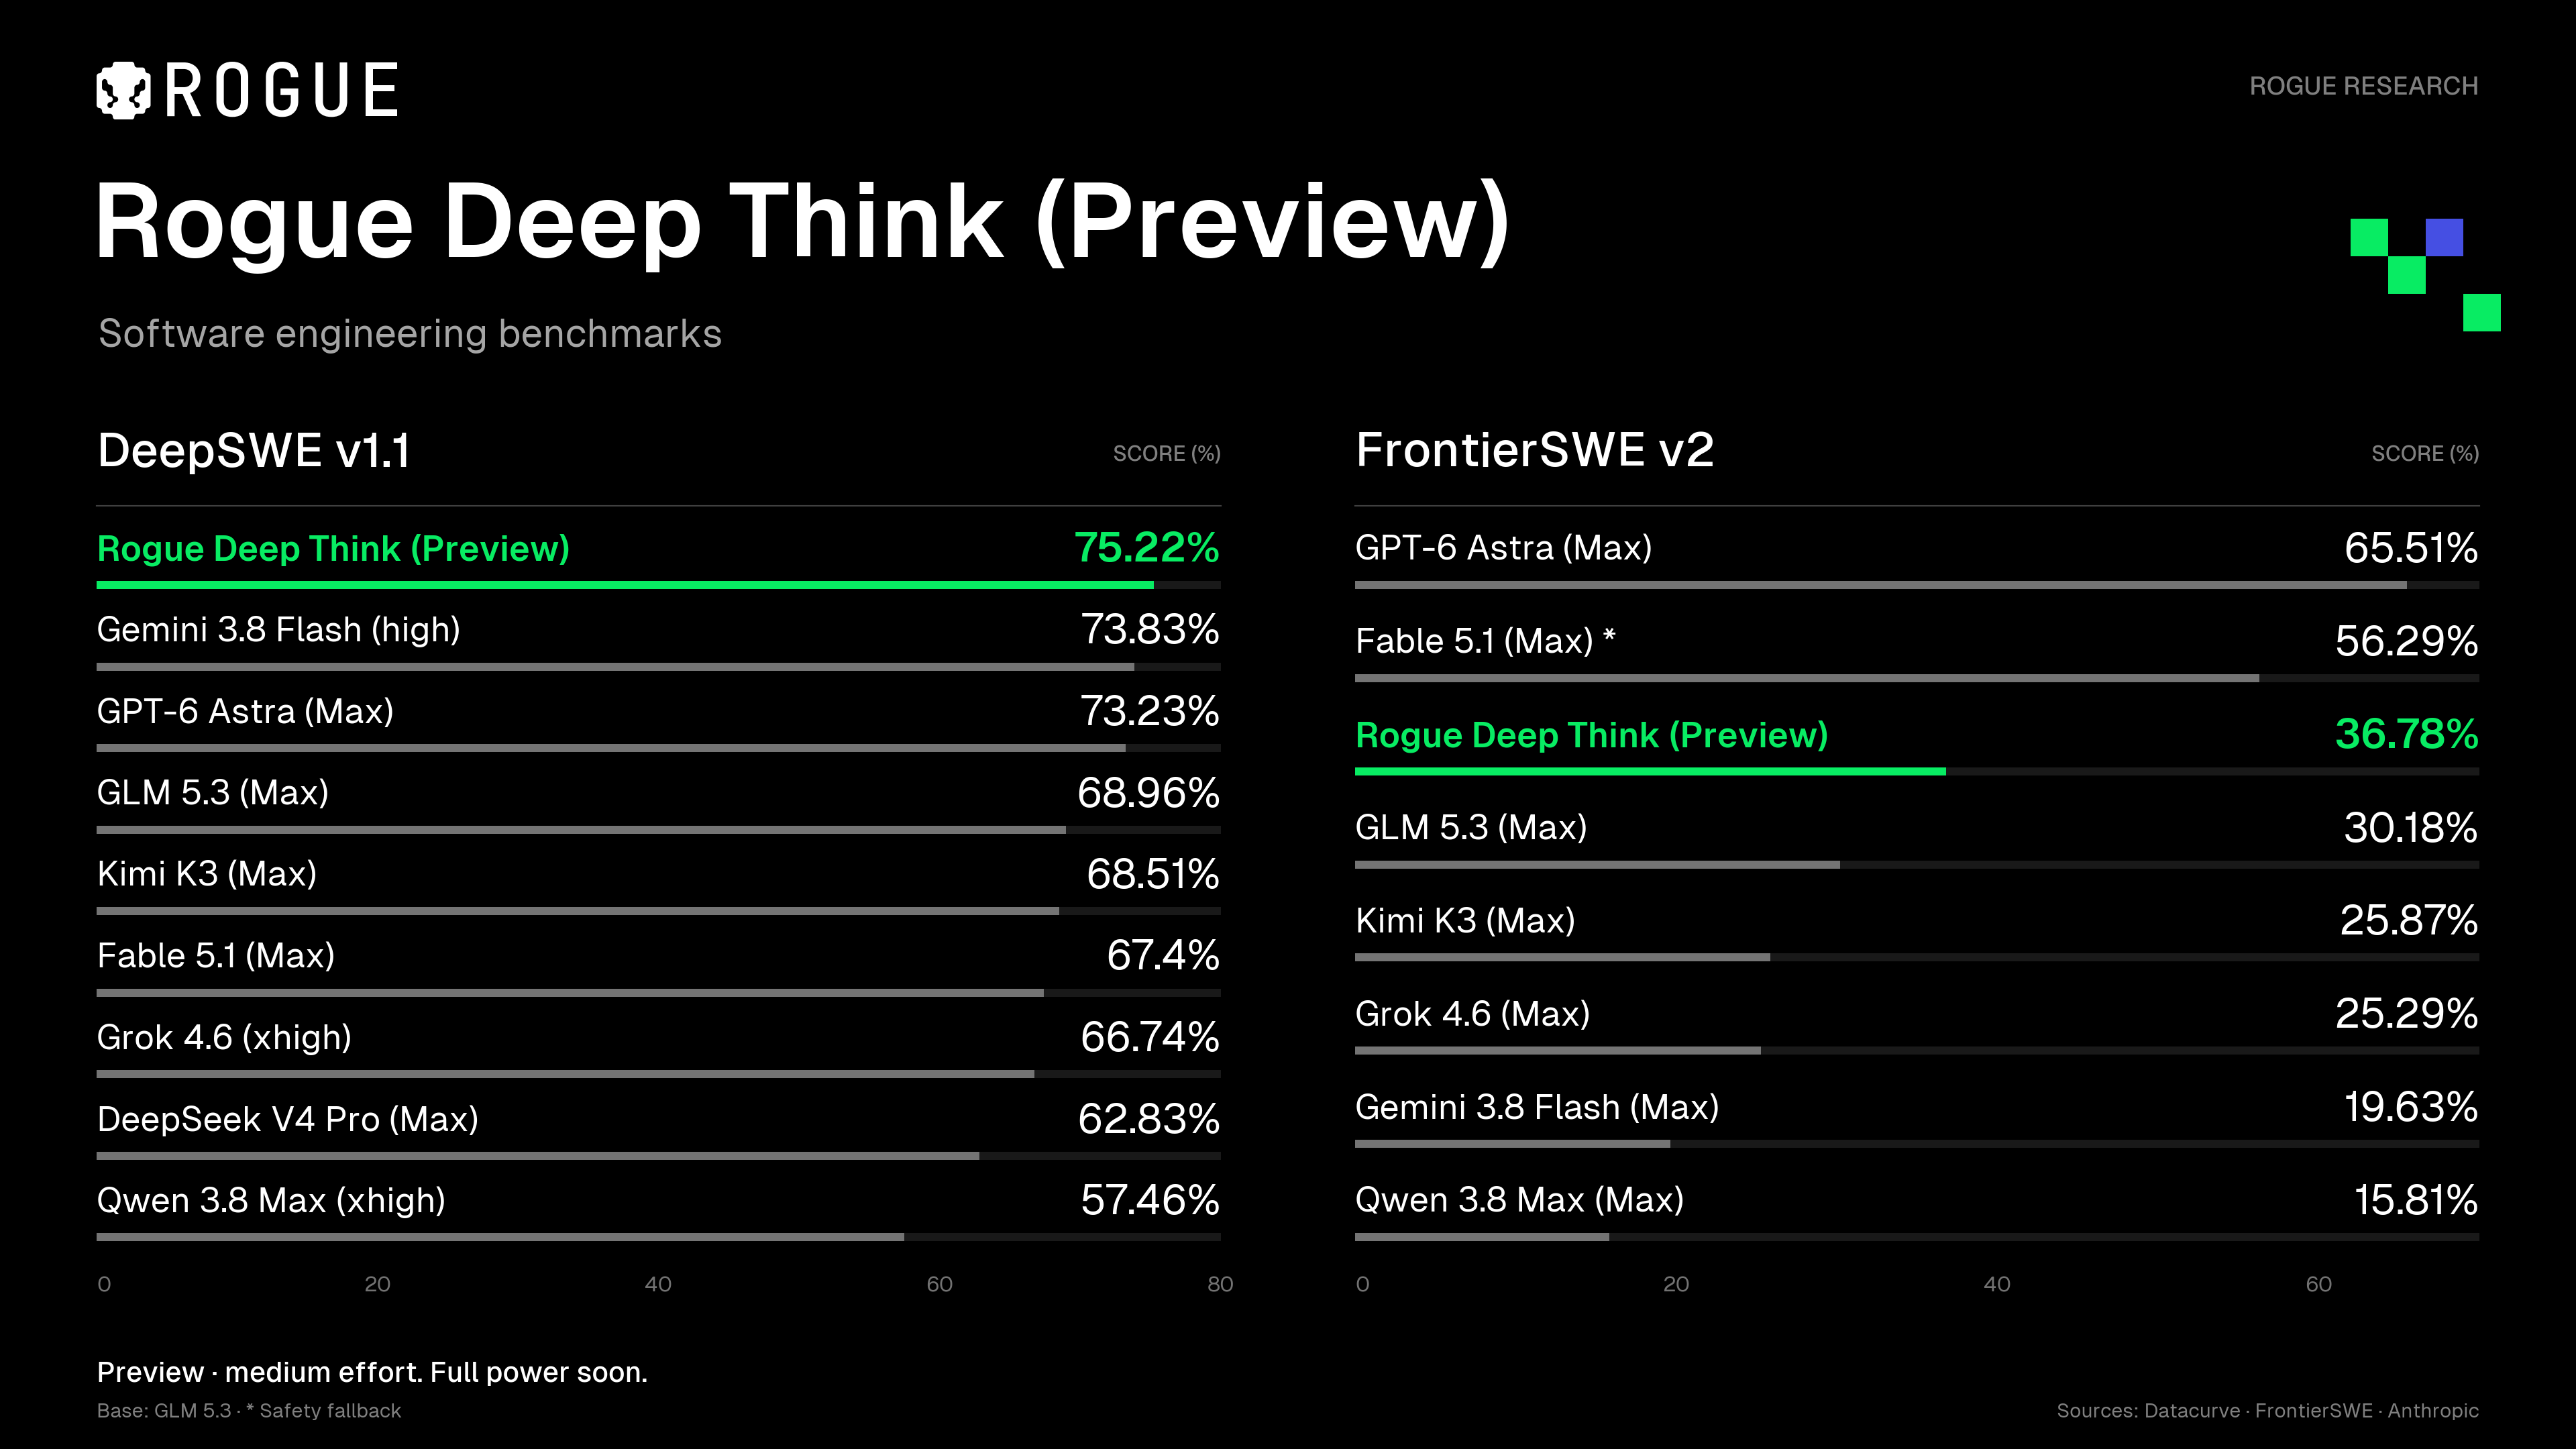
Para os comparativos abaixo, reunimos resultados públicos de modelos selecionados. Cada um aparece com o maior esforço medido nas fontes, mesmo quando um esforço menor pontua mais.
No DeepSWE v1.1, o Preview fica à frente de toda a seleção, incluindo Gemini 3.8 Flash (73,83%) e GPT-6 Astra (73,23% em Max). No FrontierSWE v2, fica atrás de GPT-6 Astra (65,51%) e Fable 5.1 (56,29%) e à frente do GLM 5.3, o modelo de base, que tem 30,18% no placar público. No placar completo do FrontierSWE, Opus 5 e Fable 5 também ficam à frente do Preview.


Ver os dados em tabela
| Model and effort | Score |
|---|---|
| Rogue Deep Think (Preview) | 75.22% |
| Gemini 3.8 Flash (high) | 73.83% |
| GPT-6 Astra (Max) | 73.23% |
| GLM 5.3 (Max) | 68.96% |
| Kimi K3 (Max) | 68.51% |
| Fable 5.1 (Max)* | 67.4% |
| Grok 4.6 (xhigh) | 66.74% |
| DeepSeek V4 Pro (Max) | 62.83% |
| Qwen 3.8 Max (xhigh) | 57.46% |
* Fable 5.1: resultado reportado pela Anthropic. Demais referências externas: Datacurve.
| Model and effort | Score |
|---|---|
| GPT-6 Astra (Max) | 65.51% |
| Fable 5.1 (Max)* | 56.29% |
| Rogue Deep Think (Preview) | 36.78% |
| GLM 5.3 (Max) | 30.18% |
| Kimi K3 (Max) | 25.87% |
| Grok 4.6 (Max) | 25.29% |
| Gemini 3.8 Flash (Max) | 19.63% |
| Qwen 3.8 Max (Max) | 15.81% |
Equivalência entre os protocolos interno e público ainda não estabelecida. * Fable 5.1 usa o Opus 5 nas tarefas bloqueadas por filtro de conteúdo. DeepSeek V4 Pro não tem resultado no FrontierSWE v2.
O que vem a seguir
Tudo o que está aqui foi medido em medium effort. A versão completa vem em breve, e vamos publicar os resultados dela quando estiverem medidos, com o mesmo cuidado de fontes deste texto.
O objetivo continua o mesmo: dar a quem constrói com a Rogue mais capacidade para investigar um problema difícil, chegar a uma solução que funciona e acompanhar o próprio trabalho.
Beyond Control. #GOROGUE
Contexto e fontes


Rogue: avaliações internas do Preview, baseado em GLM 5.3, em medium effort. As bases internas são 69,03% no DeepSWE e 30,18% no FrontierSWE. O GLM 5.3 público no DeepSWE, com 68,96%, é outra execução.
Os resultados públicos e os internos vêm de condições diferentes de harness, orçamento e número de execuções. O melhor resultado público do DeepSWE, 74,12% do GPT-6 Astra em xhigh, tem intervalo de 95% entre 71,25% e 76,98% no próprio placar, e os 75,22% do Preview caem dentro dele: a diferença não estabelece superioridade estatística. O DeepSWE reporta pass@1 em quatro execuções de 113 tarefas. O FrontierSWE reporta mean@5 em 34 tarefas, com esforço máximo e até 20 horas por tentativa; a equivalência com o nosso ensaio interno ainda não foi estabelecida. No FrontierSWE, Max indica o esforço máximo declarado pelo operador, sem supor um parâmetro de API específico.
Fable 5.1: no DeepSWE, resultado informado pela Anthropic no system card; no FrontierSWE, a avaliação usa o Opus 5 nas tarefas bloqueadas por filtro de conteúdo. O GPT-6 Astra entrou no placar do FrontierSWE em 11 de setembro de 2026. O DeepSeek V4 Pro não tem resultado no FrontierSWE v2. A seleção não inclui todas as entradas dos placares; os placares completos estão nas fontes abaixo, consultadas em 18 de setembro de 2026.
- DeepSWE · DatacurvePlacar público
- DeepSWE · MetodologiaComo as tarefas são feitas
- FrontierSWE v2 · PlacarPontuações públicas
- FrontierSWE v2 · MetodologiaProtocolo da avaliação
- FrontierSWE · ChangelogEntrada do GPT-6 Astra
- OpenAI · SWE-bench VerifiedPor que deixou de divulgar, fev. 2026
- OpenAI · SWE-bench ProAuditoria das tarefas, jul. 2026
- Fable 5.1 · System CardAnthropic · p. 168